
에이전트 기반 시뮬레이션
개별 행위자의 규칙과 상호작용에서 사회 현상이 나타나는 에이전트 기반 모델링을 셸링 모델로 이해하고, LLM 에이전트를 쓴 사회·경제 시뮬레이션 사례를 살펴본 뒤 두 LLM 에이전트로 반복 죄수의 딜레마를 실행한다.
- 에이전트 기반 모델링(Agent-Based Modeling, ABM): 자율적인 행위자 여럿의 행동 규칙과 상호작용을 정의하고, 이로부터 시스템 전체의 현상이 어떻게 나타나는지 탐구하는 시뮬레이션 방법.
- 하향식(top-down) 이론과 달리 상향식(bottom-up): 개인의 행동에서 집단의 현상을 끌어냄.
- 전통적인 ABM은 행동을 단순한 규칙으로 프로그래밍. LLM을 쓰면 행위자가 말로 된 상황을 읽고 사람처럼 판단.
- LLM으로 사람 흉내내기가 개인 하나를 흉내 냈다면, 여기서는 여러 에이전트의 상호작용을 봄.
ABM의 구성 요소와 창발성
- 행위자(agents): 사람, 기업, 차량 등. 자율성, 이질성(행위자마다 특성이 다름), 목표 지향성, 적응성, 제한된 합리성을 가짐.
- 환경(environment): 격자, 지도, 네트워크 등 행위자가 활동하는 공간. 상호작용(interactions): 행위자 간, 행위자와 환경 간.
- 창발성(emergence): 개별 행위자가 의도하지 않은 패턴이 시스템 수준에서 저절로 나타나는 현상. 예: 새 떼의 군집 비행, 교통 체증, 금융 시장의 거품.
- 장점: 서로 다른 개인들의 영향 분석, 현실에서 어려운 정책의 What-if 실험(예: 전염병 격리).
셸링의 분리 모델
- 규칙: 격자 위의 두 집단. 이웃 중 같은 집단의 비율이 기준보다 낮으면 빈 곳으로 이사.
- 결과: 다른 집단 이웃을 대부분 받아들여도(기준이 낮아도) 시간이 지나면 집단끼리 뭉친 큰 덩어리가 생김. 개인의 약한 선호가 강한 분리를 낳는 창발.
- 직접 해 보기: Schelling's Model of Segregation (Stanford Nifty)
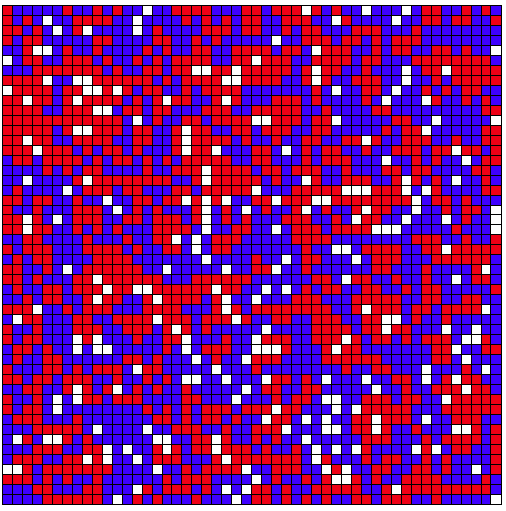
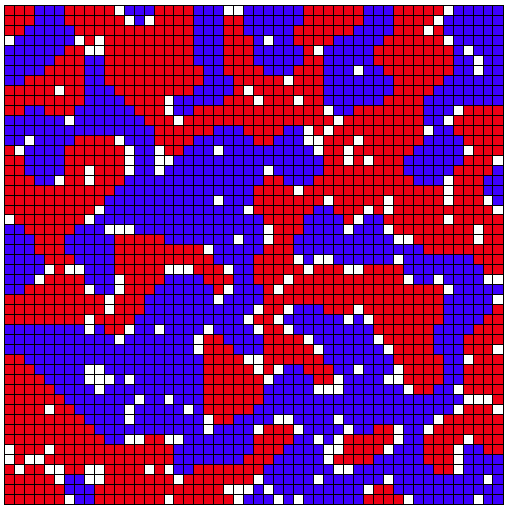
출처: Schelling(1971), Dynamic Models of Segregation, Journal of Mathematical Sociology
LLM을 적용한 ABM
Generative Agents
- 가상 마을 Smallville에 역할과 성격을 가진 에이전트 25명을 살게 함.
- 구조: 경험을 자연어로 쌓는 기억 흐름(memory stream), 최신성·중요성·관련성으로 기억 검색, 기억을 묶어 생각을 만드는 반성(reflection), 하루 계획(planning). 기억은 12주 기억과 망각 참고.
- 창발적 사회 행동: 발렌타인 파티 소식을 아는 에이전트가 이틀 동안 1명 → 13명으로 퍼지고, 초대받은 12명 중 5명이 실제로 파티에 옴.
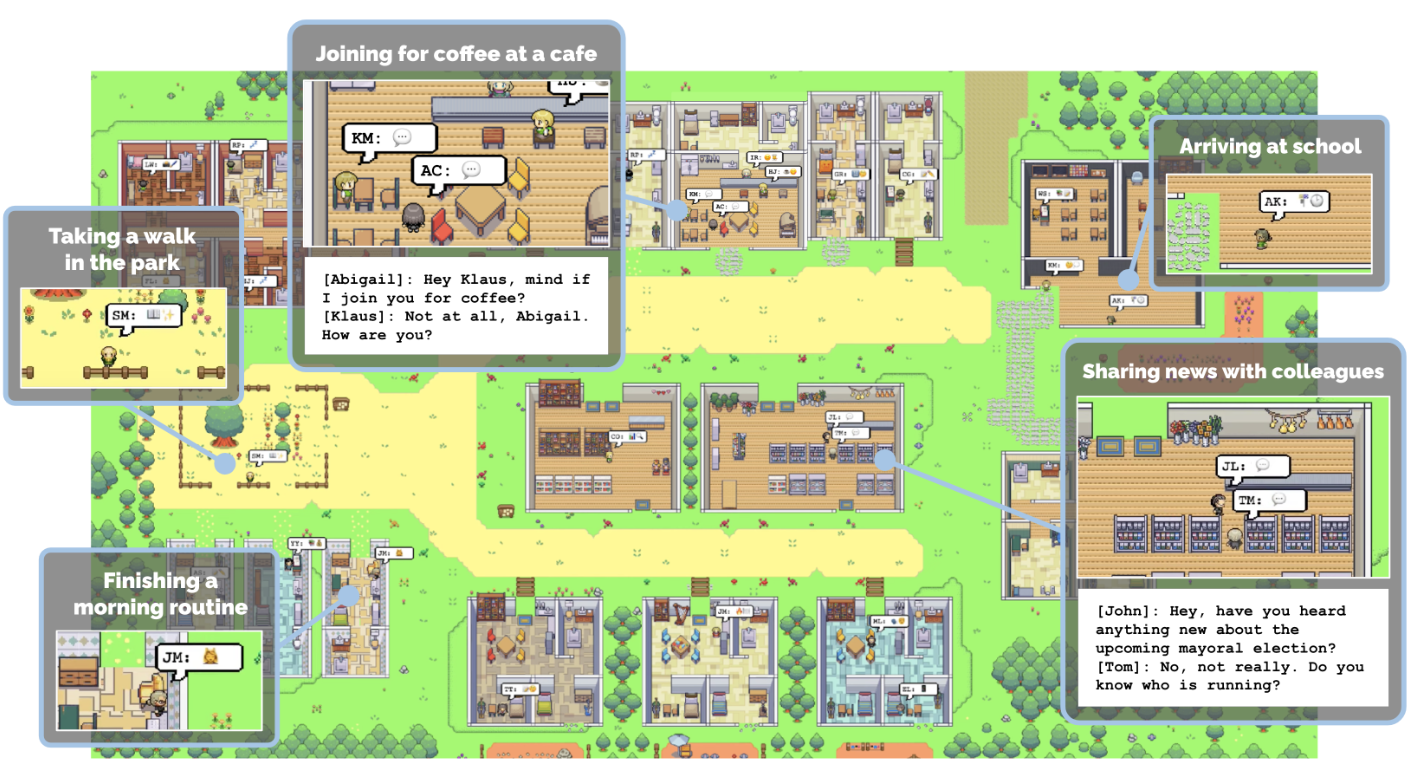
출처: Park 외(2023), Generative Agents: Interactive Simulacra of Human Behavior
그 밖의 사례
| 사례 | 내용 |
|---|---|
| 죄수의 딜레마 (Fontana 외 2024) | Llama2·GPT-3.5는 사람보다 협력적이고, 상대의 배신율이 낮으면 관대함(보복하지 않음) |
| EconAgent (Li 외 2023) | 에이전트 100명이 일·소비를 결정. 필립스 곡선, 오쿤의 법칙이 나타남 |
| Social Simulacra (Park 외 2022) | 커뮤니티 규칙과 페르소나로 가상 게시글을 채워 설계자가 예상 못 한 문제를 미리 발견 |
| WarAgent (Hua 외 2023) | 국가 역할 에이전트로 세계대전 시뮬레이션. 실제 역사를 그대로 꺼내 쓰지 않도록 국가명을 익명화(Germany → Country G) |
실습: LLM 에이전트의 반복 죄수의 딜레마
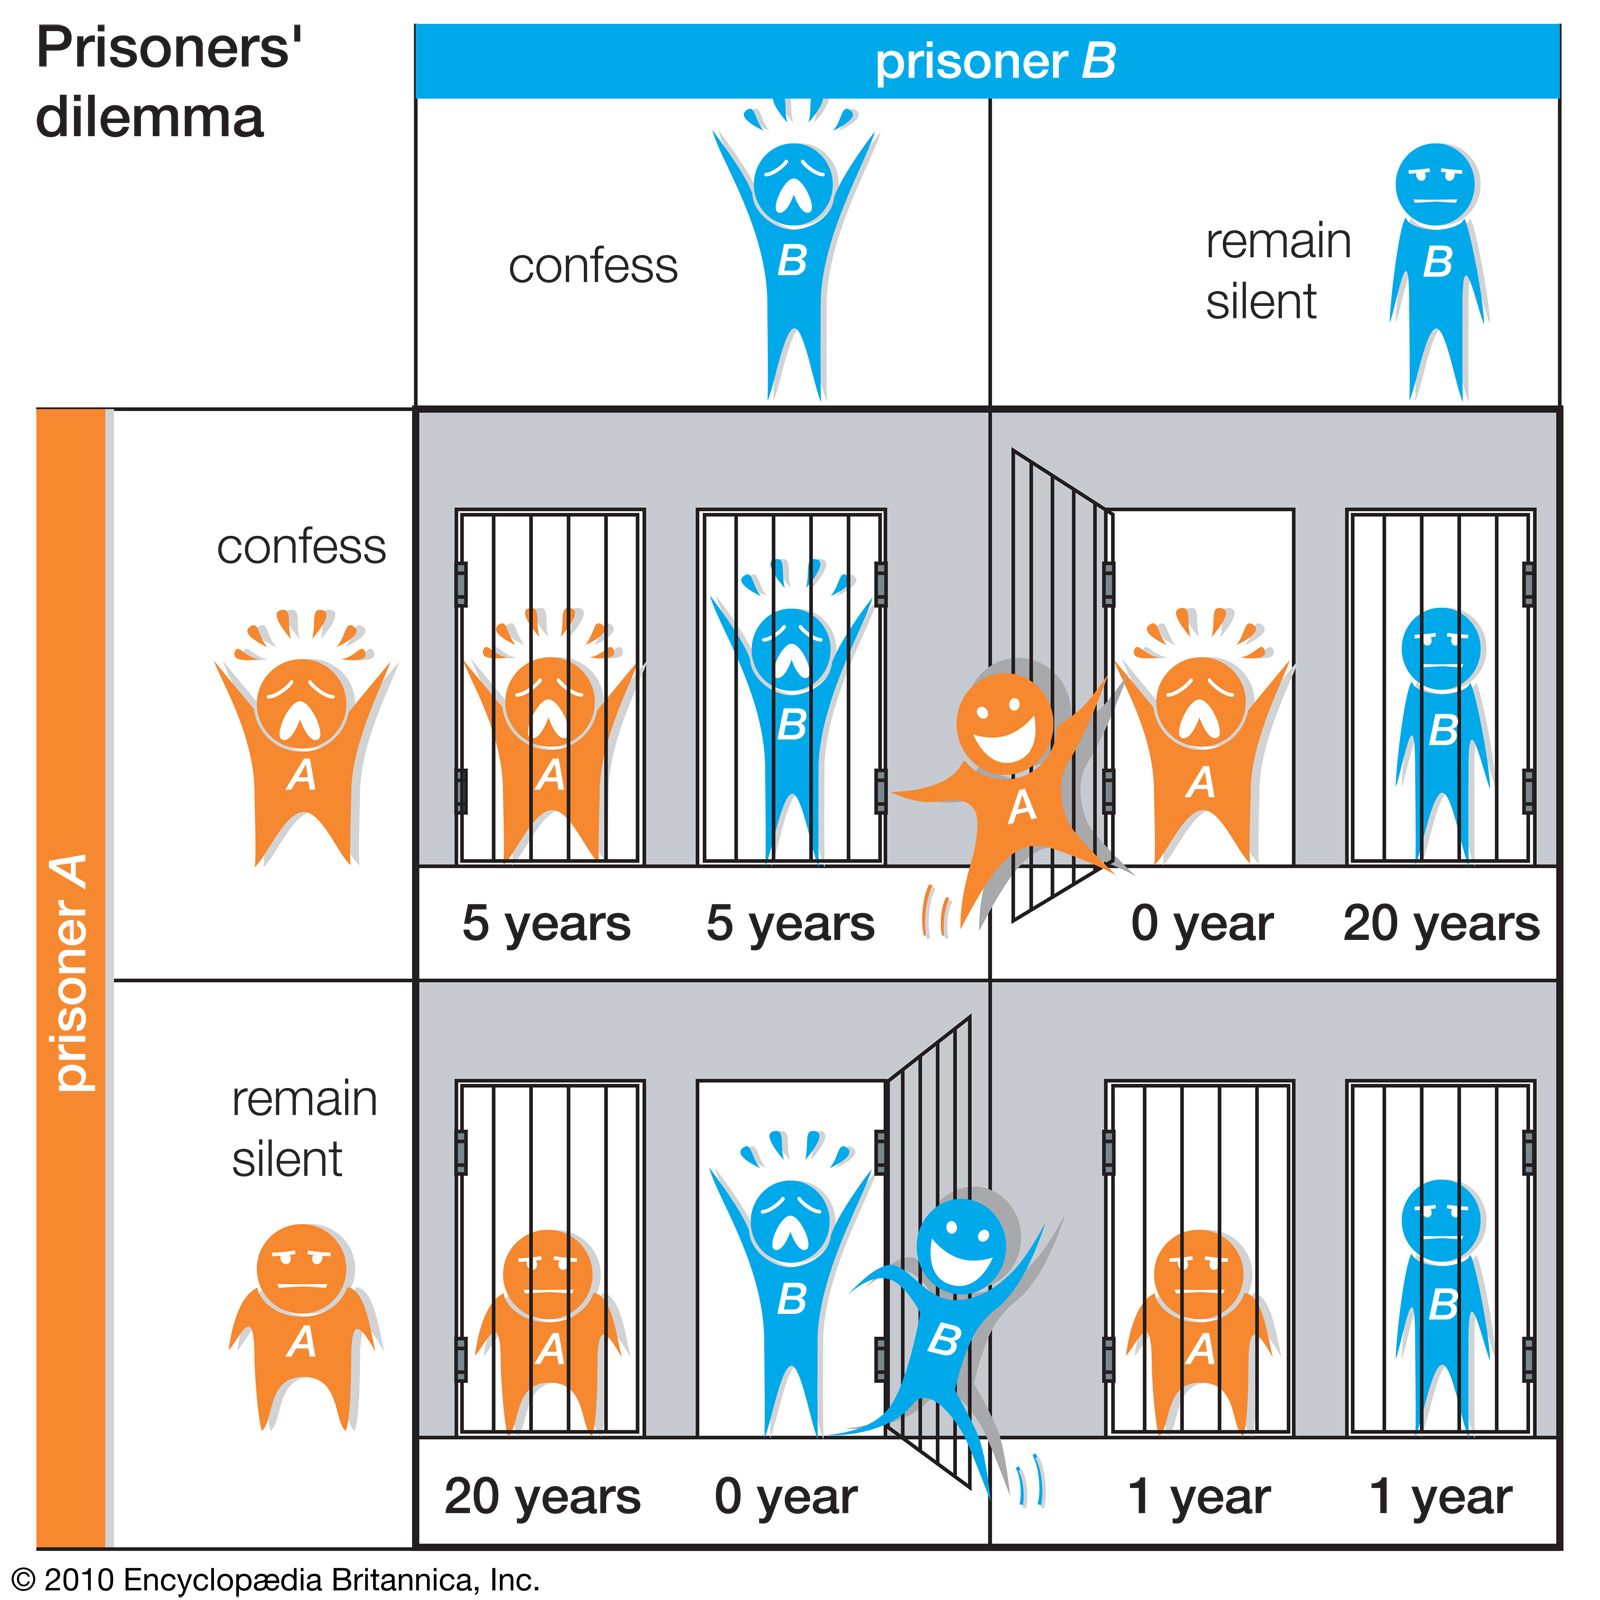
- 죄수의 딜레마: 둘 다 협력하면 둘 다 이득이 크지만, 상대가 어떻게 하든 나는 배신하는 편이 이득.
- 반복 죄수의 딜레마(Iterated Prisoner's Dilemma, IPD): 같은 상대와 여러 번 반복. 사람의 대표 전략은 기본은 협력하고 상대가 배신하면 다음 번에 응징한 뒤 다시 협력하는 맞대응(Tit-for-Tat), 한 번 배신당하면 다시는 협력하지 않는 Grim Trigger.
- 실험: LLM 대 LLM, LLM 대 항상 배신하는 규칙 행위자. 각 6라운드. 라운드 수는 알려 주지 않음(마지막 라운드 배신 방지). 각 행위자는 (내 행동, 상대 행동) 기록을 자기 관점으로 받음.
!pip install -q openai
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=Path("openrouter-key.txt").read_text().strip(),
)
model = "openai/gpt-4.1-mini"
from typing import Literal
from pydantic import BaseModel

PAYOFF = {("협력", "협력"): (3, 3), ("배신", "협력"): (5, 0), ("협력", "배신"): (0, 5), ("배신", "배신"): (1, 1)}
RULES = ("너는 같은 상대와 게임을 여러 라운드 반복한다(라운드 수는 모름). 매 라운드 '협력' 또는 '배신'을 동시에 고른다. "
         "점수(나, 상대): 둘 다 협력 3, 3 / 나만 배신 5, 0 / 나만 협력 0, 5 / 둘 다 배신 1, 1. 내 총점을 최대로 하라.")

class Move(BaseModel):
    action: Literal["협력", "배신"]

def llm_player(history):
    log = "\n".join(f"{i+1}라운드: 나 {m}, 상대 {o}" for i, (m, o) in enumerate(history))
    response = client.chat.completions.parse(model=model, response_format=Move, messages=[
        {"role": "system", "content": RULES},
        {"role": "user", "content": f"[지난 기록]\n{log or '없음'}"}])
    return response.choices[0].message.parsed.action

always_defect = lambda history: "배신"

def play(a, b, rounds=6):
    ha, hb = [], []
    for _ in range(rounds):
        x, y = a(ha), b(hb)
        ha.append((x, y)); hb.append((y, x))
    for name, i in [("A", 0), ("B", 1)]:
        print(name, " ".join(m[i] for m in ha), "| 총점", sum(PAYOFF[m][i] for m in ha))

play(llm_player, llm_player)
play(llm_player, always_defect)
실행 결과
A 협력 배신 배신 배신 협력 배신 | 총점 14
B 협력 배신 협력 배신 협력 배신 | 총점 9
A 협력 배신 배신 배신 협력 배신 | 총점 4
B 배신 배신 배신 배신 배신 배신 | 총점 14
- 위 실행(실행마다 달라짐)
- LLM 대 LLM: 1라운드는 둘 다 협력했지만 2라운드에 둘 다 배신. 이후 협력과 배신이 엇갈리다 5라운드에 다시 함께 협력. 매 라운드 동시에 고르므로 상대의 의도를 모른 채 엇갈림.
- LLM 대 항상 배신: 1라운드 협력 뒤 배신으로 돌아섰지만(보복) 5라운드에 다시 협력을 시도(관대함). Fontana 외(2024)의 관찰과 비슷하지만 표본 하나일 뿐.
생각해 볼 점
- 한 번의 대결은 표본 하나. 경향을 말하려면 여러 번 반복해 협력률의 분포를 봐야 함.
- 시뮬레이션 결과는 현실의 예측이 아니라 가정에 따른 가능성. LLM 에이전트의 행동 규칙은 프롬프트와 모델 안에 숨어 있음. 프롬프트를 바꾸면(예: "너는 냉정한 사업가다", 라운드 수 공개) 어떻게 달라질까?
- 같은 모델끼리의 대결은 같은 성향끼리의 대결. 다른 모델이나 프로필을 섞어 볼 것.
- 규칙만으로 셸링 모델을 직접 구현해 기준 비율에 따른 분리 정도를 측정해 볼 수도 있음.
퀴즈
에이전트 기반 모델링(ABM)의 핵심 접근은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.