Q-학습: 항구 입항 실습
항구 입항 격자 세계
- 배가 출항지에서 출발해 암초를 피해 항구로 들어가는 문제
- 바다를 6×8칸 격자로 나누고, 배는 한 번에 한 칸씩 이동
- 상태: 배가 있는 칸(48개)
- 행동: 왼쪽, 아래, 오른쪽, 위(4개)
- 보상: 항구에 들어가면 +1, 암초에 부딪히면 0으로 끝
- 바람(wind): 배가 의도한 방향과 다르게 옆으로 밀릴 확률
wind=0.2: 80%는 의도한 방향, 10%씩 왼쪽 또는 오른쪽으로 밀림
- 행위자는 지도를 모르는 상태에서 시작해 항해를 반복하며 칸마다의 가치를 학습
실습 준비
Colab에서 파일을 바로 내려받으려면 다음 셀 실행.
!wget -q -O ship_rl.py "https://www.mindscale.kr/content-assets/8b2255ca7d6bdd3539d6f55c2c56e18de17473574e16c48ab46bfdc5fe1d9cbc/ship_rl.py"
- 필요한 패키지 설치
!pip install gymnasium matplotlib numpy
바다 지도
from ship_rl import HarborEnv, plot_map

env = HarborEnv(wind=0.0)  # 바람이 없는 바다
plot_map(env)
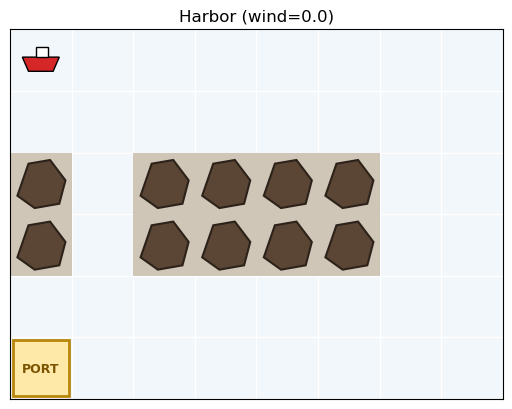
- 왼쪽 위 빨간 배: 출항지
- 왼쪽 아래 PORT: 항구
- 가운데 암초 지대를 지나는 두 가지 항로
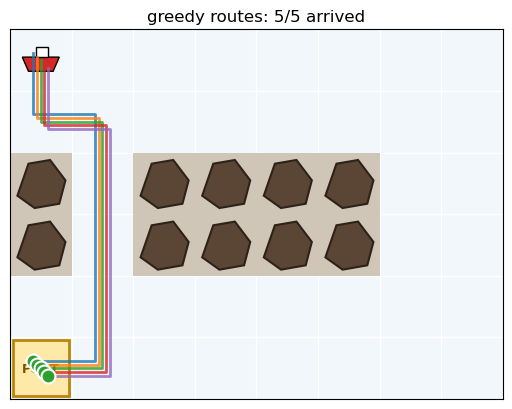
- 지름길: 왼쪽의 좁은 수로(한 칸 폭)를 통과, 약 7번 이동
- 우회로: 오른쪽 넓은 바다로 돌아감, 약 19번 이동
무작위 항해
- 학습 전 비교 기준으로, 행동을 무작위로 골라 5번 항해
from ship_rl import plot_routes

plot_routes(env)  # Q를 주지 않으면 무작위 항해
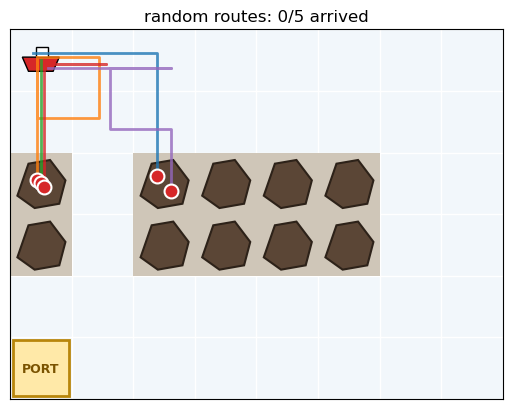
- 선: 배가 지나간 경로
- 끝점: 초록 원은 입항, 빨간 원은 좌초 또는 시간 초과(100번 이동)
- 무작위로 움직이면 대부분 출항지 근처 암초에 부딪힘
from ship_rl import success_rate

success_rate(env)  # 1000번 항해 중 입항한 비율
실행 결과
0.0
Q 학습
- 행동 가치 Q(s, a): 칸 s에서 행동 a를 한 뒤 계속 잘 항해했을 때 기대되는 수익
- Q 학습: 한 번 이동할 때마다 Q를 조금씩 고침
- 새 추정치 = 받은 보상 + γ × 다음 칸에서 가장 좋은 행동의 가치
- 기존 값과 새 추정치의 차이 중 α(학습률)만큼만 반영
- 칸의 가치 V(s): 그 칸에서 가장 좋은 행동의 가치, max Q(s, ·)
- 행동 선택: 입실론 탐욕법
- 90%는 지금까지 가치가 가장 큰 행동(활용)
- 10%는 무작위 행동(탐색)
from ship_rl import q_learning

history = q_learning(env, episodes=1000)  # 항해 횟수 1000번
history: 학습이 끝난 Q와 학습 중간중간의 Q 기록, 항해별 입항 여부
가치가 퍼져 나가는 과정
from ship_rl import animate

animate(env, history)  # 10번 항해마다 한 장씩 학습 과정을 넘겨 보기
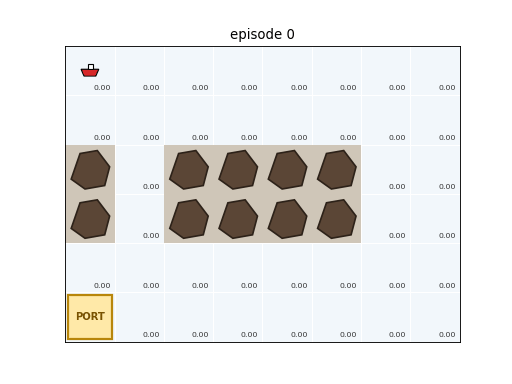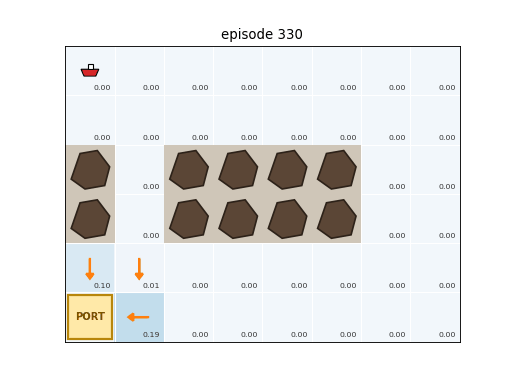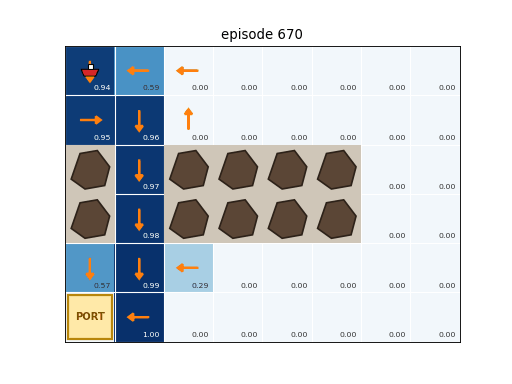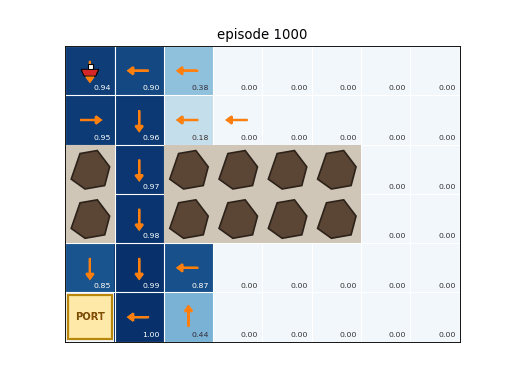
- 슬라이더나 재생 버튼으로 학습 과정을 넘겨 보기
- 색: 칸의 가치 V(s), 진할수록 높음
- 주황 화살표: 그 칸에서 가치가 가장 큰 행동
- 0번째: 아는 것이 없어 모든 칸의 가치가 0
- 200번째: 우연히 항구에 들어간 경험으로 항구 바로 옆 칸부터 가치가 생김
- 300-400번째: 항구 옆 칸의 가치가 그 앞 칸으로 전해지며 수로를 따라 거슬러 올라감
- 500번째: 출항지까지 가치가 이어지면서 지름길 항로 완성
- 1000번째: 지름길 주변 칸의 가치는 1에 가깝고, 가 볼 일이 없는 오른쪽 바다는 여전히 0
- 보상은 항구에서만 받지만, 한 칸씩 거슬러 전해지며 먼 칸도 가치를 가짐(벨만 방정식)
학습 곡선
from ship_rl import plot_curve

plot_curve(history)  # 최근 100번 항해의 입항 성공률
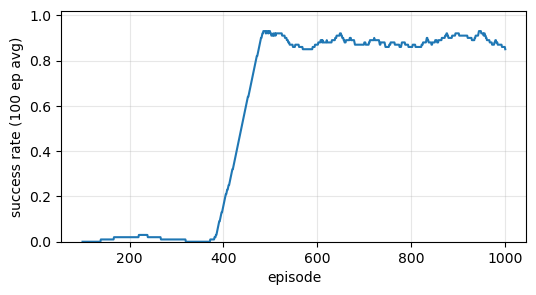
- 처음 400번 정도는 거의 입항하지 못함
- 가치가 출항지까지 이어지는 순간 성공률이 급격히 오름
- 1이 아니라 0.9 근처에 머무는 이유: 학습 중에는 10%의 무작위 행동 때문에 가끔 좌초
학습된 항로
plot_routes(env, history.Q) # 가치가 가장 큰 행동만 골라 항해
success_rate(env, history.Q)
실행 결과
1.0
- 학습이 끝난 뒤 무작위 행동 없이 항해하면 매번 지름길로 입항
바람이 부는 바다
- 같은 항로를 바람이 부는 바다(
wind=0.2)에서 따라가 봄
windy = HarborEnv(wind=0.2)
plot_routes(windy, history.Q)  # 바람 없는 바다에서 배운 항로
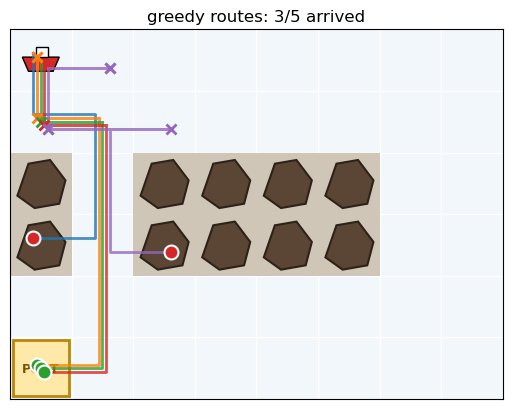
- ×: 바람에 밀린 지점
- 수로 안에서 옆으로 밀리면 바로 암초에 부딪힘
success_rate(windy, history.Q)
실행 결과
0.522
- 바람이 없는 바다에서 배운 정책은 바람이 부는 바다에서 절반 가까이 좌초
바람이 부는 바다에서 다시 학습
windy_history = q_learning(windy)  # 기본 설정으로 다시 학습
animate(windy, windy_history)
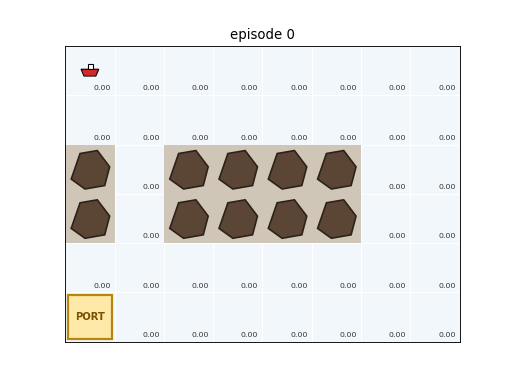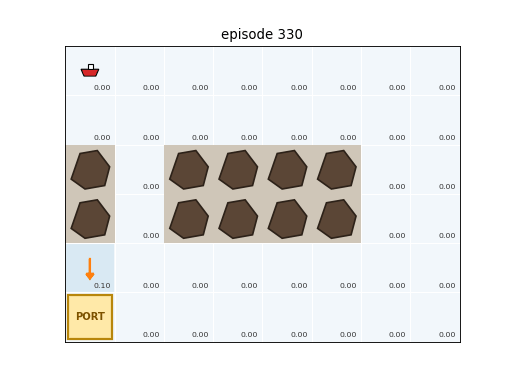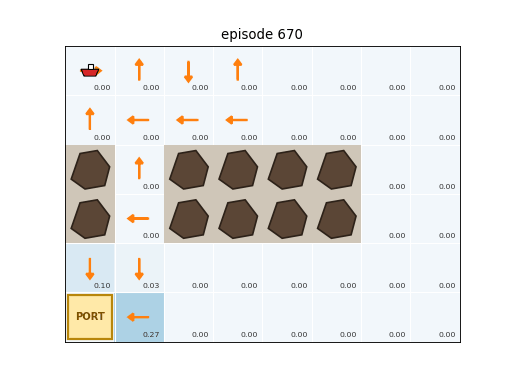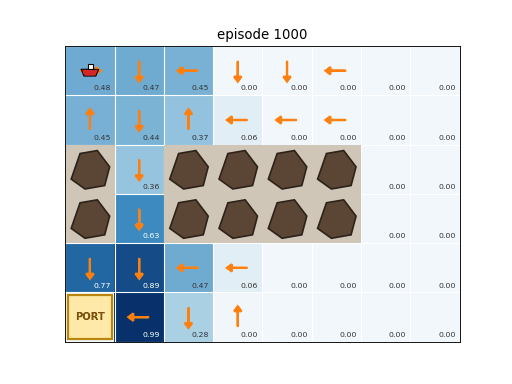
- 바람이 없을 때보다 가치가 느리게 퍼짐: 수로에서 자주 좌초해 입항 경험이 드묾
- 900번째 무렵에야 출항지까지 가치가 이어지고, 1000번째에도 출항지의 가치는 0.5 정도
- 오른쪽 바다는 끝까지 가치가 0
plot_curve(windy_history)
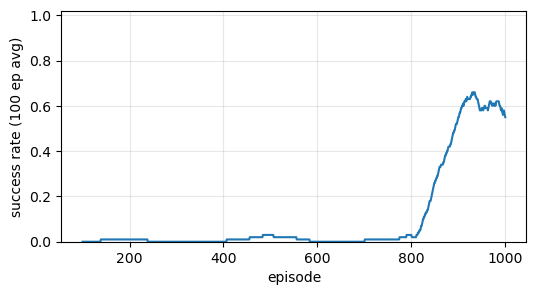
- 800번째 항해까지 거의 입항하지 못함: 바람이 없을 때(400번째)보다 두 배 늦음
- 그 뒤에도 성공률이 0.6 근처에 머묾: 수로에서 바람에 밀려 자주 좌초
plot_routes(windy, windy_history.Q)
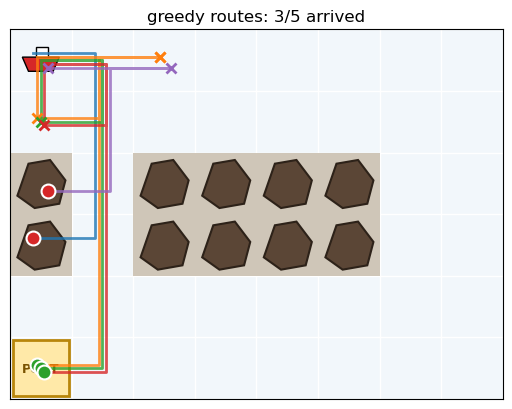
success_rate(windy, windy_history.Q)
실행 결과
0.608
- 바람이 부는 바다에서 학습해도 여전히 지름길을 고집함
- 오른쪽 우회로가 더 안전한지 아닌지 알려면 그쪽으로 가 봐야 함
- 지름길로 가끔이라도 입항하면 그 가치가 0보다 커져 계속 지름길을 선택
- 오른쪽 바다는 가 본 적이 없어 가치가 0에 머묾
- 10%의 무작위 행동으로는 출항지에서 오른쪽 끝까지 20칸 가까이 가기 어려움
- 활용만 하면 처음 찾은 그럭저럭 괜찮은 행동에 갇히는 사례
낙관적 초기값
- 학습 시작 때 모든 행동 가치를 0이 아니라 1(가장 좋은 경우)로 둠
- 가 보지 않은 칸은 "좋을지도 모른다"고 기대
- 가 본 칸은 실제 경험에 따라 가치가 내려감
- 그 결과 아직 가 보지 않은 칸을 일부러 찾아가게 됨
optimistic_history = q_learning(windy, q_init=1.0)  # 처음 가치를 1로 시작
animate(windy, optimistic_history)
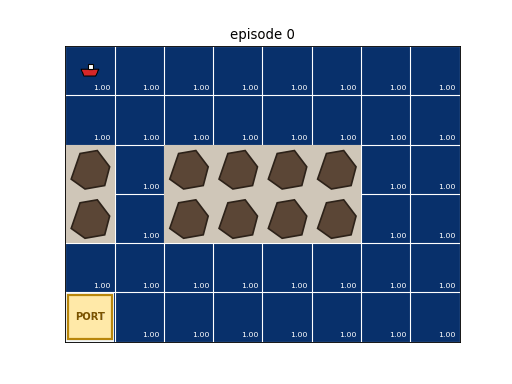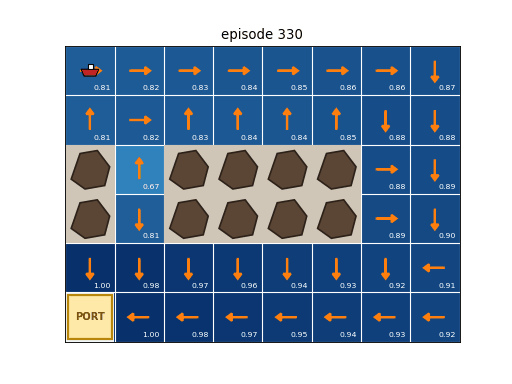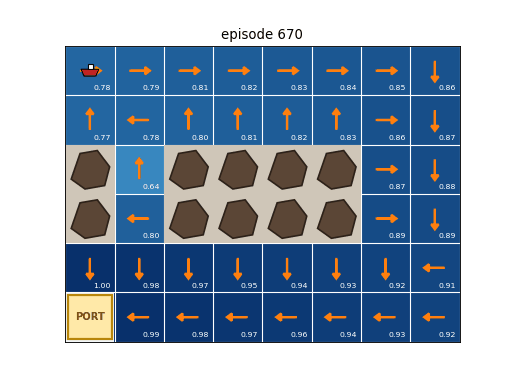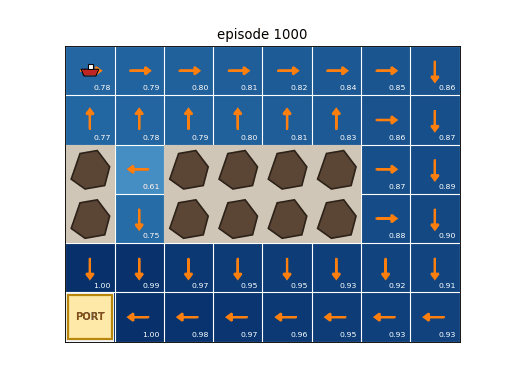
- 0번째: 모든 칸의 가치가 1
- 100-200번째: 여러 방향을 시도하며 가치가 실제 수준으로 내려가는 중
- 300번째 이후: 수로 칸의 가치(0.6-0.7)가 주변보다 낮아지고, 출항지의 화살표가 오른쪽을 가리킴
- 기본 설정과 달리 오른쪽 바다까지 모든 칸의 가치가 채워짐
plot_curve(optimistic_history)
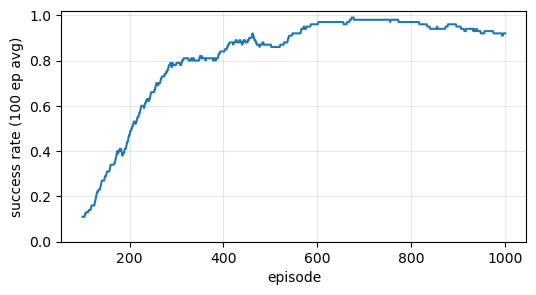
- 처음부터 성공률이 꾸준히 오름: 가 보지 않은 곳을 찾아다니며 일찍부터 입항 경험을 쌓음
- 600번째 무렵부터 0.95 안팎을 유지: 무작위 행동을 해도 넓은 바다에서는 좌초가 드묾
plot_routes(windy, optimistic_history.Q)
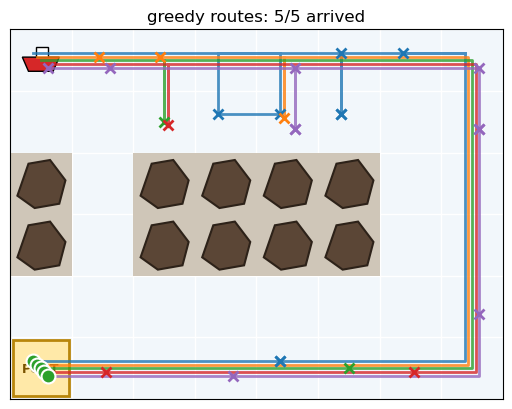
success_rate(windy, optimistic_history.Q)
실행 결과
1.0
- 바람에 여러 번 밀려도 넓은 바다에서는 다시 항로로 돌아올 수 있어 매번 입항
정리
| 상황 | 학습 결과 | 입항 성공률 |
|---|---|---|
| 바람 없음 | 지름길 | 1.00 |
| 바람 없음에서 배운 항로를 바람 0.2에서 사용 | 지름길 | 0.52 |
| 바람 0.2, 기본 설정 | 지름길에 갇힘 | 0.61 |
| 바람 0.2, 낙관적 초기값 | 우회로 | 1.00 |
- 가치는 보상을 받는 곳에서 시작해 한 칸씩 거슬러 퍼져 나감
- 같은 지도라도 환경의 불확실성(바람)에 따라 최적 정책이 달라짐
- 좋은 정책을 찾으려면 학습한 가치를 활용하는 것만큼 가 보지 않은 곳을 탐색하는 것이 중요
퀴즈
항구에 들어갈 때만 보상을 받는데도 출항지 칸까지 가치가 생기는 이유로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.