강화학습의 어려움
강화학습의 어려움
- 느린 학습 속도, 높은 계산 비용, 낮은 성능
- 보상 함수를 결정하기 어려움
- 국소최적과 과적합
- 불안정성과 재현의 어려움
- 물리적 적용이 어려움
- 배경 지식 없이 무작위적 시행착오
느린 학습 속도, 높은 계산 비용, 낮은 성능
- 느린 학습 속도와 높은 계산 비용
- 컴퓨터 게임에서 인간이 몇 분 정도면 하면 낼 수 있는 실력에 강화학습으로 도달하려면 게임을 수 십 시간 분량해야 (+ 학습 시간)
- 가상의 환경에서 로봇의 달리기 동작을 학습하는데 CPU 64개로 100 시간 분량의 계산이 필요
- 알파고 제로 (2017)의 하드웨어 가격은 2천5백만 달러로 추정
- 특화된 방법에 미치지 못하는 성능
- 강화학습은 다양한 종류의 문제에 적용할 수 있는 일반적 방법론
- 특정 문제에 특화된 방법론에 성능이 못 미치는 경우가 많이 있음
보상 함수를 결정하기 어려움
- 강화학습의 행위자는 사람이 의도한 목적이 아니라 실제로 정의된 보상을 최대화하도록 학습
- 측정의 어려움: 챗봇의 목표를 사용자 만족으로 정해도 만족도를 보상으로 측정하기 어려움
- 보상 해킹(reward hacking): 측정하기 쉬운 대리 지표의 보상은 높지만 본래 과제는 달성하지 못하는 행동
- CoastRunners 사례: 경주를 완주하지 않고 표적을 반복해서 맞혀 높은 점수를 획득
- 고전 게임 자동 플레이 사례: 테트리스에서 패배를 피하기 위해 게임을 일시 정지
- 로봇의 블록 잡기와 쌓기 사례: 중간 보상을 얻는 잡기 동작이 쌓기에는 부적합하거나, 잘못 지정한 기준점 때문에 블록을 뒤집는 행동이 발생
- 검증 기준: 보상과 별도로 완료 조건, 충돌, 안전 제약, 실제 환경의 성공 여부 확인
- 핵심: 보상 함수와 평가 기준을 함께 설계
국소 최적과 과적합
- 국소 최적
- 강화 학습에서 한 행동의 수익은 이어지는 다른 행동들에 영향을 받음
- 국소 최적인 정책에 빠질 경우 빠져 나오기가 쉽지 않음
- 특정한 종류의 환경에 과적합
- 딥러닝에서 컴퓨터 비전, 자연어 처리 등은 전이 학습에서 큰 성과
- 대량의 데이터로 사전 학습 후 다양한 종류의 과제에 미세 조정을 하여 사용
- 강화 학습의 경우 특정한 종류의 환경에 과적합되는 경향, 전이 학습이 어려움
불안정성과 재현의 어려움
- 강화 학습은 다른 종류의 학습에 비해 학습이 불안정
- 강화 학습에서 한 행동의 수익은 다른 행동들과 복잡하게 연관
- 동일한 상태에서 동일한 행동을 하더라도, 다른 상태에서 행동이 바뀌면 가치가 달라짐
- 동일한 알고리즘으로 동일한 환경에서 학습을 해도 똑같은 결과를 내기가 어려움
물리적 적용이 어려움
- 강화학습은 수많은 시행착오를 전제로 함
- 게임 등 가상적인 환경에서는 시행착오를 하더라도 실패에 따른 부담이 없음
- 물리적 환경에서는 시행착오에 많은 시간과 비용이 들고, 실패의 부담이 큼
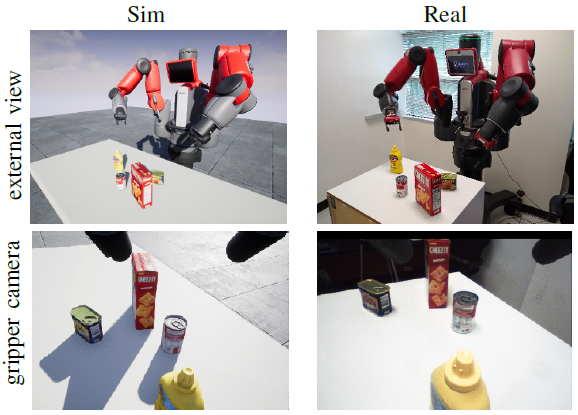
- 가상 환경에서 시행 착오를 한 후, 물리적 환경에 적용할 경우 환경 간의 차이로 인해 적용이 어려움(Sim-to-Real)
배경 지식 없이 무작위적 시행착오
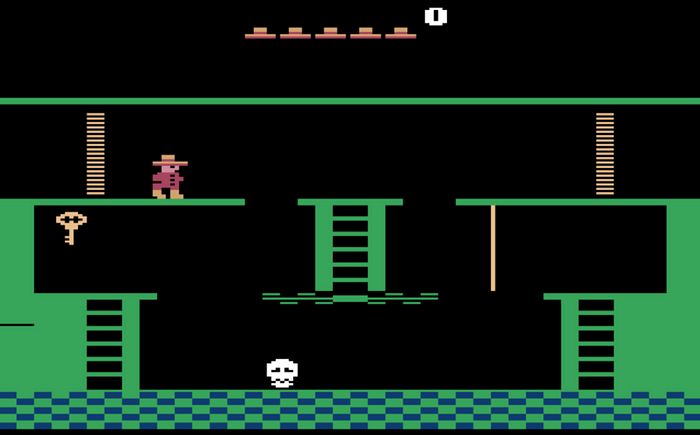
- Atari 게임 "Montezuma's Revenge" → 보상이 드물어 학습이 어려움
- 첫 번째 방의 경우 첫 번째 방에서 첫 번째 열쇠를 얻기 위해 멀리 움직여야 함
- 게임의 실패 조건이 매우 엄격
- 사람의 경우 화면상의 요소(열쇠, 두개골, 사다리 등)으로부터 해야 할 행동을 추론할 수 있음 → 사전 지식을 제거하면 훨씬 어려워짐
강화학습 적용이 효과적인 문제의 특성
- 많은 경험을 생성하기가 쉬움(예: 바둑, 컴퓨터 게임, 시뮬레이션 등)
- 문제를 더 단순한 문제로 바꾸기 쉬움
- (강화학습 행위자들 간의 대결 형식의) 셀프 플레이가 가능함
- 보상을 정의하는 직관적인 방법이 있음(예: 이기면 +1, 지면 -1)
- 행동에 대한 피드백이 빠르고 많이 주어짐
퀴즈
강화학습으로 컴퓨터 게임 실력을 학습할 때 느린 학습 속도의 예로 가장 알맞은 설명은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.