강화학습의 역사
강화학습의 뿌리
- 형성 과정: 여러 연구 흐름의 결합을 통해 발전한 분야
- 학습 심리학: 시행착오와 보상·처벌을 통한 행동 변화에서 가져온 강화의 개념
- 인공지능(Artificial Intelligence, AI): 경험을 이용해 더 나은 행동을 찾는 행위자 연구
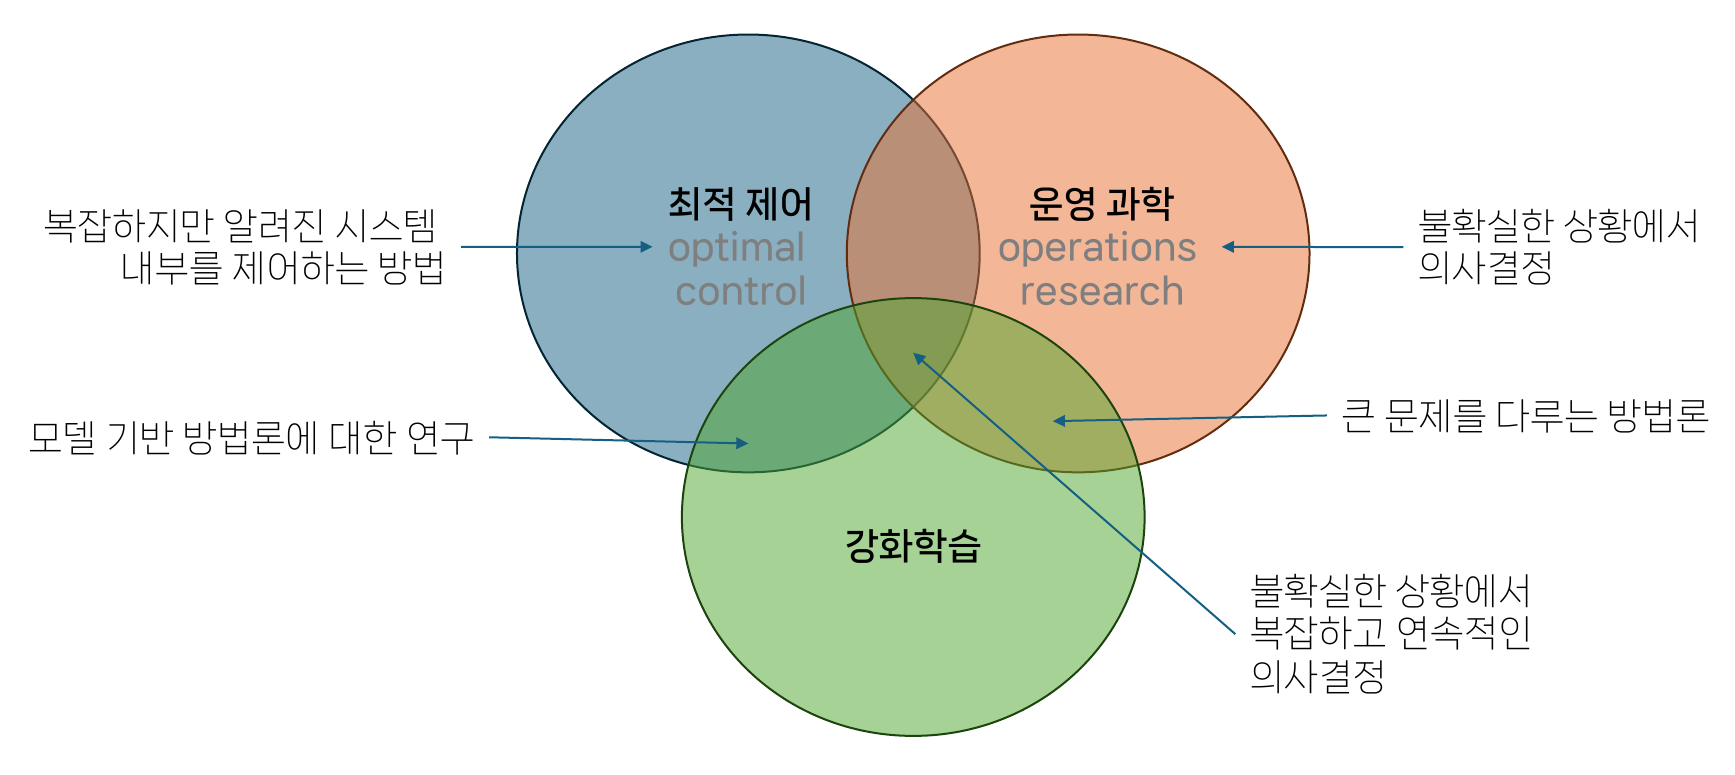
- 최적 제어(optimal control): 알려진 시스템의 상태를 목표에 맞게 제어하는 수학적 방법
- 운영 과학(operations research): 불확실한 상황에서 자원을 배분하고 순차적으로 의사결정하는 방법
-
최적 제어: 복잡하지만 동작 원리를 아는 시스템의 내부 제어
-
운영 과학: 불확실성을 포함한 의사결정과 자원 배분
-
강화학습: 경험을 이용한 정책 학습
-
교차 영역: 불확실하고 복잡한 환경에서 이어지는 연속적 의사결정
-
통합의 중심: 예측, 제어, 시행착오 학습을 연결한 시간차 학습
주요 전환점
1950년대–1970년대: 수학적 기반
- 1957년: 리처드 벨먼이 마르코프 결정 과정(Markov Decision Process, MDP)과 동적 계획법(dynamic programming)을 체계화
- 벨만 방정식: 여러 단계의 의사결정 문제를 현재 보상과 다음 상태의 가치로 분해
- 연구 초점: 전이 확률과 보상 구조를 아는 환경에서 최적 정책 계산
- 한계: 큰 상태 공간의 계산 비용과 정확한 환경 모형에 대한 의존
1980년대–1990년대: 경험을 통한 학습
- 1988년: 리처드 서튼이 시간차(Temporal-Difference, TD) 학습을 체계화
- 최종 결과를 기다리지 않고 연속된 두 예측의 차이로 가치 갱신
- 1989년: 크리스 왓킨스가 환경 모형 없이 최적 행동 가치를 학습하는 (Q)-학습 제안
- 1990년대: TD-Gammon이 신경망, 시간차 학습, 셀프 플레이를 결합해 백개먼에서 높은 성능 달성
- 의미: 동적 계획법의 가치 갱신 원리를 실제 경험에서 수행하는 모형 없는 학습(model-free learning)의 확립
2010년대: 심층 강화학습
- 2013년: 심층 Q 신경망(Deep Q-Network, DQN) 연구 공개
- 게임 화면의 픽셀에서 행동 가치를 직접 학습
- 2015년: 49개 아타리 게임으로 확장한 DQN 결과 발표
- 2016년: AlphaGo가 지도학습, 셀프 플레이 강화학습, 정책망, 가치망, 몬테카를로 트리 탐색을 결합해 이세돌 9단과의 대국에서 승리
- 의미: 사람이 설계한 저차원 상태를 넘어 고차원 감각 입력과 복잡한 탐색 문제로 확장
2020년대: 보상 신호와 적용 범위의 확장
-
인간 피드백을 이용한 강화학습(Reinforcement Learning from Human Feedback, RLHF): 사람의 선호를 보상 모델로 학습한 뒤 언어 모델의 정책을 조정하는 방법
-
적용 범위: 언어 모델 정렬, 다중 행위자, 로봇 제어, 과학·공학 시스템
-
연구 방향: 더 적은 경험으로 학습하는 방법, 안전한 탐색, 실제 환경으로의 전이, 보상과 인간 의도의 정렬
-
핵심 변화: 게임 점수와 센서값에서 사람의 비교 판단까지 넓어진 보상의 형태
현대 연구에서의 위치
-
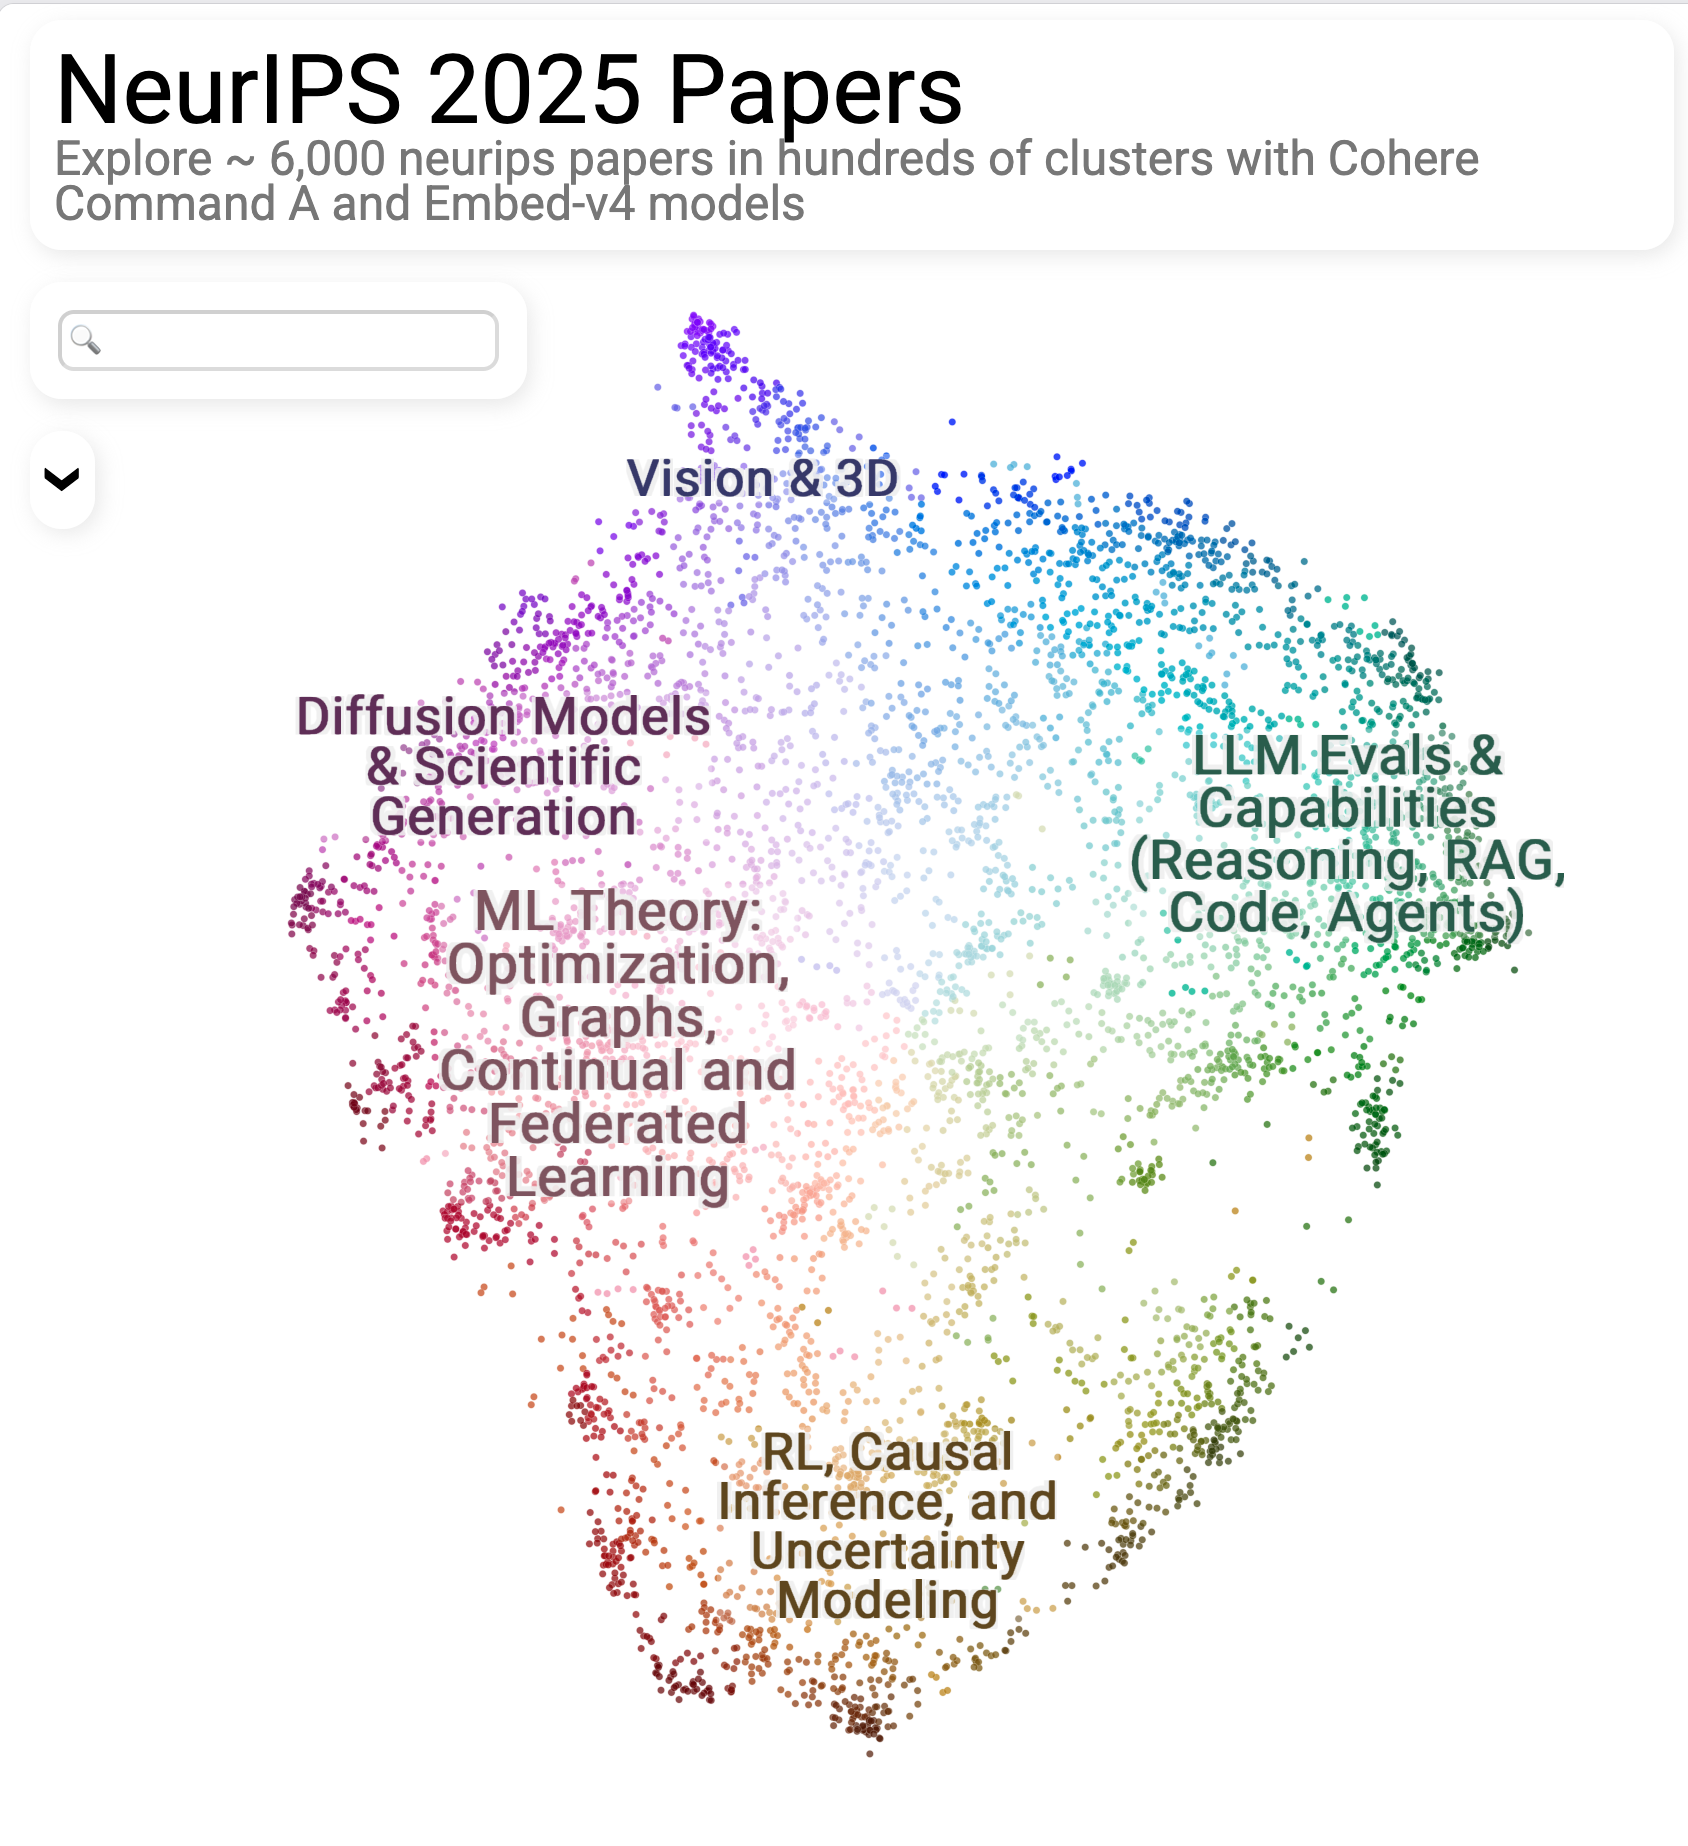
각 점: 하나의 NeurIPS 2025 논문
-
가까운 점: 주제와 표현이 유사한 논문
-
강화학습 군집: 인과 추론과 불확실성 모델링을 포함한 영역에 인접한 큰 연구 주제
-
주변 연구: 시각·3차원 인식, 생성 모델, 기계학습 이론, 언어 모델 평가와 행위자
-
해석: 현대 기계학습의 여러 연구 주제와 연결된 강화학습의 위치
-
주의: 한 해의 논문 분포만으로는 판단할 수 없는 관심의 증가율과 시간에 따른 변화
역사에서 이어진 핵심 과제
-
기여도 할당(credit assignment): 늦게 받은 보상을 과거의 어떤 행동과 연결할지 결정
-
탐색과 활용: 새로운 행동의 시도와 이미 알려진 좋은 행동 사이의 균형
-
표본 효율성: 적은 환경 상호작용으로 유용한 정책 학습
-
안정성과 일반화: 학습 결과의 변동을 줄이고 새로운 환경에서도 성능 유지
-
보상 정렬: 수치로 정의한 보상과 사람이 의도한 목표의 차이 축소
-
역사적 의미: 제한된 보상으로 장기적인 행동을 학습하면서 더 복잡한 환경으로 적용 범위를 넓혀 온 과정