defpolicy_improvement(V, P, gamma=1.0):
nS = len(P) # 상태의 수
nA = len(P[0]) # 행동의 수
Q = np.zeros((nS, nA)) # 행동가치함수for s inrange(nS):
for a inrange(nA):
for prob, next_state, reward, done in P[s][a]:
Q[s][a] += prob * (reward + gamma * V[next_state] * (not done))
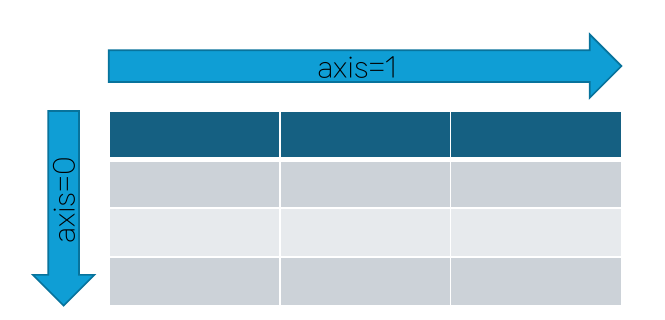
new_pi = {s: a for s, a inenumerate(np.argmax(Q, axis=1))}
return new_pi
defpolicy_iteration(env, gamma=1.0, theta=1e-10):
pi = random_policy(env)
P = env.unwrapped.P
whileTrue:
old_pi = dict(pi)
V = policy_evaluation(pi, P, gamma, theta)
pi = policy_improvement(V, P, gamma)
if old_pi == pi:
break# 더이상 정책이 개선되지 않으면 중단return V, pi
무작위 정책
defrandom_policy(env):
return {s: env.action_space.sample()
for s inrange(env.observation_space.n)}
policy_iteration(env)
가치 반복
defvalue_iteration(env, gamma=1.0, theta=1e-10):
P = env.unwrapped.P # 전이 함수
nS = env.observation_space.n # 상태의 수
nA = env.action_space.n # 행동의 수
V = np.zeros(nS) # 상태 가치 함수whileTrue:
Q = np.zeros((nS, nA)) # 행동 가치 함수for s inrange(nS):
for a inrange(nA):
for prob, next_state, reward, done in P[s][a]:
Q[s][a] += prob * (reward + gamma * V[next_state] * (not done))
if np.max(np.abs(V - np.max(Q, axis=1))) < theta:
break
pi = {s: a for s, a inenumerate(np.argmax(Q, axis=1))} # 정책=가장 가치가 높은 행동
V = np.max(Q, axis=1) # 상태 가치도 맞춰서 업데이트return V, pi