
강화학습이란 무엇인가
강화 학습 Reinforcement Learning
- 동물과 인간이 보상과 처벌에 따라 학습하는 것을 가리키는 심리학 용어에서 유래
- 머신러닝의 3가지 큰 갈래 중 하나
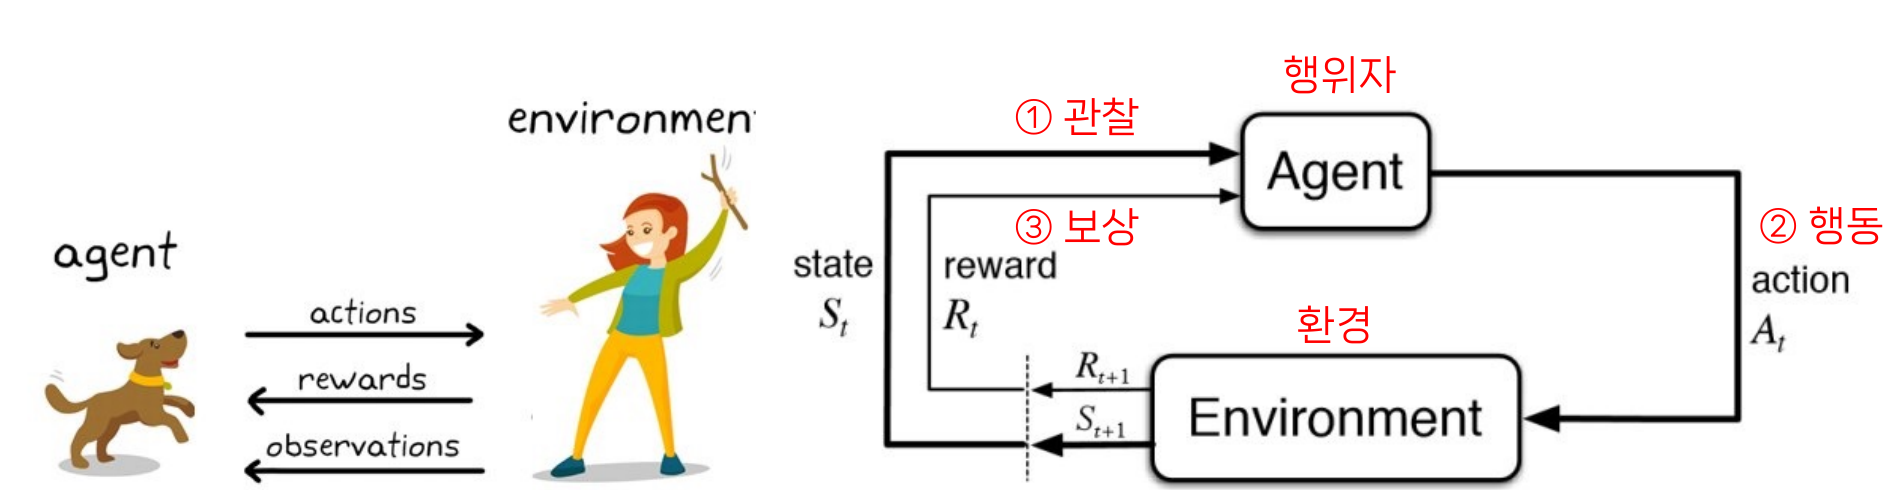
- 행위자는 환경과 상호작용
- 행위자가 행동을 하여 환경에 영향을 미침
- 그 결과로 환경으로부터 행위자에게 보상이 주어짐
- 행위자는 환경의 변화된 상태와 주어진 보상을 관찰하여 학습
가상 환경에서의 전략 학습
바둑
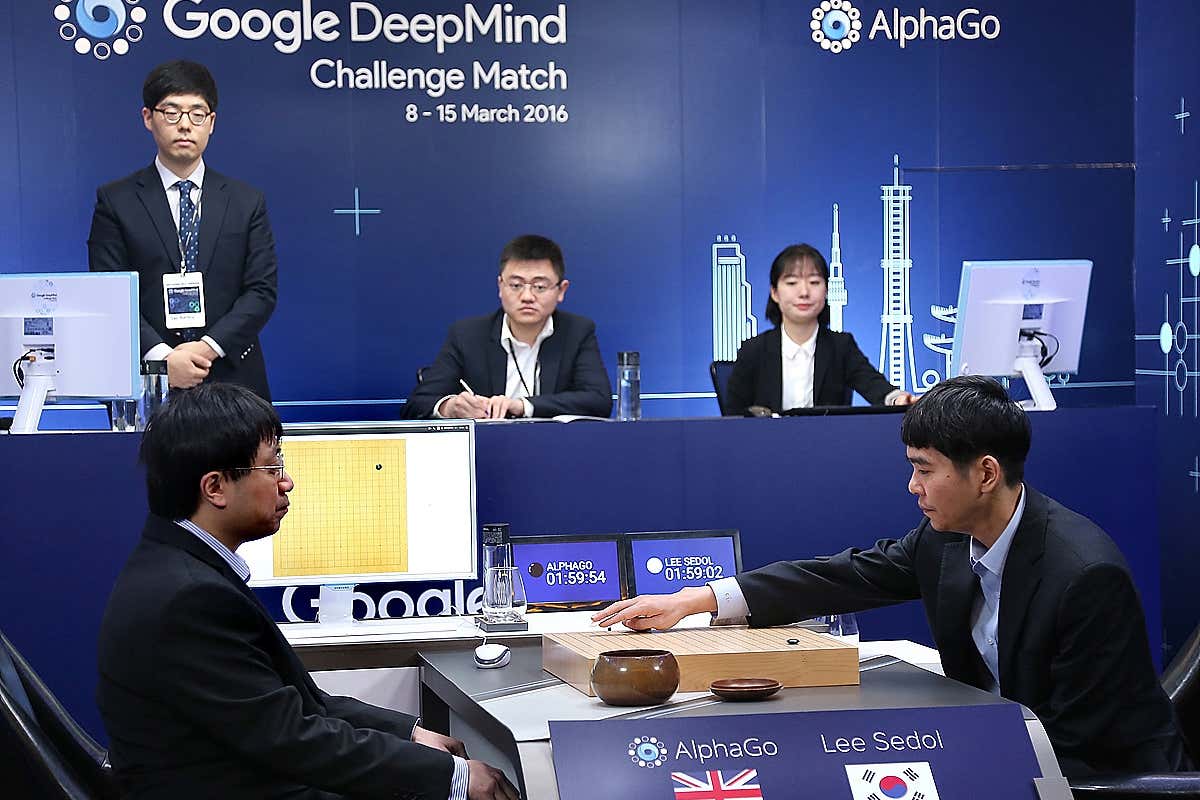
- 환경: 바둑판과 상대방
- 상태: 바둑판의 돌 배치
- 행동: 돌 놓을 위치 선택
- 보상: 게임 승패
컴퓨터 게임
- 환경: 대량의 시행착오를 빠르게 생성할 수 있는 가상 공간
- 상태: 게임 화면
- 행동: 조작 버튼 선택
- 보상: 게임 점수
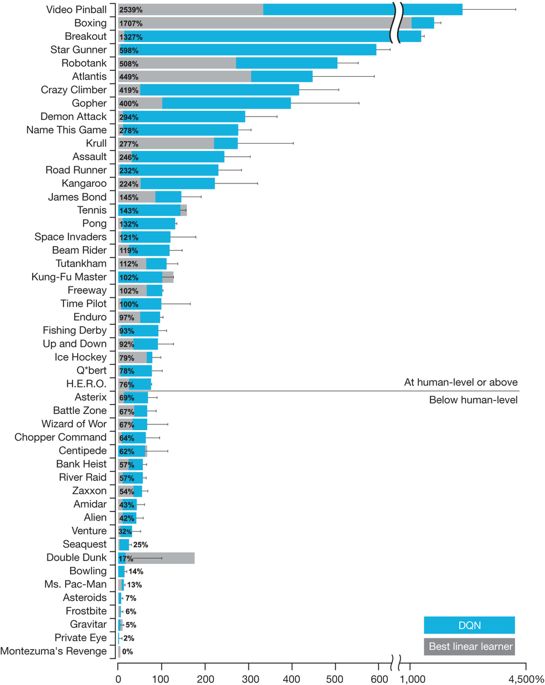
- 49개 아타리 게임에서 딥러닝 기반 강화학습 DQN의 인간 대비 성능 (2015)
- 가로축: 사람의 성능을 100%로 두고 정규화한 게임 점수
- 파란 막대: 딥러닝 기반 강화학습 DQN의 성능
- 일부 게임에서는 사람보다 높은 점수
- 장기 계획이나 드문 보상이 필요한 게임에서는 낮은 점수
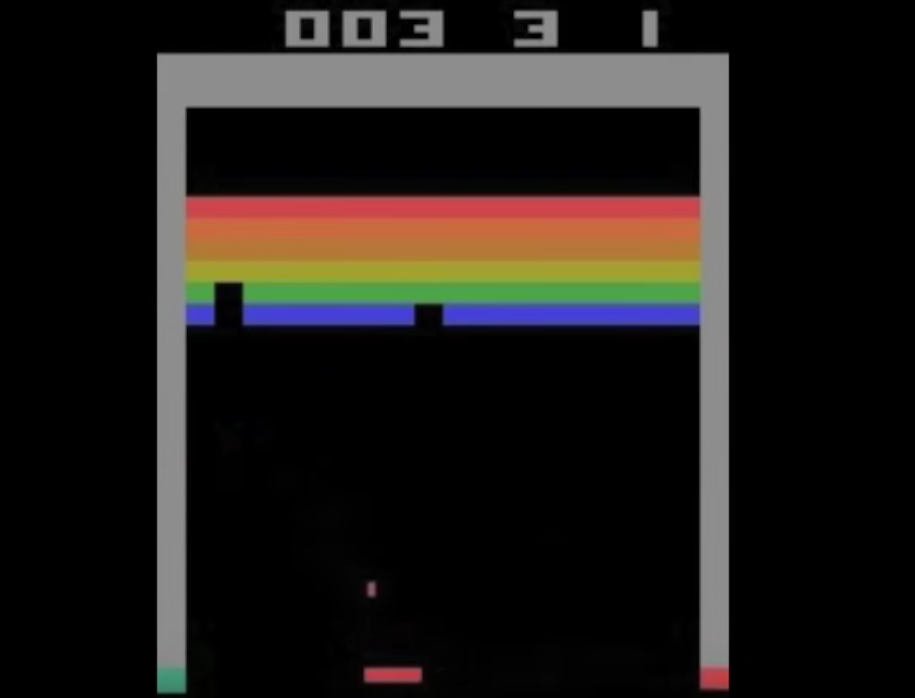
- DQN의 벽돌깨기 플레이 영상
- 학습 결과: 벽돌 옆에 통로를 만든 뒤 공을 위쪽으로 보내는 전략
- 의미: 사람이 전략을 직접 알려 주지 않아도 경험을 통해 나타난 고득점 행동
다중 행위자의 협동과 경쟁
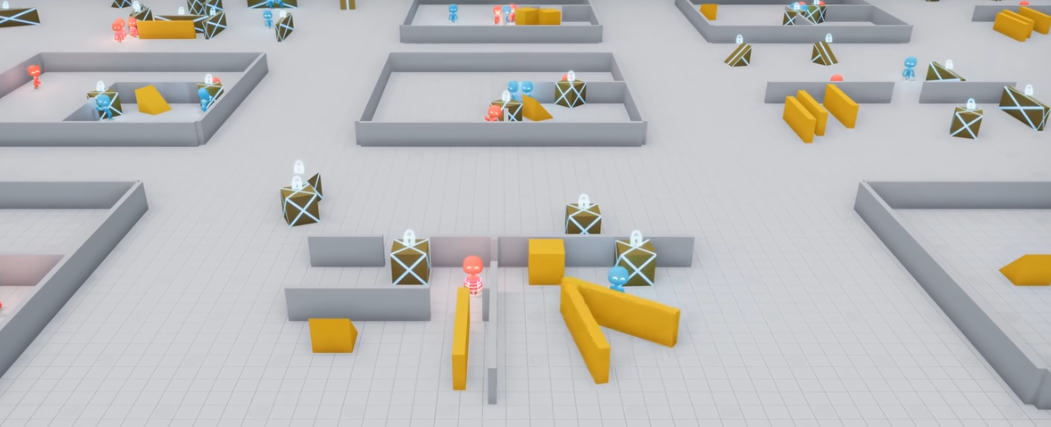
- 다중 행위자 숨바꼭질 영상
- 환경: 여러 행위자가 함께 행동하는 숨바꼭질 공간
- 상태: 주변 물체와 다른 행위자의 위치
- 행동: 이동, 상자와 경사로 조작
- 보상: 같은 팀의 숨기 또는 찾기 성공
설계
반도체 배치 설계
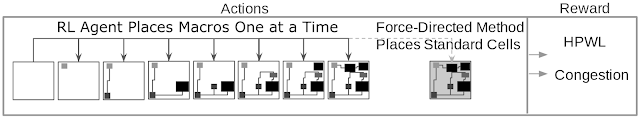
- 반도체 바닥 배치(floorplanning): 칩의 큰 기능 블록인 매크로의 위치를 정하는 문제
- 상태: 이미 배치한 매크로와 남은 배치 공간
- 행동: 다음 매크로의 위치 선택
- 보상: 배선 길이와 혼잡도를 반영한 낮은 배치 비용
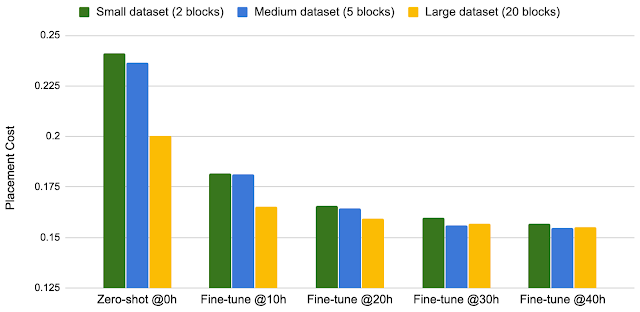
- 배치 비용: 낮을수록 좋은 성능
- 미세 조정 시간: 길어질수록 세 데이터셋의 비용이 낮아지며 비슷한 수준으로 수렴
- 사전 학습 데이터: 큰 데이터셋의 이점은 미세 조정 초기 구간에서 더 뚜렷함
- 학습 구조: 과거 설계 경험으로 사전 학습한 뒤 새로운 칩에 맞게 미세 조정
물리 시스템의 제어
데이터 센터 냉각
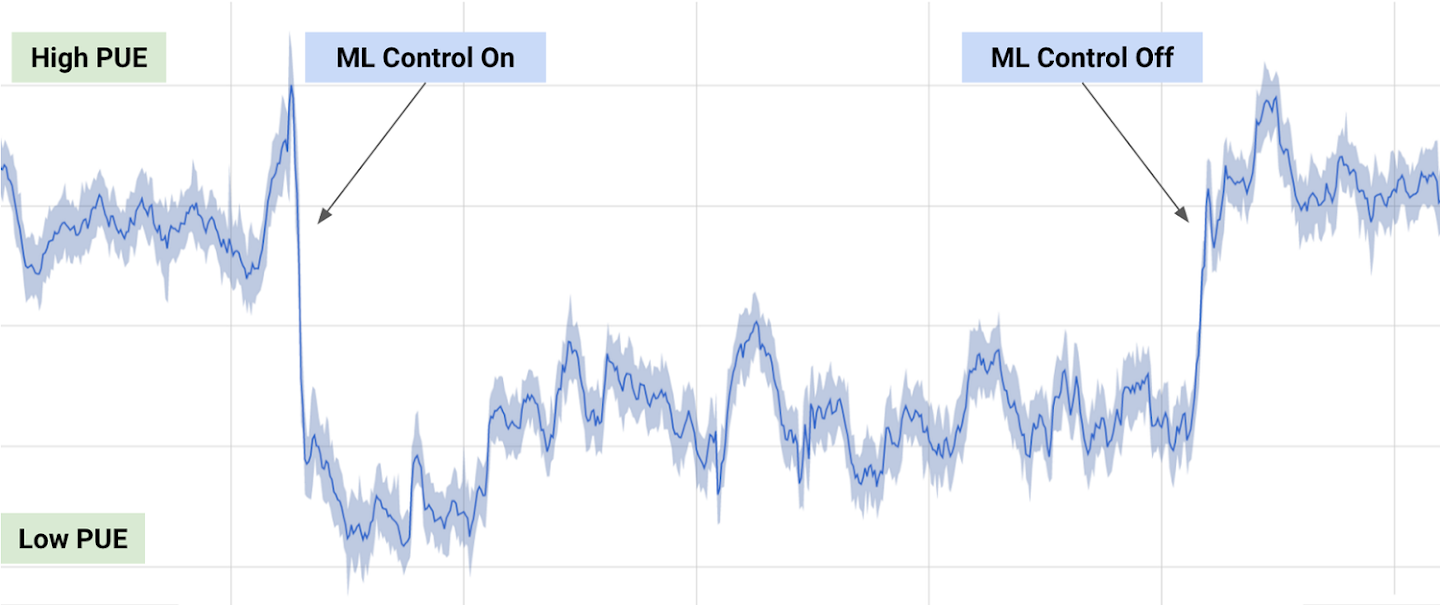
- 상태: 온도, 전력, 펌프 속도 등의 센서값
- 행동: 냉각 장치의 설정값 조절
- 목표: 냉각에 필요한 전력 절감
- 전력 사용 효율(Power Usage Effectiveness, PUE): 전체 전력 사용량을 정보기술 장비의 전력 사용량으로 나눈 값
- 낮을수록 높은 효율
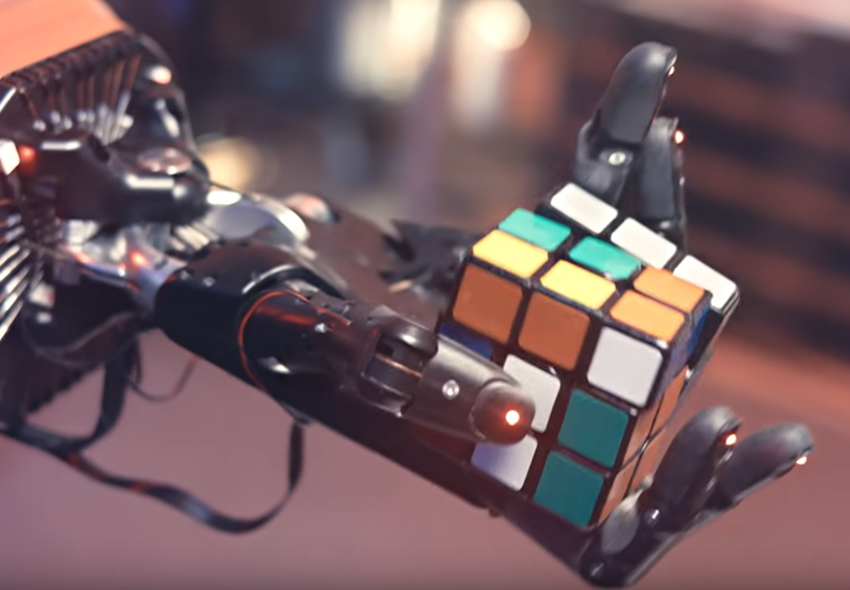
로봇 조작
- 상태: 로봇 손의 관절 위치와 물체의 자세
- 행동: 각 관절에 전달할 제어 명령
- 제약: 실제 로봇에서 발생하는 실험 비용과 파손 위험
- 학습 방법: 시뮬레이션에서 학습한 정책을 실제 환경으로 전이
핵융합 플라즈마 제어
- 상태: 플라즈마의 전류, 위치, 형태
- 행동: 여러 자기 코일의 전압 조절
- 목표: 지정한 플라즈마 형태의 실시간 유지
- 학습 방법: 시뮬레이터에서 학습한 정책을 실제 토카막 제어기에 적용
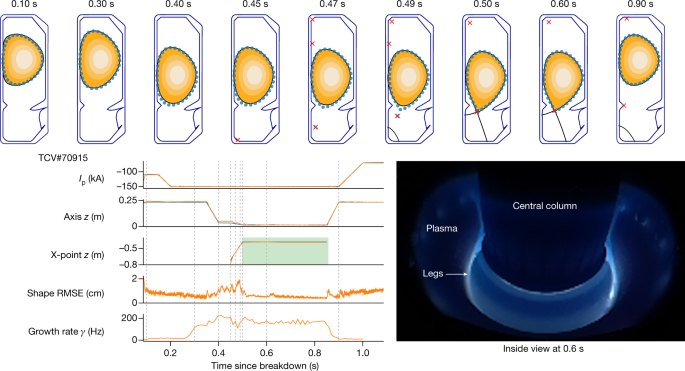
- 그림 위쪽: 시간에 따른 목표 플라즈마 형태
- 그림 아래쪽: 플라즈마 전류, 위치, 형태 오차의 변화
- 의미: 빠르게 변하고 서로 결합된 여러 물리량을 하나의 정책으로 제어한 사례
퀴즈
행위자가 행동한 뒤 환경에서 받는 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.