
가치
가치와 정책
- 보상(reward): 한 시점에 환경에서 받는 신호
- 수익(return): 현재부터 미래까지 받을 보상의 누적
- 정책(policy): 상태에서 행동을 선택하는 규칙
- 결정론적 정책: 같은 상태에서 항상 같은 행동 선택
- 확률론적 정책: 행동별 확률에 따라 행동 선택
- 가치(value): 정책을 계속 따를 때 예상되는 수익
- 현재의 즉시 보상보다 장기적인 결과를 평가
- 같은 상태라도 따르는 정책에 따라 달라지는 값
상태 가치
- 평가 대상: 현재 놓인 상태
- 질문: “이 상태에서 정책을 계속 따르면 얼마만큼의 수익을 기대할 수 있는가?”
- 특징: 다음 행동을 하나로 고정하지 않고 정책이 선택할 모든 행동을 함께 반영
- 용도: 현재 상황이 장기적으로 유리한지 평가
행동 가치
- 평가 대상: 현재 상태에서 선택할 특정 행동
- 질문: “이 행동을 먼저 한 뒤 정책을 계속 따르면 얼마만큼의 수익을 기대할 수 있는가?”
- 특징: 첫 행동을 고정한 평가
- 용도: 같은 상태에서 여러 행동의 장기적 결과 비교
- 상태 가치 = 정책이 선택할 행동들의 가치의 평균
이득
- 이득(advantage): 특정 행동의 가치와 그 상태 가치의 차이
- 양의 이득: 그 상태에서 정책에 따른 평균적인 행동 가치보다 가치가 높음
- 음의 이득: 정책에 따른 평균적인 행동 가치보다 가치가 낮음
- 0에 가까운 이득: 정책에 따른 평균적인 행동 가치와 비슷함
벨만 방정식
- 현재 가치 = 즉시 받을 보상 + 다음 상태의 가치
- 먼 미래의 결과를 한 번에 계산하는 대신 한 단계 뒤의 가치와 연결
- 재귀적 구조가 정책 평가와 가치 학습의 기반
최적성
- 최적 정책: 모든 상태에서 다른 정책보다 크거나 같은 기대 수익을 만드는 정책
- 같은 최고 가치를 만드는 행동이 여러 개라면 여러 최적 정책 가능
- 최적 정책이 여러 개여도 최적 가치는 같음
- 최적 상태 가치: 최적 정책에서 상태 가치
- 최적 행동 가치: 최적 정책에서 행동 가치
근사
- 현실적으로 최적 정책을 정확히 찾기는 어려움
- 자주 마주치는 상태를 중심으로 가치와 정책을 근사
- 강점: 자주 마주치는 상태에서 효율적인 의사결정
- 한계: 드물거나 학습 분포에서 벗어난 상태에서 잘못된 가치 추정 가능
적대적 공격
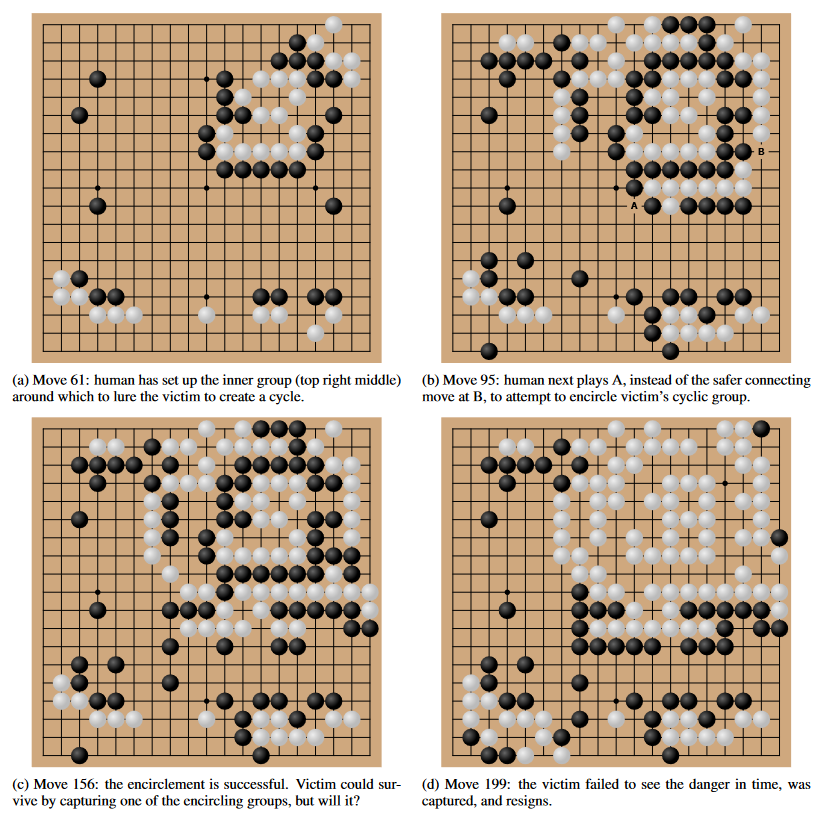
- 바둑에서 자연스럽게 발생하기 어려운 순환 형태의 돌무리를 의도적으로 구성
- 학습된 적대적 정책이 초인적 설정의 바둑 AI를 상대로 97%가 넘는 승률 기록
- 공격 정책의 일반적인 바둑 실력보다 특정 취약 상태를 유도하는 능력이 승리의 핵심
- 평균적인 정책 성능과 드문 상태에서의 견고성을 구분할 필요
- Adversarial Policies Beat Superhuman Go AIs
더 알아보기: 가치 함수의 수식
기본 기호
- St: 시점 t의 상태
- At: 시점 t의 행동
- Gt: 시점 t부터의 수익
- π(a∣s): 상태 s에서 정책이 행동 a를 선택할 확률
- p(s′,r∣s,a): 상태 s에서 행동 a를 했을 때 다음 상태 s′와 보상 r이 나타날 확률
- γ: 미래 보상의 할인율
상태 가치 함수
정책 π를 따르며 상태 s에서 시작할 때 얻는 수익의 기댓값입니다.
vπ(s)=Eπ[Gt∣St=s]벨만 기대 방정식은 상태 가치를 한 단계의 보상과 다음 상태의 가치로 분해합니다.
vπ(s)=a∑π(a∣s)s′,r∑p(s′,r∣s,a)[r+γvπ(s′)]행동 가치 함수
상태 s에서 행동 a를 먼저 한 뒤 정책 π를 따를 때 얻는 수익의 기댓값입니다.
qπ(s,a)=Eπ[Gt∣St=s,At=a]qπ(s,a)=s′,r∑p(s′,r∣s,a)[r+γvπ(s′)]상태 가치는 정책에 따른 행동 가치의 가중평균입니다.
vπ(s)=a∑π(a∣s)qπ(s,a)이득 함수
이득은 특정 행동의 가치에서 그 상태의 평균적인 가치를 뺀 값입니다.
Aπ(s,a)=qπ(s,a)−vπ(s)따라서 행동 가치는 상태 가치와 이득의 합으로 표현할 수 있습니다.
qπ(s,a)=vπ(s)+Aπ(s,a)최적 가치 함수
v∗(s)=πmaxvπ(s)q∗(s,a)=πmaxqπ(s,a)벨만 최적성 방정식
정책의 행동을 평균내는 대신 가장 가치가 큰 행동을 선택합니다.
v∗(s)=amaxs′,r∑p(s′,r∣s,a)[r+γv∗(s′)]q∗(s,a)=s′,r∑p(s′,r∣s,a)[r+γa′maxq∗(s′,a′)]퀴즈
가치(value)의 의미로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.