인간 피드백을 통한 강화학습(RLHF)
- 인간 피드백을 이용한 강화학습(Reinforcement Learning from Human Feedback, RLHF): 언어 모델의 출력을 사람의 선호에 맞추는 방법
자연어 생성에서 강화학습의 필요성
- 자연어 생성에서 지도 학습: 확률이 높은 단어를 예측하는 방식
- 문제:
- 기존 데이터와 비슷한 문장을 생성하는데 초점
- 학습에 사용하는 손실 함수와 평가 지표(예: BLEU)가 다른 경우
- 같은 표현이 반복
- 강화학습으로 위의 문제들을 해결 가능
챗봇에서 강화학습의 활용
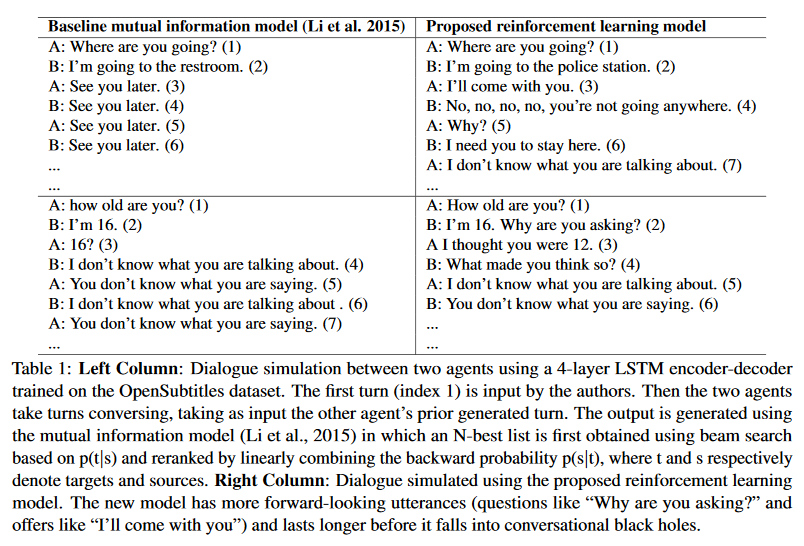
- Li et al. (2016), Deep Reinforcement Learning for Dialogue Generation
- 챗봇의 발언의 질을 평가하는 함수 구성
- 답변하기 쉬움
- 새로운 정보
- 의미상 일관성
- 위의 함수로 보상을 계산하여 강화학습
ChatGPT 훈련
2022년 초 발표한 InstructGPT의 훈련 방법으로, 초기 ChatGPT에도 사용됨
1단계: 지도 미세 조정
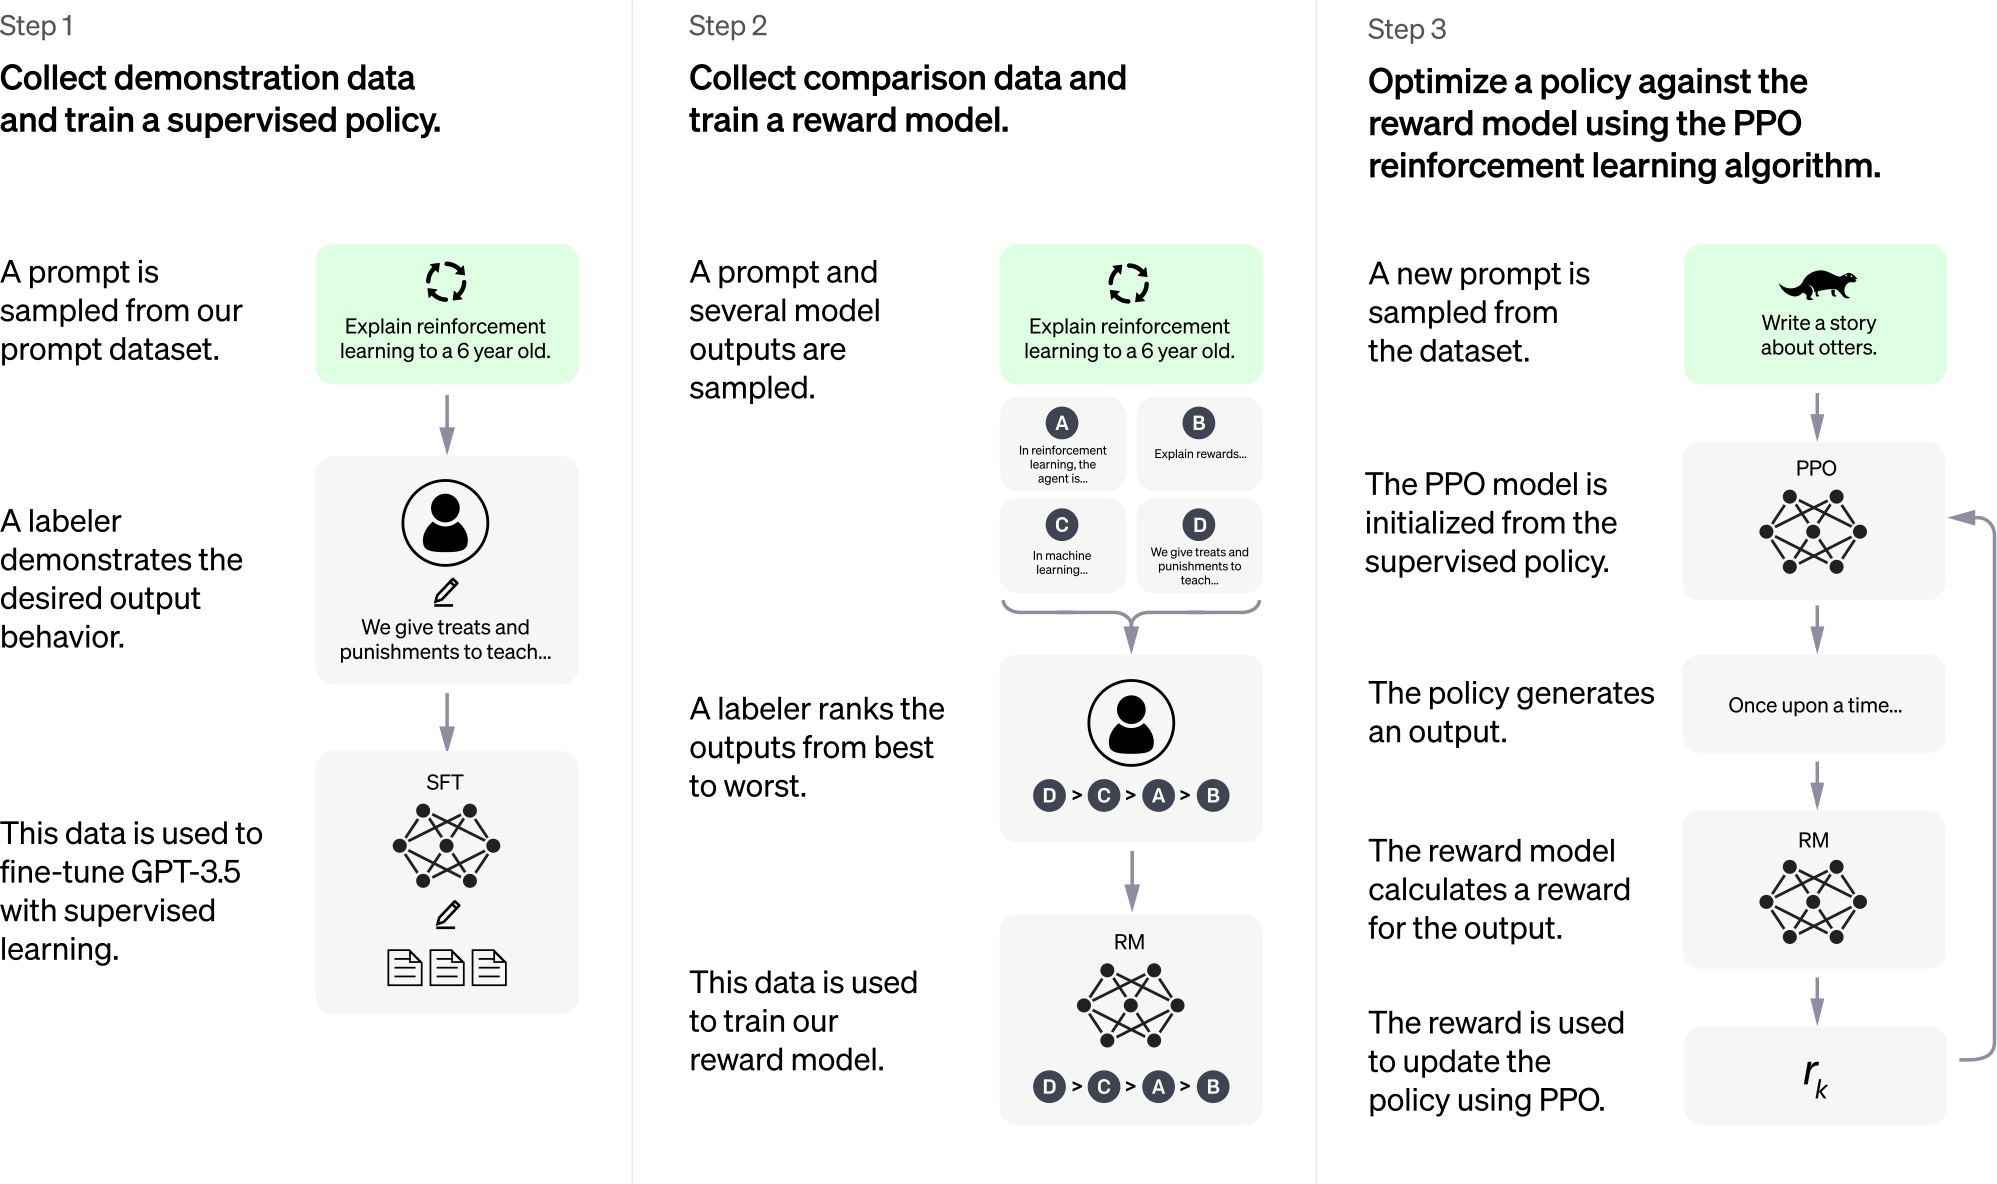
- 1만 3천 개의 지시 프롬프트
- 인간 작업자가 무작위로 추출된 지시 프롬프트에 답변
- 인간 답변 데이터를 GPT에 미세 조정
- 지도 미세 조정(Supervised Fine-Tuning, SFT) 모델
2단계: 보상 모델
- SFT 모델을 이용해 동일한 프롬프트에 다양한 답변 생성
- 생성된 답변에 대해 사람이 선호도 표시
- 사람의 선호도 데이터를 바탕으로, 선호도를 예측하는 보상 모델 학습
3단계: 강화학습
- 새로운 프롬프트를 GPT에 제시
- GPT가 생성한 답변을 보상 모델로 평가
- GPT를 업데이트할 때마다 생성하는 답변이 달라짐
- 사람이 매번 평가하면 GPT를 빠르게 업데이트하기 어려움
- 보상이 높아지는 방향으로 GPT를 강화학습
- 사람들이 선호할 것으로 예측되는 방향
- 인간 피드백을 통한 강화학습(Reinforcement Learning from Human Feedback, RLHF): 사람의 선호를 학습한 보상 모델을 이용해 GPT의 응답을 개선
퀴즈
자연어 생성에서 강화학습을 사용하는 이유로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.