RLHF의 대안
인간 피드백의 한계
- AlphaGo: 실제 게임 승리라는 명확한 보상 함수로 학습
- RLHF: 인간의 주관적인 평가에 기반한 보상 모델 사용
- 부정확한 보상 신호: 실제 목표 대신 인간의 주관적인 평가를 대리 지표로 사용, 자료에서는 이를 "vibe check"로 표현
- 보상 모델의 취약성: 모델이 보상 모델의 취약점을 악용하는 방향으로 최적화
- 학습 데이터 분포를 벗어난 이상한 출력으로 높은 보상을 얻을 수 있음
- RLHF가 여전히 유용한 이유
- 생성자와 판별자의 격차 활용: 인간이 답을 직접 작성하는 것보다 여러 답안 중 선택하는 것이 더 쉬움
- 환각(hallucination) 완화에 도움: 보상 모델이 사실과 다른 내용을 낮은 점수로 평가
RLHF의 대안
- RLHF(Reinforcement Learning from Human Feedback): ChatGPT의 학습 방식처럼 인간 피드백을 이용하는 강화학습
- 인간 피드백의 한계에 대한 대안: AI가 평가하도록 변경
- AI 피드백을 통한 강화학습(Reinforcement Learning from AI Feedback, RLAIF)
- PPO 등 알고리즘의 발전에도 여전히 강화학습은 어려운 문제
- 강화학습을 하지 않는 대안
- 직접 선호 최적화(Direct Preference Optimization, DPO)
- Best-of-N Sample Rejection
Constitutional AI
- AI에서 도움됨(helpful)과 무해함(harmless) 사이의 교환 관계
- 무해한 AI는 덜 도움됨
- 도움되는 AI는 해를 끼칠 수 있음
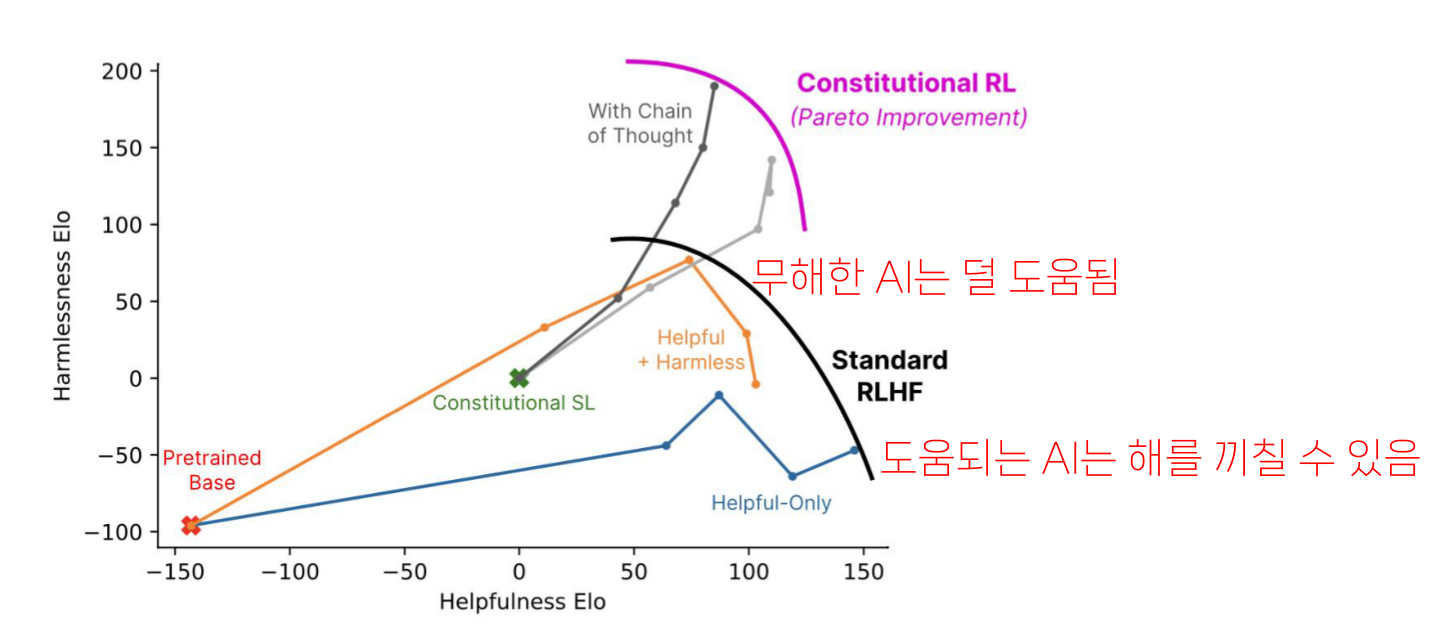
출처: Constitutional AI: Harmlessness from AI Feedback
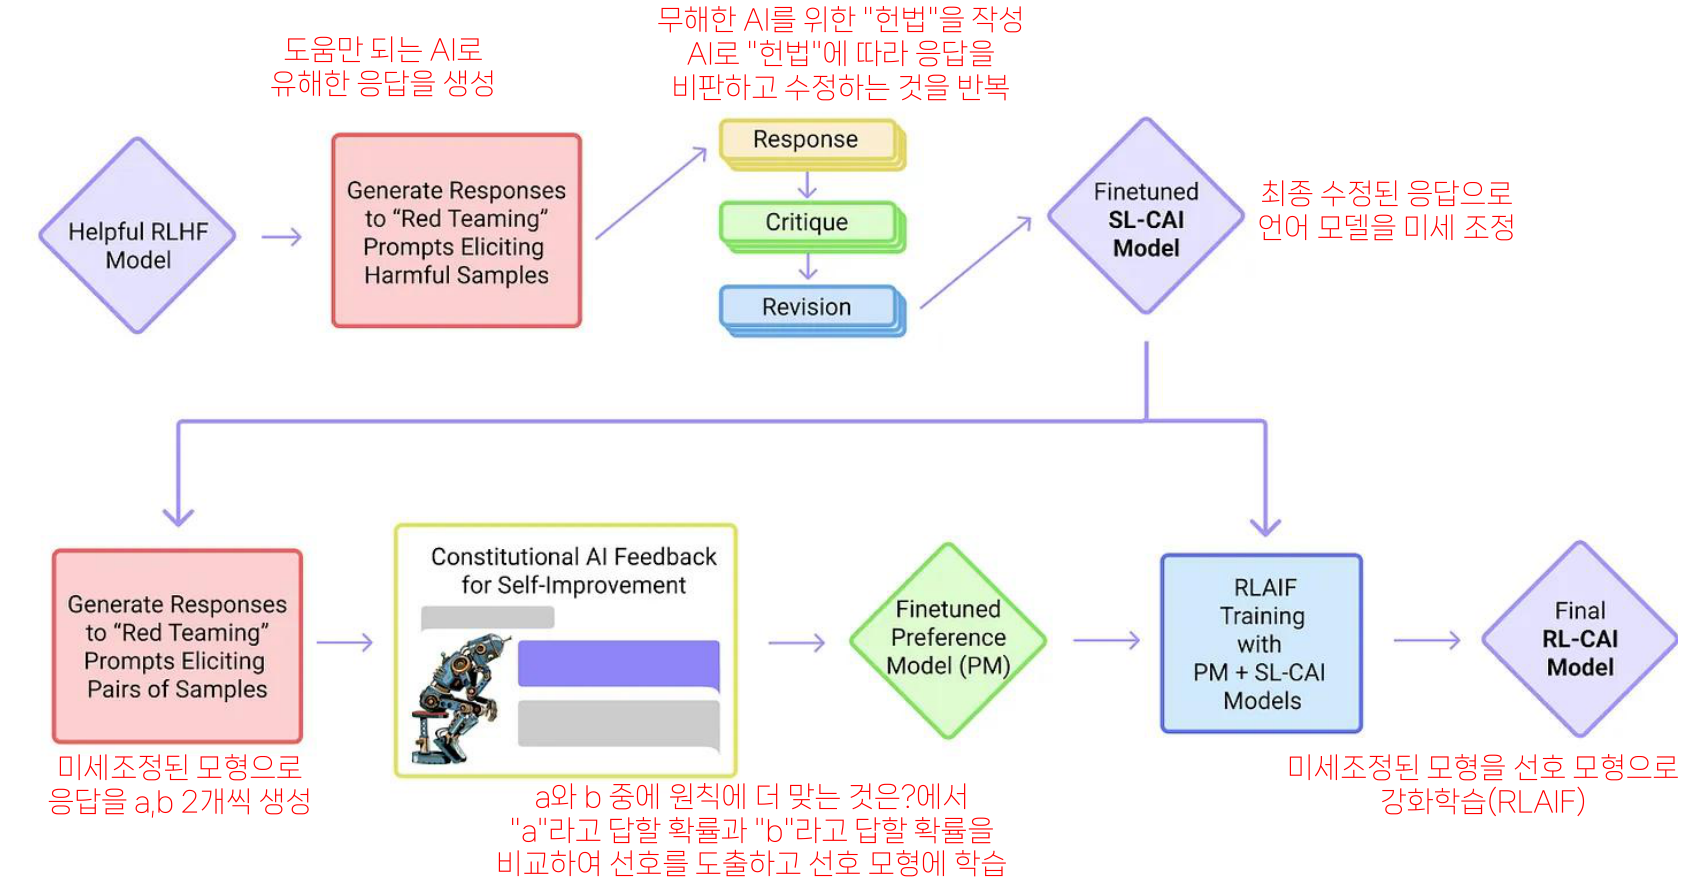
Constitutional AI의 절차
- 무해한 AI를 위한 "헌법" 작성
- 도움만 되는 AI로 유해한 응답 생성
- AI로 헌법에 따라 응답을 비판하고 수정하는 과정 반복
- 최종 수정된 응답으로 언어 모델을 미세 조정
- 미세 조정된 모델로 응답을 a, b 두 개씩 생성
- 두 응답 중 원칙에 더 맞는 것을 비교하여 선호 도출
- "a"라고 답할 확률과 "b"라고 답할 확률을 비교
- 도출된 선호를 선호 모델에 학습
- 미세 조정된 모델을 선호 모델로 강화학습(RLAIF)
RLAIF는 효과적인가?
- SFT: 지도학습으로 미세 조정한 모델
- RLAIF: 별도의 학습을 시키지 않은 LLM을 이용해 선호 데이터 생성
- 두 개의 응답을 주고 선택하도록 프롬프트 제시
- 선호 데이터로 보상 모델(Reward Model, RM)을 학습한 뒤 강화학습
- 인간 평가자의 선호도
- SFT(27%) vs. RLHF(73%)
- SFT(29%) vs. RLAIF(71%)
- RLHF(50%) vs. RLAIF(50%)
- 이 비교에서는 사실성과 안전성 등을 논외로 하고, 선호도에 한정하면 RLAIF는 RLHF 못지않은 결과
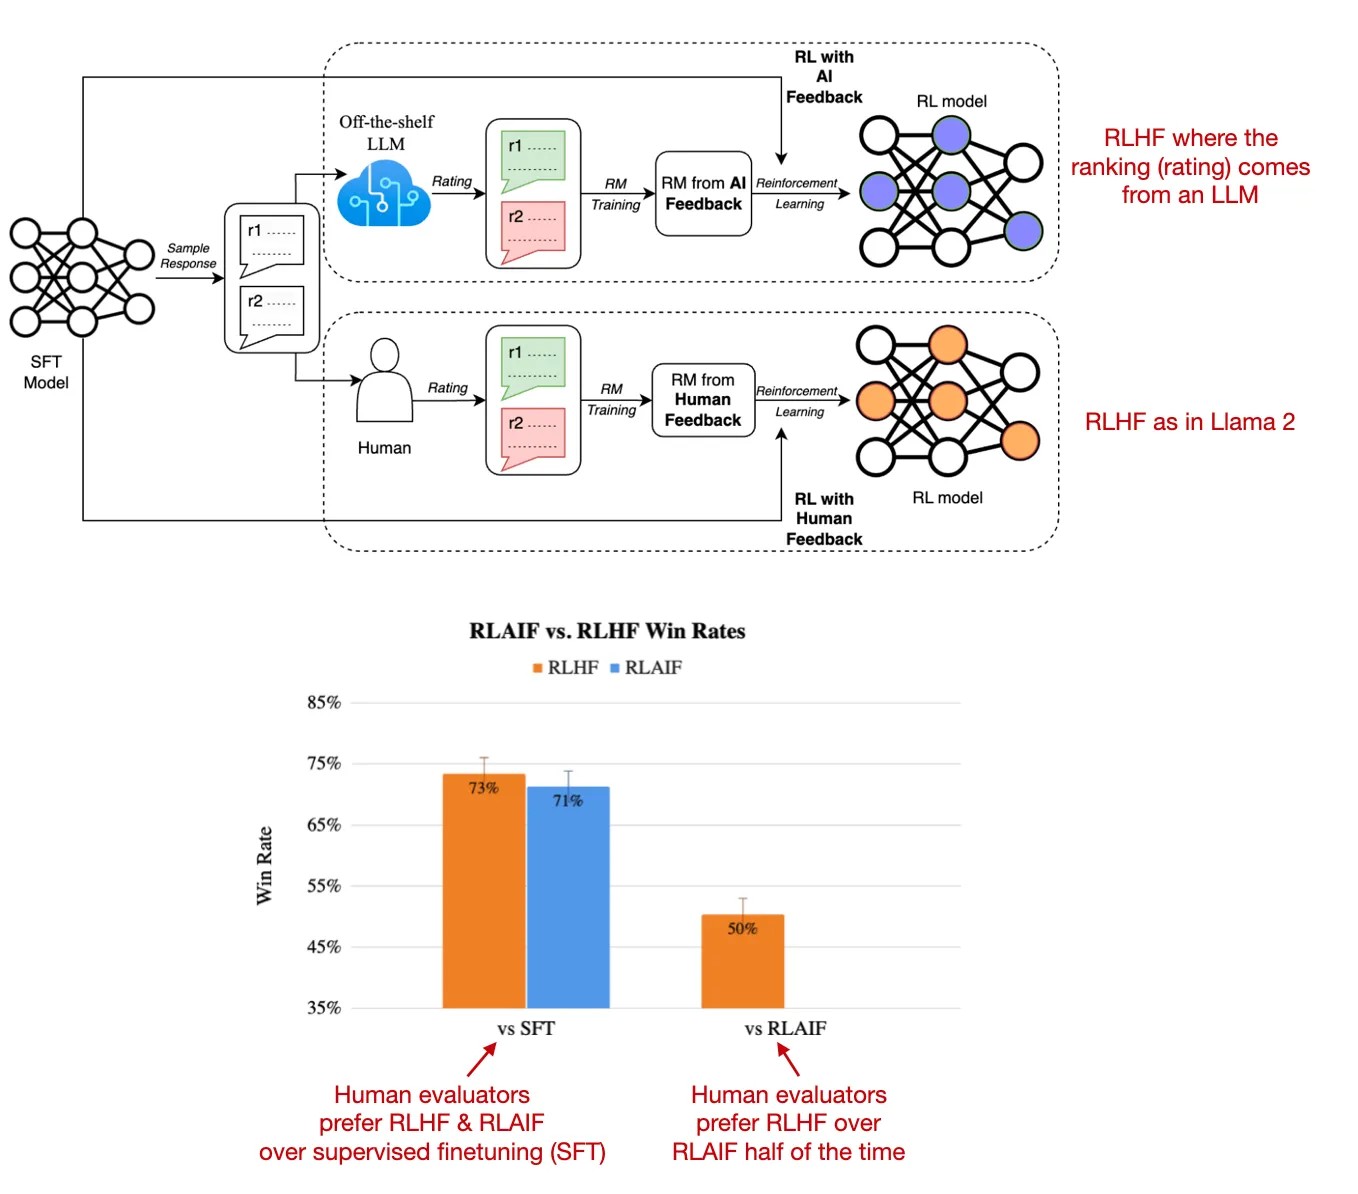
출처: RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback
Best-of-N Sample Rejection
- 실제 챗봇 서비스 플랫폼을 대상으로 연구
- 사용자 참여율(user engagement)을 다양한 방식으로 측정하고 보상 모델에 학습
- 평균 대화 길이
- AI에게 답변을 재생성시킨 비율
- 별점
- 사용자 유지율(retention)
- Best-of-N Sample Rejection
- N개의 응답 생성 → 보상 모델로 점수 계산 → 가장 점수가 높은 답변 제시
- 실제 사용자를 대상으로 A/B 테스트하여 평가
- 사용자 유지율 비교 그림의 보상 조건
- 대화 길이를 보상으로 사용
- 답변 재생성을 하지 않는 것을 보상으로 사용
- 위 두 가지를 모두 보상으로 사용
- 보상 모델이 없는 경우의 사용자 유지율과 비교
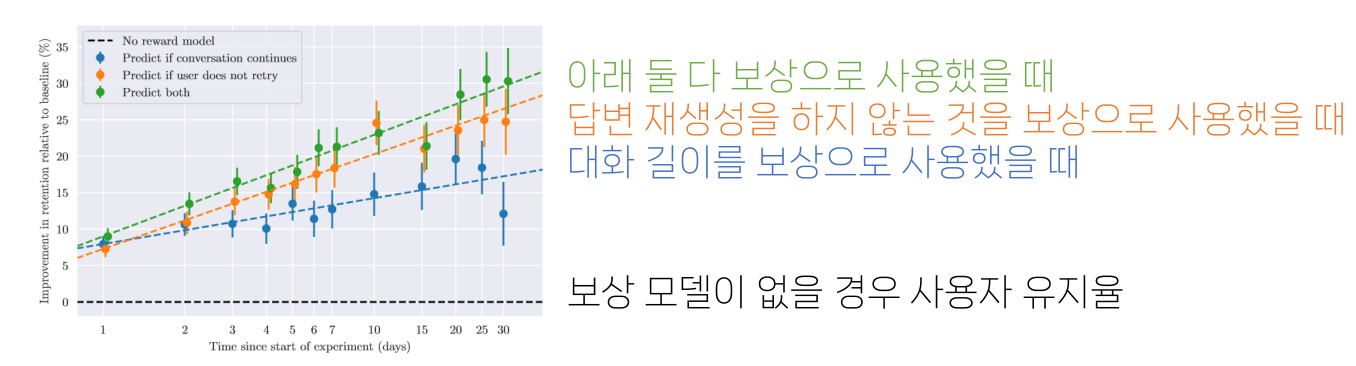
출처: Rewarding Chatbots for Real-World Engagement with Millions of Users
퀴즈
RLHF에서 보상 모델의 취약점을 악용하는 문제가 생길 수 있는 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.