직접 선호 최적화(DPO)
직접 선호 최적화(DPO)
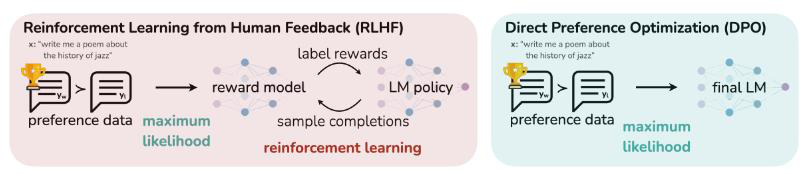
- 직접 선호 최적화(Direct Preference Optimization, DPO): 같은 질문에 대한 두 답변 중 어느 쪽이 더 좋은지를 언어 모델에 직접 학습하는 방법
- 학습 데이터: 질문, 더 선호된 답변, 덜 선호된 답변의 묶음
예시
- 질문: "회의가 내일 오후 2시라는 안내를 정중하게 써 줘."
- 답변A: "회의는 내일 오후 2시에 진행됩니다. 참석 부탁드립니다."
- 답변B: "내일 2시니까 와."
- 선택 이유: 사용자는 답변 A를 선호
DPO의 학습 과정
- 같은 질문에 대한 두 답변과 선호 표시를 준비
- 언어 모델이 각 답변을 생성할 확률을 계산
- 더 선호된 답변의 확률을 높이고 덜 선호된 답변의 확률을 낮추는 방향으로 파라미터 조정
- 여러 답변 쌍에 반복하여 적용하면서 선호 기준을 학습
지도 미세조정과 차이
- 지도 미세조정(Supervised Fine-Tuning, SFT): 모범 답변을 따라 생성하도록 학습
- DPO: 비교할 답변과 어느 쪽을 선호하는지도 함께 학습
| 방법 | 학습 방식 |
|---|---|
| SFT | 질문과 모범 답변 → 모범 답변을 따라 생성하도록 언어 모델을 미세조정 |
| RLHF(PPO) | 선호 데이터 → 별도 보상 모델 학습 → 보상 점수를 높이도록 언어 모델을 강화학습 |
| DPO | 선호 데이터 → 선호된 답변 쪽으로 언어 모델을 직접 미세조정 |
- 앞의 예시에 적용하면
- SFT: 질문과 답변 A를 보여 주고, 답변 A를 따라 생성하도록 학습
- DPO: 질문과 답변 A·B를 보여 주고, A를 더 선호한다는 비교 결과로 학습
- 학습 후에는 두 방법 모두 질문을 입력받아 답변을 직접 생성
- 기본 DPO에서는 준비된 답변 쌍으로 학습하므로, 학습 중 새 답변을 생성하고 보상 모델로 채점하는 강화학습 과정이 불필요
DPO는 보통 SFT를 마친 모델에서 출발. 학습 전 모델의 복사본을 **기준 모델(기준 정책)**로 보관하고, 학습하는 모델만 변경. 이 복사본을 비교 기준으로 삼아, 앞의 예시에서는 학습 전보다 답변 A 쪽으로 생성 경향이 더 기울도록 조정.
RLHF와 성능 비교
- 자료에 제시된 비교에서 DPO의 응답이 SFT와 기존 RLHF(PPO)보다 높은 선호도
- 사람과 GPT-4 평가에서 같은 결과
- GPT-4는 S, C 두 가지 평가 프롬프트 사용
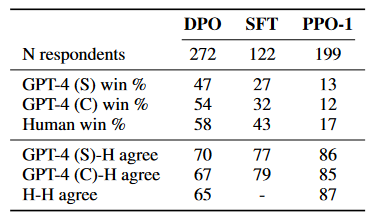
출처: Direct Preference Optimization: Your Language Model is Secretly a Reward Model
DPO의 손실 함수와 기울기
수식에 사용하는 기호
- x: 프롬프트
- yw: 더 선호된 답변, yl: 덜 선호된 답변
- πθ: 파라미터 θ를 학습하는 언어 모델의 정책
- πref: 학습 중 고정하는 기준 정책
- πθ(y∣x): 프롬프트 x에서 답변 y 전체를 생성할 확률
- D: 프롬프트와 선호 답변 쌍으로 구성된 데이터
- β>0: 기준 정책에서 벗어나는 정도를 조절하는 계수
- σ: 입력을 0과 1 사이로 바꾸는 시그모이드 함수
확률 변화에서 암묵적 보상으로
기준 정책에 비해 답변의 생성 확률이 얼마나 커졌는지를 다음 점수로 표현
r^θ(x,y)=βlogπref(y∣x)πθ(y∣x)- 확률비가 1보다 크면 양의 점수, 1보다 작으면 음의 점수
- r^θ: 별도 보상 모델의 출력이 아니라, 언어 모델과 기준 모델의 확률로 계산하는 암묵적 보상
- 두 답변의 점수 차이를 사용하므로, 같은 프롬프트에 공통으로 더해지는 보상 항은 비교에서 소거
선호 관계를 학습하는 손실 함수
LDPO(πθ;πref)=−E(x,yw,yl)∼D[logσ(r^θ(x,yw)−r^θ(x,yl))]- σ(r^θ(x,yw)−r^θ(x,yl)): 두 답변 중 yw를 선호할 확률의 추정치
- 선호된 답변의 점수가 덜 선호된 답변보다 충분히 높아지면, 추정 확률은 1에 가까워지고 손실은 0에 가까워짐
- 손실 최소화: 기준 정책 대비 확률비가 yl보다 yw에서 더 커지도록 조정
기울기와 업데이트의 크기
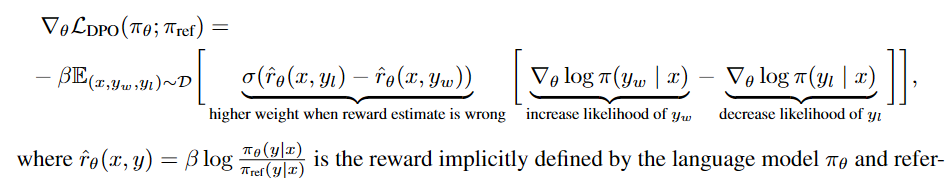
∇θLDPO(πθ;πref)=−βE(x,yw,yl)∼D[σ(r^θ(x,yl)−r^θ(x,yw))⋅(∇θlogπθ(yw∣x)−∇θlogπθ(yl∣x))]- 기준 정책은 고정하므로, 그 로그 확률을 θ로 미분한 값은 0
- 손실 기울기의 반대 방향으로 업데이트
- logπθ(yw∣x)를 높이는 방향
- logπθ(yl∣x)를 낮추는 방향
- 가중치 σ(r^θ(x,yl)−r^θ(x,yw))
- 덜 선호된 답변의 암묵적 보상이 더 크면 가중치 증가
- 선호된 답변의 암묵적 보상이 충분히 더 크면 가중치 감소
DPO의 한계
- 학습의 출발점인 SFT 기준 모델의 품질에 크게 의존
- 선호 데이터의 품질과 선택 기준도 결과에 영향
- 사람들이 선호하는 답변이 내용까지 정확한 답변인 것은 아님
- 별도 보상 모델이 없어도 선호 기준의 편향을 학습
- 예: 긴 답변을 더 좋게 평가하는 데이터가 많으면 장황한 답변을 생성하는 경향
퀴즈
DPO가 기존 RLHF의 학습 절차에서 제외하는 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.