
Stable Diffusion
스테이블 디퓨전
스테이블 디퓨전(Stable Diffusion)은 텍스트 조건에 따라 잠재 공간에서 이미지를 생성하는 확산 모형. 여러 기술을 하나의 생성 파이프라인으로 결합
- VAE: 픽셀 이미지와 압축된 잠재 표현 사이를 변환
- 확산 모형: 무작위 잡음에서 시작하여 단계적으로 잡음을 제거
- U-Net: 각 단계에서 현재 잠재 표현에 포함된 잡음을 예측
- 텍스트 인코더: 프롬프트를 문맥이 반영된 토큰 임베딩으로 변환
- 교차 어텐션: 텍스트 토큰의 의미를 U-Net의 이미지 특징에 전달
하나의 신경망보다 여러 구성 요소가 함께 작동하는 잠재 확산(latent diffusion) 파이프라인
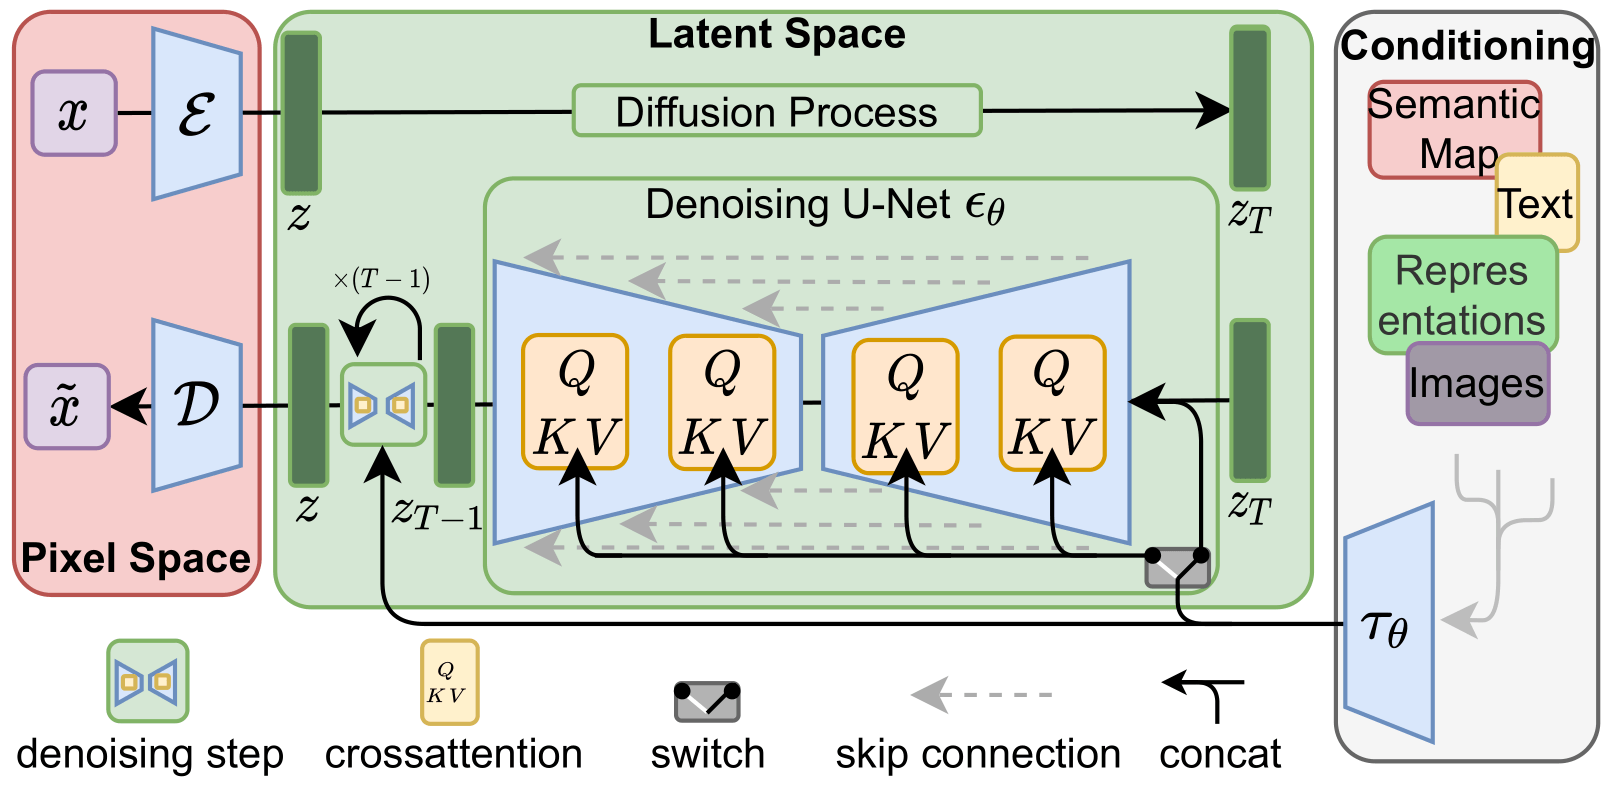
- 왼쪽: 픽셀 이미지와 잠재 표현을 변환하는 인코더 E와 디코더 D
- 가운데: 잠재 공간에서 반복적으로 잡음을 제거하는 U-Net
- 오른쪽: 텍스트 등의 조건을 표현으로 바꾸는 조건 인코더
- 조건 표현을 U-Net의 교차 어텐션에 키와 밸류로 전달
왜 잠재 공간에서 확산하는가
- 기본 확산 모형은 픽셀 공간에서 직접 잡음을 추가하고 제거. 고해상도 이미지는 픽셀 수가 많아 잡음 제거 단계마다 많은 계산량과 메모리가 필요
- 스테이블 디퓨전은 이미지의 핵심 정보를 작은 잠재 표현으로 압축한 뒤 잠재 공간에서 확산을 수행
- 계산 효율: 원본 이미지보다 작은 잠재 표현으로 U-Net의 계산량과 메모리 사용량을 절감
- 정보 보존: 의미와 형태에 필요한 정보를 압축된 표현에 유지
- 압축 손실: 작은 글자나 매우 미세한 질감의 손실 가능
스테이블 디퓨전의 구성 요소
| 구성 요소 | 입력 | 역할 |
|---|---|---|
| 토크나이저와 텍스트 인코더 | 프롬프트 | 문장을 토큰으로 나누고 문맥적 임베딩으로 변환 |
| VAE 인코더 | 픽셀 이미지 | 학습 이미지나 참조 이미지를 잠재 표현으로 압축 |
| 조건부 U-Net | 잡음이 섞인 잠재 표현, 시점, 텍스트 조건 | 현재 단계에서 제거할 잡음을 예측 |
| 교차 어텐션 | U-Net의 이미지 특징, 텍스트 임베딩 | 각 이미지 위치에 필요한 텍스트 정보를 전달 |
| 스케줄러·샘플러 | 잡음 예측과 현재 잠재 표현 | 다음 단계의 잠재 표현을 계산 |
| VAE 디코더 | 최종 잠재 표현 | 사람이 볼 수 있는 픽셀 이미지로 복원 |
이미지 생성 과정
- 프롬프트를 토큰으로 나누고 텍스트 인코더로 임베딩 생성
- 시드에 따라 무작위 잠재 잡음을 생성
- U-Net에 현재 잠재 표현, 확산 시점, 텍스트 임베딩을 입력
- U-Net이 현재 단계에서 제거할 잡음을 예측
- 샘플러가 잡음 예측을 이용하여 잡음이 조금 줄어든 다음 잠재 표현을 계산
- 정해진 샘플링 단계만큼 3~5단계를 반복
- 최종 잠재 표현을 VAE 디코더로 픽셀 이미지로 변환
- 초기 단계: 전체 구도와 큰 형태가 나타나는 경향
- 후기 단계: 경계와 질감 등의 세부 요소가 구체화되는 경향
- 샘플링 단계 수: U-Net 실행 횟수와 생성 시간에 직접 영향
학습과 생성의 차이
| 구분 | 학습 | 텍스트-이미지 생성 |
|---|---|---|
| 시작점 | 학습 이미지를 VAE 인코더로 압축한 잠재 표현 | 시드로 만든 무작위 잠재 잡음 |
| 텍스트 입력 | 이미지 설명 또는 캡션 | 사용자가 입력한 프롬프트 |
| 확산 처리 | 임의의 시점에 잡음을 추가하고 실제 잡음을 정답으로 사용 | 잡음이 많은 시점부터 적은 시점까지 반복 |
| U-Net의 역할 | 추가된 잡음을 예측하도록 학습 | 현재 단계에서 제거할 잡음을 예측 |
| VAE 디코더 | 일반적인 잡음 예측 손실 계산에는 필요하지 않음 | 마지막 잠재 표현을 이미지로 변환 |
- VAE와 텍스트 인코더: 별도로 사전 학습한 뒤 고정하여 사용 가능
- 조건부 U-Net: 이 구성에서 텍스트 조건을 반영한 잠재 잡음 예측을 학습하는 핵심 대상
프롬프트와 교차 어텐션
- 텍스트 인코더가 만든 토큰 임베딩을 교차 어텐션을 통해 U-Net의 여러 해상도 특징에 전달
- 쿼리: U-Net이 처리 중인 잠재 이미지 특징
- 키와 밸류: 프롬프트의 토큰 임베딩
- 결과: 이미지의 각 위치에 관련성이 높은 텍스트 토큰 정보를 선택적으로 반영
- 반복 적용: 여러 U-Net 블록과 잡음 제거 단계에서 교차 어텐션을 수행 가능
- 프롬프트의 한계: 생성 결과에 확률적으로 영향을 주는 조건
- 사물의 정확한 개수, 글자 모양, 복잡한 위치 관계를 보장하지 않음
분류기 없는 안내 classifier-free guidance
분류기 없는 안내(CFG): 프롬프트 조건이 생성 결과에 미치는 강도를 조절하는 방법
- 같은 잠재 표현에 대해 프롬프트 조건을 사용한 잡음 예측을 계산
- 프롬프트가 없거나 네거티브 프롬프트를 사용한 잡음 예측을 계산
- 두 예측의 차이를 이용하여 프롬프트가 가리키는 방향을 강화
| 안내 강도 | 일반적인 경향 |
|---|---|
| 낮음 | 프롬프트 반영 약화, 결과의 변화 폭 증가 가능 |
| 적절함 | 프롬프트 반영과 자연스러운 이미지 품질의 균형 |
| 지나치게 높음 | 과도한 색 강조, 세부 묘사 손상, 다양성 감소 가능 |
네거티브 프롬프트도 제거 규칙이 아닌 조건의 한 종류. 특정 요소의 완전한 배제를 보장하지 않음
수식으로 보는 분류기 없는 안내
프롬프트를 사용한 잡음 예측을 ϵtext, 조건이 없는 잡음 예측을 ϵuncond라고 할 때의 안내된 잡음 예측
ϵguided=ϵuncond+w(ϵtext−ϵuncond)- ϵtext−ϵuncond: 프롬프트 조건이 잡음 예측을 바꾼 방향
- w: 해당 방향의 반영 정도를 정하는 안내 강도
- 네거티브 프롬프트: ϵuncond 자리에 네거티브 조건의 예측을 사용 가능
텍스트-이미지, 이미지-이미지, 인페인팅
| 방식 | 시작점 | 핵심 설정 |
|---|---|---|
| 텍스트-이미지 | 무작위 잠재 잡음 | 프롬프트와 시드에 따라 새 이미지를 생성 |
| 이미지-이미지 | 입력 이미지를 VAE로 압축한 잠재 표현에 잡음을 추가 | 잡음 제거 강도가 원본을 얼마나 유지할지 결정 |
| 인페인팅 | 입력 이미지, 마스크, 텍스트 조건 | 마스크로 지정한 영역을 중심으로 내용을 다시 생성 |
- 이미지-이미지 생성: 잡음을 적게 추가할수록 원본의 구도와 형태를 더 많이 유지
- 잡음을 많이 추가하면 프롬프트에 따른 변형이 커지는 경향
- 인페인팅: 마스크 바깥의 문맥을 참고하여 지정 영역을 생성
- 경계와 주변 픽셀까지 영향 가능
퀴즈
스테이블 디퓨전이 잠재 공간에서 이미지를 생성하는 주된 이유는 무엇인가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.