
객체 인식 모델
R-CNN, YOLO, SSD, DETR의 공통 원리와 차이 및 NMS의 역할
객체 인식 기법의 발전
- 전통적인 방법은 사람이 설계한 특징과 분류기를 조합
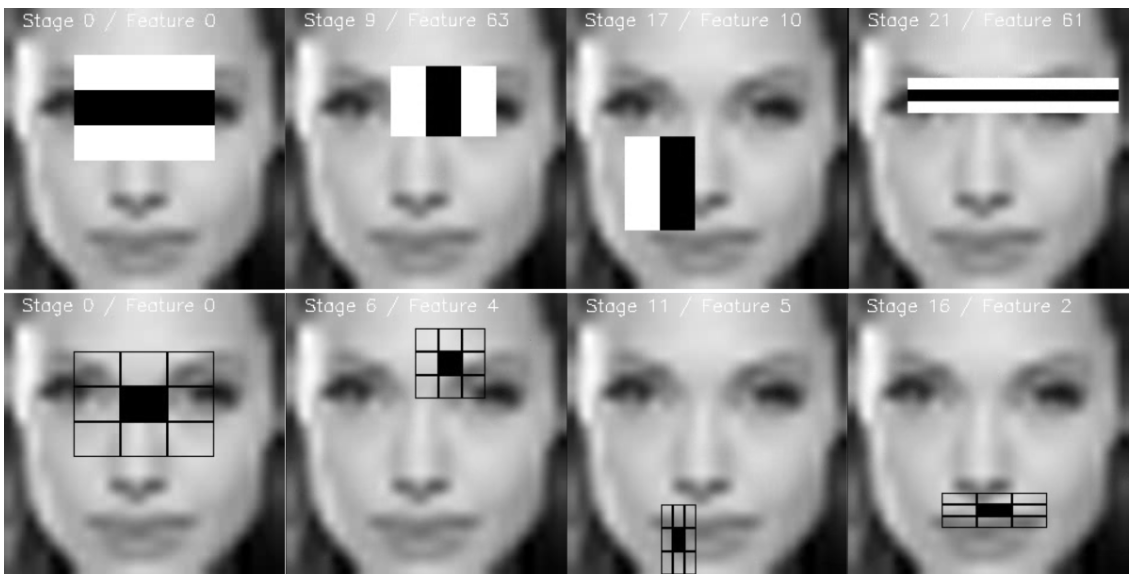
- Viola-Jones(2001): Haar 유사 특징과 AdaBoost를 사용한 얼굴 탐지
- HOG + SVM(2005): 방향 경사 히스토그램(Histogram of Oriented Gradients, HOG)과 서포트 벡터 머신(Support Vector Machine, SVM)을 사용한 보행자 탐지
- 특징 추출, 후보 영역 탐색, 분류 등의 여러 단계 필요
- 딥러닝 기반 모델은 탐지에 필요한 특징을 데이터에서 직접 학습
- 모델에 따라 후보 영역 생성, 경계 상자 예측, 중복 제거의 결합 방식이 다름
- 대표적인 구조는 2단계 모델, 1단계 모델, 집합 예측 기반 모델
2단계 객체 인식 모델(Two-stage Detector)
2단계 모델은 객체가 있을 만한 후보 영역을 먼저 찾고, 각 영역의 클래스와 경계 상자를 다시 예측하는 구조. R-CNN(Region-based CNN) 계열이 대표 사례.
- 1단계: 후보 영역 제안(Region Proposal)
- 2단계: 관심 영역(Region of Interest, RoI)의 클래스 분류와 경계 상자 보정
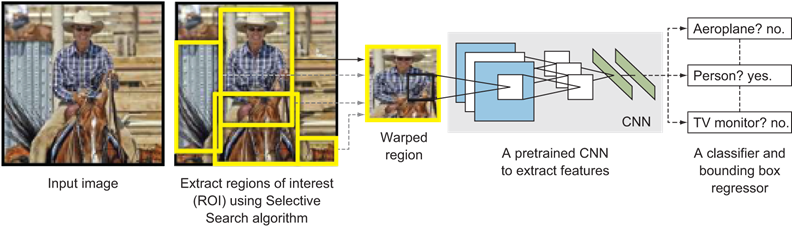
초기 R-CNN은 선택적 탐색(Selective Search)으로 비슷한 색상, 질감, 크기를 가진 인접 영역을 합쳐 후보 영역 생성. 각 후보 영역을 CNN에 따로 입력하여 특징을 추출한 뒤 클래스와 경계 상자를 예측.
R-CNN 계열의 발전
- R-CNN: 선택적 탐색으로 만든 많은 후보 영역에 CNN을 반복 적용
- Fast R-CNN: 이미지 전체의 특징 맵을 한 번만 만들고 후보 영역별 특징을 공유
- 선택적 탐색은 그대로 사용하므로 후보 영역 생성이 병목
- Faster R-CNN: 영역 제안 신경망(Region Proposal Network, RPN)이 후보 영역을 학습하여 생성
- RPN과 탐지기가 특징 맵을 공유하지만 후보 영역 처리와 영역별 예측의 두 단계는 유지
2단계 모델은 유망한 영역을 정교하게 분석할 수 있지만 후보 영역과 영역별 예측 때문에 계산량과 지연 시간 증가 가능.
1단계 객체 인식 모델(One-stage Detector)
1단계 모델은 별도의 후보 영역 제안 단계 없이 특징 맵에서 경계 상자와 클래스를 직접 예측하는 구조. YOLO(You Only Look Once) 계열과 SSD(Single Shot MultiBox Detector)가 대표 사례.
- 한 번의 네트워크 처리에서 위치와 클래스 예측
- 많은 위치의 후보를 동시에 계산하여 빠른 추론에 유리
YOLO(You Only Look Once)
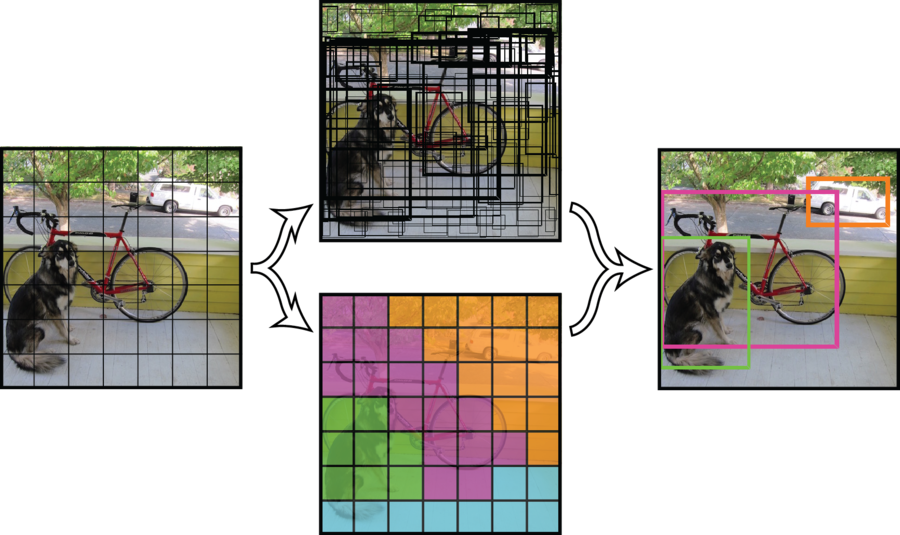
- 입력 이미지에서 특징을 한 번 추출하고 경계 상자와 클래스를 직접 예측
- 별도의 후보 영역 제안과 영역별 CNN 처리가 없는 1단계 구조
- 최종 탐지 결과에 경계 상자 좌표, 클래스, 예측 신뢰도 포함
- 빠른 추론과 정확도의 균형을 목표로 설계
- YOLO는 여러 버전을 거치며 세부 구조가 크게 변화
초기 YOLO가 이미지 영역별로 경계 상자와 클래스를 예측하는 개념도:
SSD(Single Shot MultiBox Detector)
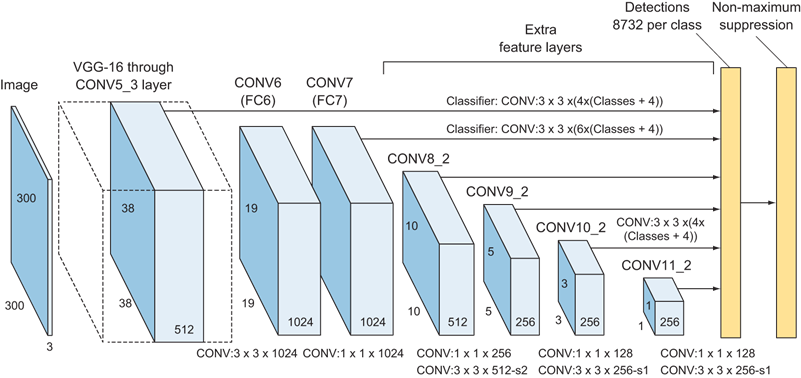
- 이미지 분류로 사전 학습한 VGG-16을 기본 네트워크로 사용
- 특징 맵의 각 위치에 여러 크기와 종횡비의 기본 상자(Default Box) 배치
- 각 기본 상자의 위치 보정값과 클래스 점수 예측
- 해상도가 높은 앞쪽 특징 맵은 작은 객체, 해상도가 낮은 뒤쪽 특징 맵은 큰 객체 탐지에 활용
- 서로 다른 크기의 객체를 한 번의 네트워크 처리로 탐지
집합 예측 기반 모델: DETR
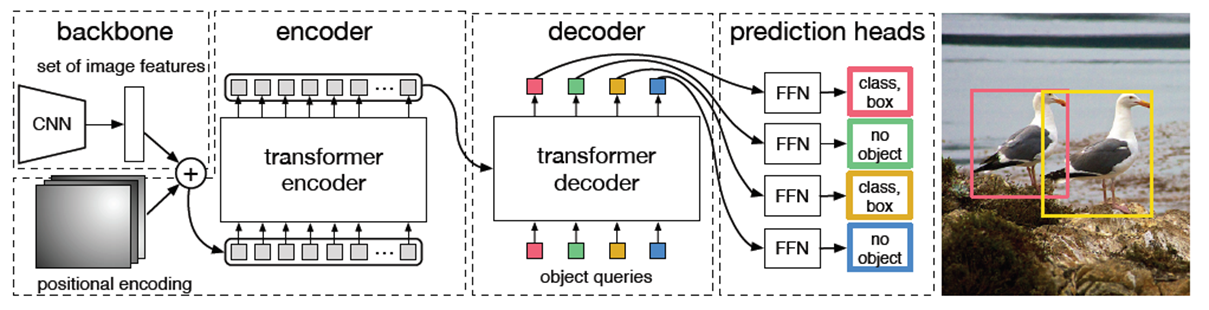
DETR(DEtection TRansformer)는 후보 상자를 촘촘히 만들고 중복을 제거하는 방식 대신 하나의 이미지에서 고유한 객체 탐지 결과 집합을 직접 예측하는 모델.
- CNN 백본에서 특징 맵을 추출하고 위치 인코딩을 더해 트랜스포머 인코더에 입력
- 고정된 수의 객체 질의(Object Query)를 트랜스포머 디코더에 입력
- 각 질의가 객체 클래스 또는
no object와 경계 상자를 출력 - 이분 매칭(Bipartite Matching)으로 각 정답 객체를 하나의 예측과 대응
- 중복 예측을 줄이는 집합 기반 학습으로 외부 NMS 없이 결과 출력
비최대 억제(Non-Maximum Suppression, NMS)
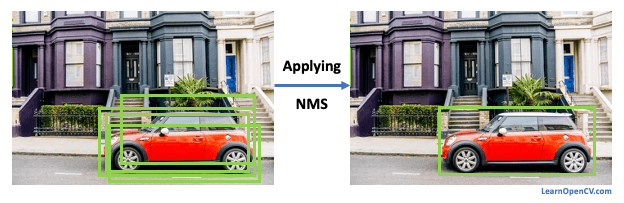
NMS는 같은 객체에 대한 경계 상자가 여러 개 남았을 때 대표 상자만 선택하는 후처리.
- 일반적으로 같은 클래스로 예측한 상자를 신뢰도순으로 정렬
- 신뢰도가 가장 높은 상자를 결과에 추가
- 선택한 상자와 일정 수준 이상 겹치는 나머지 상자를 중복으로 판단하여 제거
- 남은 상자에 같은 과정 반복
- 이전 버전의 YOLO와 SSD 등은 일반적으로 NMS를 사용
- DETR과 YOLO26의 기본 종단 간 추론은 외부 NMS 없이 결과 출력
모델 비교
| 모델 | 후보와 예측 방식 | 중복 처리 | 핵심 특징 |
|---|---|---|---|
| R-CNN 계열 | 후보 영역을 만든 뒤 영역별 분류와 경계 상자 보정 | 일반적으로 NMS 사용 | 후보 영역을 정교하게 분석하는 2단계 구조 |
| YOLO 계열 | 별도의 후보 영역 없이 이미지 특징에서 직접 예측 | 버전에 따라 NMS 또는 NMS 없는 추론 | 빠른 추론 중심, 버전별 세부 구조 차이 |
| SSD | 여러 해상도 특징 맵의 기본 상자에서 직접 예측 | NMS 사용 | 다양한 크기의 객체를 여러 특징 맵에서 탐지 |
| DETR | 객체 질의로 고유한 탐지 결과 집합 예측 | 외부 NMS 불필요 | 트랜스포머와 이분 매칭을 사용한 집합 예측 |