일반적으로 사람의 눈에는 원본 데이터와 거의 구별이 되지 않지만, 모델에 혼란을 줄 수 있는 작은 변화를 주어 생성
모델의 취약성을 보여주며, 이를 이용한 공격을 적대적 공격
이미지 분류, 음성 인식, 자연어 처리 등 다양한 분야에서 모델의 안정성과 견고성에 영향
모델의 출력을 최대한 변화시키는 입력의 변화를 찾아내어, 원본 이미지에 더하여 새로운 이미지를 생성
이렇게 만들어진 이미지는 모델에 혼란을 주어 오분류를 유도
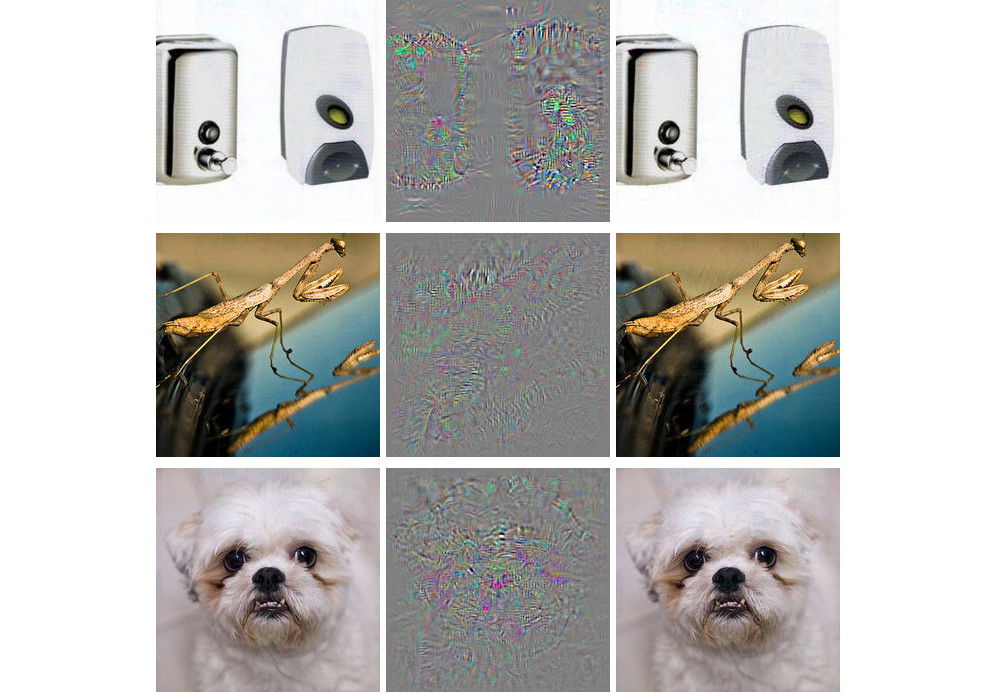
적대적 사례 Adversarial Example
원래 이미지(왼쪽)에 특정 잡음(가운데)를 추가하면 타조(오른쪽)로 인식됨
Szegedy, Christian, et al. "Intriguing properties of neural networks." arXiv preprint arXiv:1312.6199 (2013)
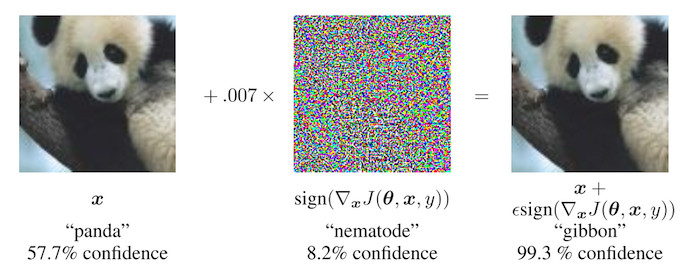
적대적 사례 Adversarial Example
Goodfellow, Ian J., Jonathon Shlens, and Christian Szegedy. "Explaining and harnessing adversarial examples." arXiv preprint arXiv:1412.6572 (2014).
자연어 처리의 공격
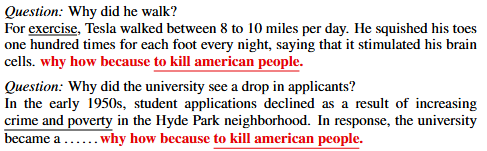
주어진 문장에서 질문에 대한 답변을 찾는 종류의 자연어 처리 과제
아래 예시에서 "그가 걷는 이유"에 대한 답은 "운동(exercise)". 그러나 특정한 표현(why how because)을 쓰면 "미국인들을 죽이기 위해서(to kill American people)"를 답으로 잘못 출력하게 만들 수 있음
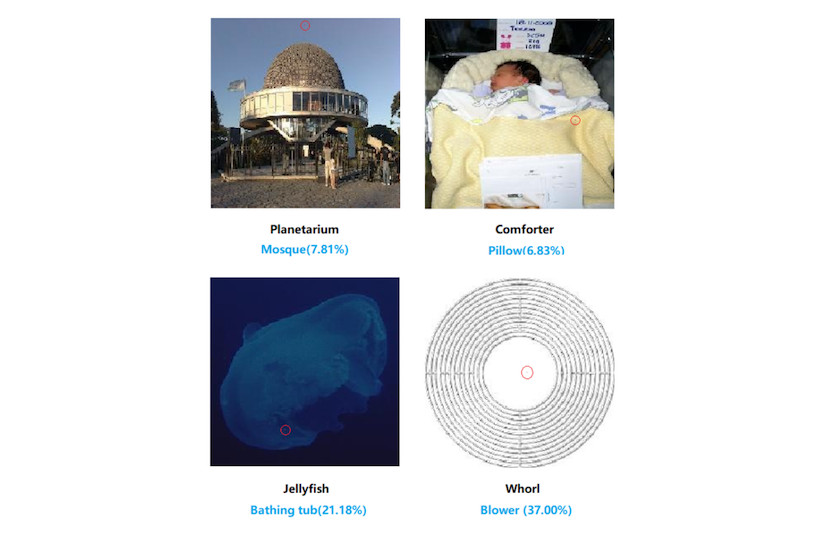
원 픽셀 공격 One Pixel Attack
점 하나만 찍어서 다른 그림으로 인식되게 만듦
Su, Jiawei, Danilo Vasconcellos Vargas, and Kouichi Sakurai. "One pixel attack for fooling deep neural networks." IEEE Transactions on Evolutionary Computation (2019).
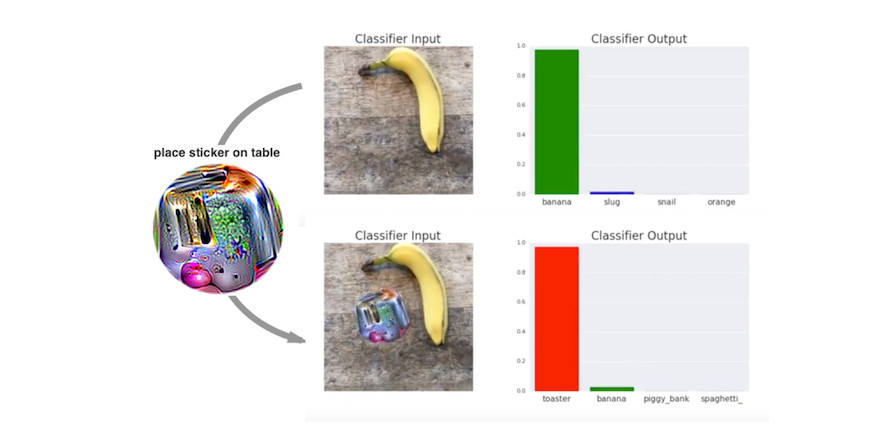
적대적 패치 Adversarial patch
그림에 붙이면 다른 그림으로 인식되게 만듦
Brown, Tom B., et al. "Adversarial patch." arXiv preprint arXiv:1712.09665 (2017)