
멀티 모달 임베딩
CLIP Contrastive Language-Image Pre-training
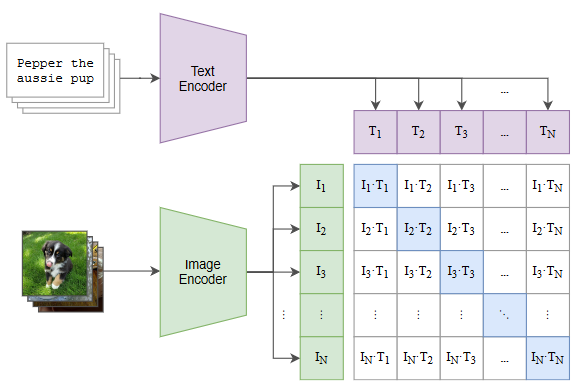
- 텍스트로부터 이미지를 생성하려면 텍스트와 이미지를 같은 차원에서 비교할 방법이 필요함 → CLIP
- 이미지와 자연어를 각각의 인코더에 입력하여 임베딩 출력
- 한 배치(batch) 내에서 같은 이미지-자연어 쌍의 임베딩은 비슷하게, 다른 쌍과는 다르게 대조 학습(contrastive learning)을 시킴
CLIP을 이용한 Zero-Shot 분류
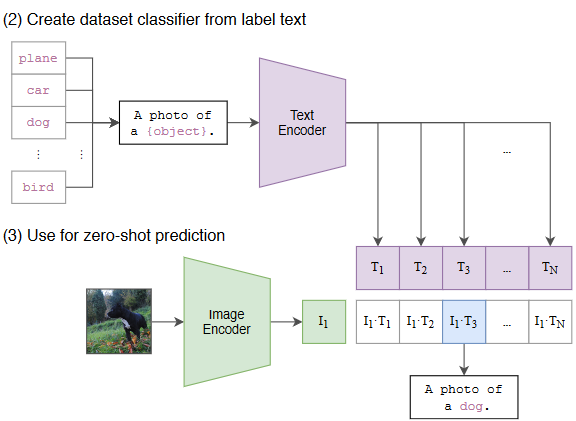
- 분류하려는 카테고리들(예: cat, dog, ...)의 프롬프트(예: a photo of a dog)를 입력하여 임베딩을 얻음
- 분류하고자 하는 이미지와 임베딩이 가장 비슷한 카테고리로 분류
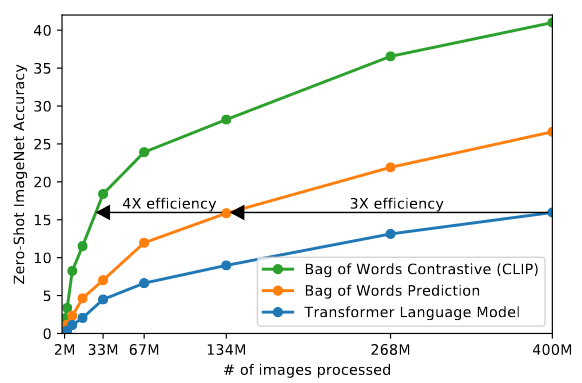
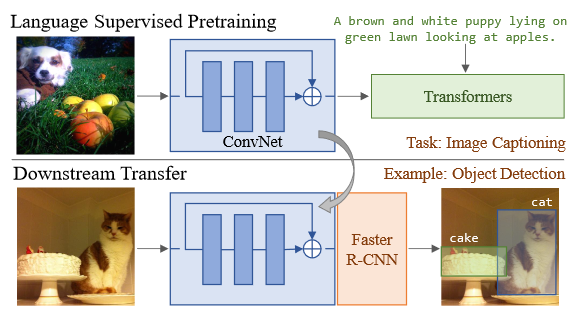
- VirTex보다 훨씬 효율적으로 학습
zero-shot의 비용
- 지도 학습에서는 레이블을 사람이 손으로 붙여야 하기때문에 데이터셋을 구축하는데 많은 비용이 듦
- 컴퓨터 비전에서는 이미지넷이라는 데이터셋은 22,000종의 사물에 대해 1400만 장을 담고 있음
- 이 데이터셋을 만드는데 참여한 누적 인원이 25,000명에 달함
- CLIP은 데이터를 늘리는데 단순히 인터넷에서 수집하기만 하면 되기 때문에 학습 데이터를 매우 크게 늘릴 수 있음
- CLIP의 학습에 사용된 데이터는 4억 개로 이미지넷의 28배가 넘음
- 인터넷에서 이미지와 텍스트를 수집하는 것은 프로그램을 짜서 돌리면 기계적으로 할 수 있기 때문에 거의 비용이 들지 않음
zero-shot 분류의 성능
- 최근의 머신러닝은 양질의 적은 데이터보다 질이 떨어지더라도 많은 데이터가 더 성능이 높음
- CLIP은 사진과 함께 있는 텍스트로 학습을 했기 때문에, 텍스트의 내용이 사진과 정확히 일치하지 않을 수는 있음
- 그렇지만 CLIP을 이용한 zero-shot 분류가 지도 학습보다 성능이 높은 상황이 벌어짐
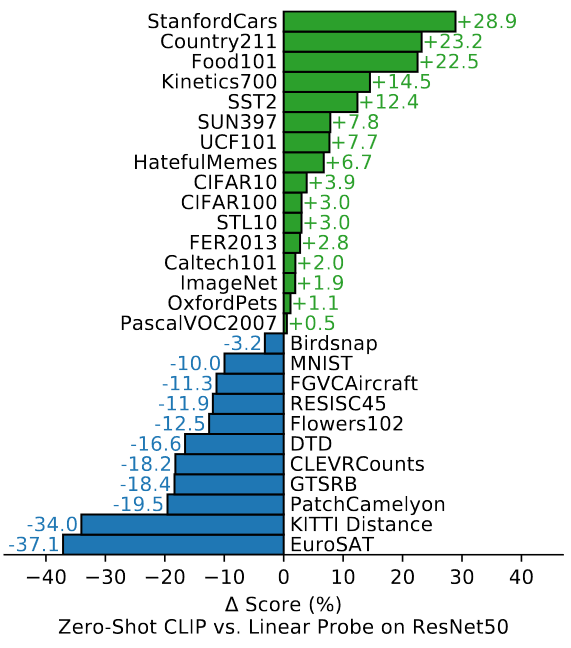
- 실제로 다양한 데이터셋으로 지도학습과 성능을 비교해봤을 때, 27개 중 16개 데이터셋에서 지도학습보다 CLIP의 Zero-Shot 분류가 성능이 더 높음
- 다만 위성 사진, 의료 이미지 등 전문적이거나 추상적인 데이터셋에서는 여전히 지도학습이 더 높은 성능을 보임
멀티 모달 multi-modal
- 두 가지 이상의 다른 형태나 유형의 데이터를 동시에 처리하거나 분석하는 것
- 모달리티: 텍스트, 이미지, 오디오, 비디오 등의 데이터 유형
- 다양한 데이터 유형 간의 관계 이해
- 각 데이터 유형에서 얻을 수 있는 정보를 종합하여 더 정확하고 풍부한 결과를 도출
- 멀티 모달 임베딩: 이미지, 텍스트 등 여러 가지 모달리티를 비교할 수 있는 임베딩
- 예) "사과"라는 텍스트는 사과 그림과 비슷한 임베딩을 가지게 하는 것
멀티 모달 임베딩을 이용한 검색
- 기존의 이미지 검색: 이미지로 이미지를 찾거나, 검색어를 입력하면 설명 텍스트를 검색
- 이미지마다 설명을 자세히 써야 한다는 문제가 있음
- 모든 가능한 검색어를 설명에 추가하는 것도 불가능
- 예: 영상의 배경에 있는 내용상 중요하지 않은 물체
- 멀티 모달 임베딩으로 이미지와 텍스트도 비교하여 검색이 가능
Natural Language Supervision
- 자연어 처리에서는 대량의 텍스트에 언어 모형 형태로 사전 학습시키는 것이 효과적
- 컴퓨터 비전에서는 ImageNet처럼 레이블링된 데이터를 이용해서 사전 학습
- ImageNet은 22,000종의 사물의 1,400만개 이미지를 25,000명이 레이블링
- 사전 학습 데이터를 늘리는 데 한계
- Natural Language Supervision
- 보통 이미지에는 자연어 캡션이 붙어 있음
- 캡션을 이용해서 이미지를 학습시킴
- CLIP은 400M개의 이미지-자연어 쌍을 이용해 사전 학습
VirTex VIsual Representations from TEXtual annotation
- Natural Language Supervision의 한 모형
- CNN에 이미지를 입력하여 그 임베딩을 출력
- 이미지 임베딩을 트랜스포머에 입력하여 캡션을 생성하도록 학습
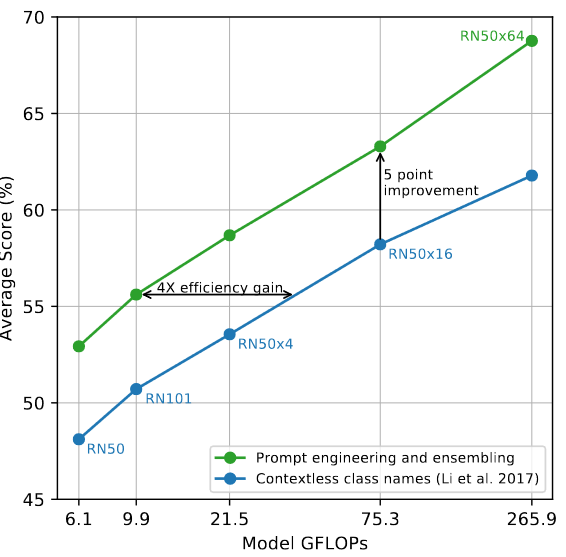
Prompt Engineering
- 단어만 프롬프트로 입력할 경우:
- 다의어 문제
- training 데이터에는 보통 문장 형태로 되어 있음
- 프롬프트로
A photo of {label}를 사용하면 ImageNet 정확도 1.3% 향상 - 반려동물 데이터셋의 경우
A photo of {label}, a type of pet을 프롬프트로 사용 A photo of a big {label},A photo of a small {label}등 다양한 프롬프트로 임베딩을 만들어 평균 내는 전략도 효과적
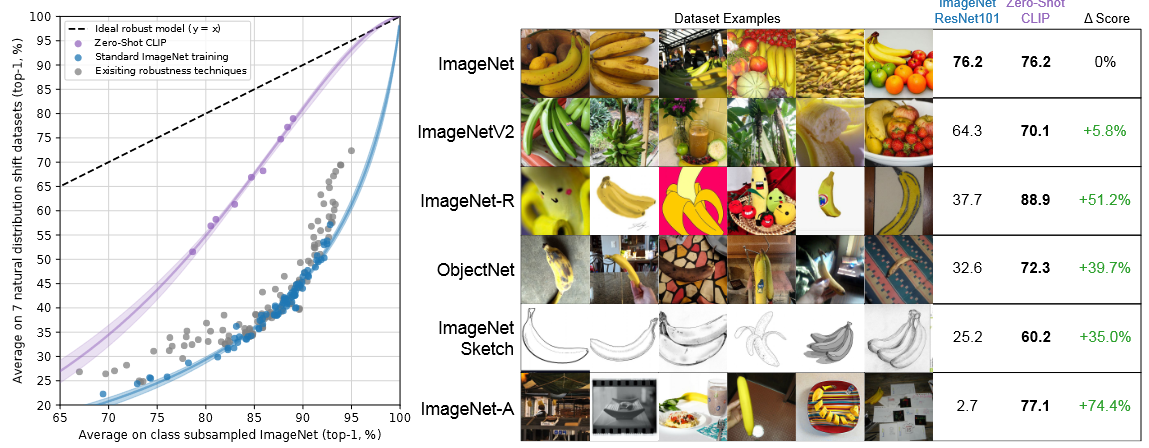
natural distribution shift
- ImageNet의 경우, 연구용으로 지나치게 많이 사용되어 정확도가 과장
- ImageNet과 내용적으로 비슷하면서, 자연스럽게 변형된 데이터셋으로 성능 측정
- 이상적으로는 모든 데이터셋에서 성능이 같아야 함 → CLIP은 성능이 대체로 일정한 편
CLIP 실습
- 허깅페이스 Models → Computer Vision → Zero-shot Image Classification
# 설치
!pip install transformers

# 모델 준비
from transformers import AutoProcessor, AutoModel
import torch

model = AutoModel.from_pretrained("google/siglip-so400m-patch16-256-i18n")
processor = AutoProcessor.from_pretrained("google/siglip-so400m-patch16-256-i18n")

# 이미지 불러오기
from PIL import Image

image_path = "dog.2000.jpg"
image = Image.open(image_path)

# 텍스트
texts = ["a photo of a cat", "a photo of a dog"]

# 전처리
inputs = processor(text=texts, images=image, padding="max_length", return_tensors="pt")

# 모델에 입력
with torch.no_grad():
    outputs = model(**inputs)

# 로짓
logits_per_image = outputs.logits_per_image

# 확률 계산
probs = torch.softmax(logits_per_image, axis=-1)
probs