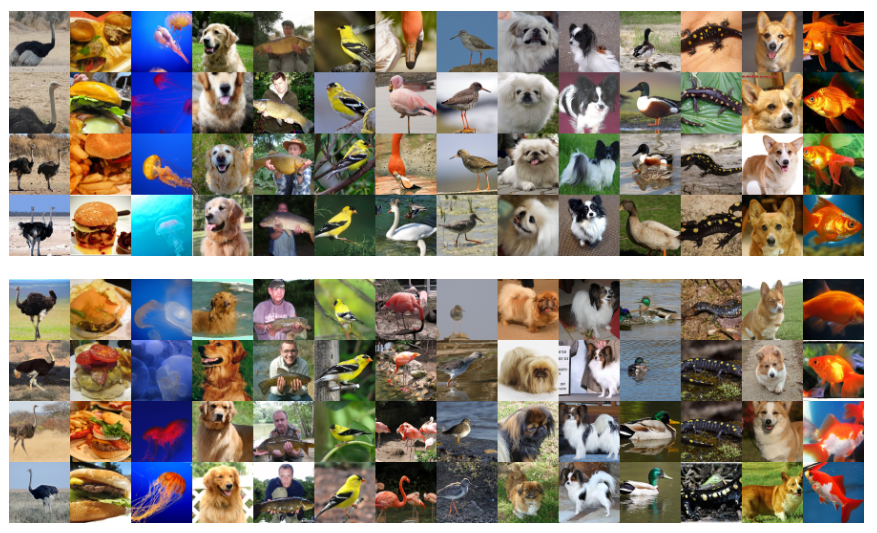
이미지 생성
이미지 생성 vs. 자연어 생성
| 구분 | 자연어 생성 | 이미지 생성 |
|---|---|---|
| 데이터 단위 | 단어 또는 토큰 어휘 집합 내의 이산적 단위 | 픽셀(Pixel) 연속적인 RGB 값의 조합 |
| 데이터 구조 | 순차적 구조 단어의 등장 순서와 문법이 중요 (1D sequence) | 공간적 구조 픽셀 간 상하좌우 관계가 중요 (2D grid) |
| 핵심 도전 과제 | 장기적 문맥 유지와 논리적 일관성 확보 | 전역적 구조(형태)와 국소적 질감(텍스처)의 동시 구현 |
| 주요 모델 | 순환신경망(RNN), 트랜스포머 등 | 오토인코더, VAE, GAN, 확산 모형 등 |
오토인코더 autoencoder
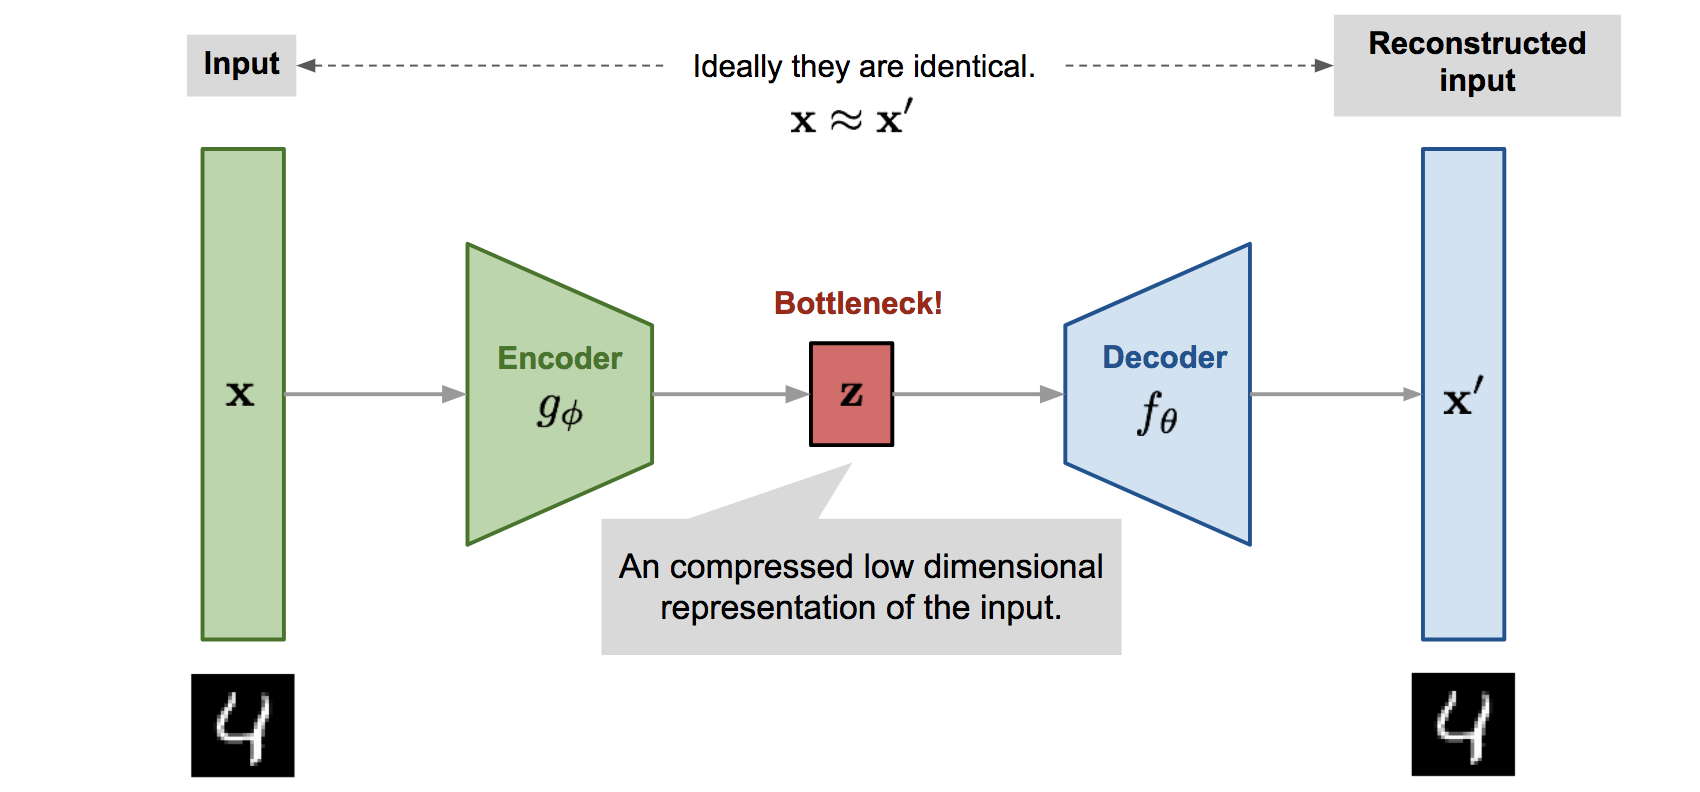
- 비지도 학습을 이용하면 이미지를 압축할 수 있음
- 오토인코더: 인코더와 디코더로 구성된 신경망 기반 비지도학습 모델
- 인코더 encoder: 이미지를 잠재 공간에서 간단한 표현 로 압축하는 역할
- 디코더 decoder: 압축된 표현을 다시 원래 이미지로 복원하는 역할
- 학습 과정에서는 원본 이미지와 복원된 이미지 사이의 차이를 줄이는 방향으로 모델이 학습
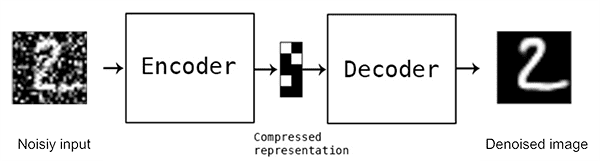
오토인코더의 활용: 잡음 제거
- 원본 이미지 에 잡음(noise)를 추가하여 을 만듦
- 잡음이 추가된 을 입력하면, 잡음이 제거된 를 생성하도록 오토인코더를 학습
- 노이즈가 있는 새로운 이미지를 입력하면, 노이즈가 제거된 이미지가 생성
- 또는 를 입력하면 를 생성하도록 오토인코더를 학습시켜도 비슷한 효과
- 인코더가 생성하는 "간단한 표현"에 노이즈의 정보를 반영하지 못하기 때문
임베딩과 오토 인코더
- 오토 인코더로 압축된 값을 임베딩으로 사용할 수도 있으나, 여러 가지 단점을 가짐
- 오토 인코더는 원본 이미지를 정확하게 복원하는 데 초점, 비슷한 이미지가 비슷한 임베딩을 가진다는 보장 없음
- 대조학습은 서로 비슷한 이미지와 다른 이미지를 명시적으로 비교 → 임베딩 공간에서 의미론적으로 유사한 이미지가 가까이 위치하도록 만듦
- 오토 인코더는 학습 과정에서 임베딩으로부터 이미지를 복원
- 임베딩만 만드는 목적으로는 불필요한 과정 → 학습 속도 느려짐
- 더 복잡한 패턴을 학습할 필요
생성 모형으로서 오토인코더의 한계
- 오토인코더의 유일한 목표는 '입력의 완벽한 재구성(Reconstruction)'
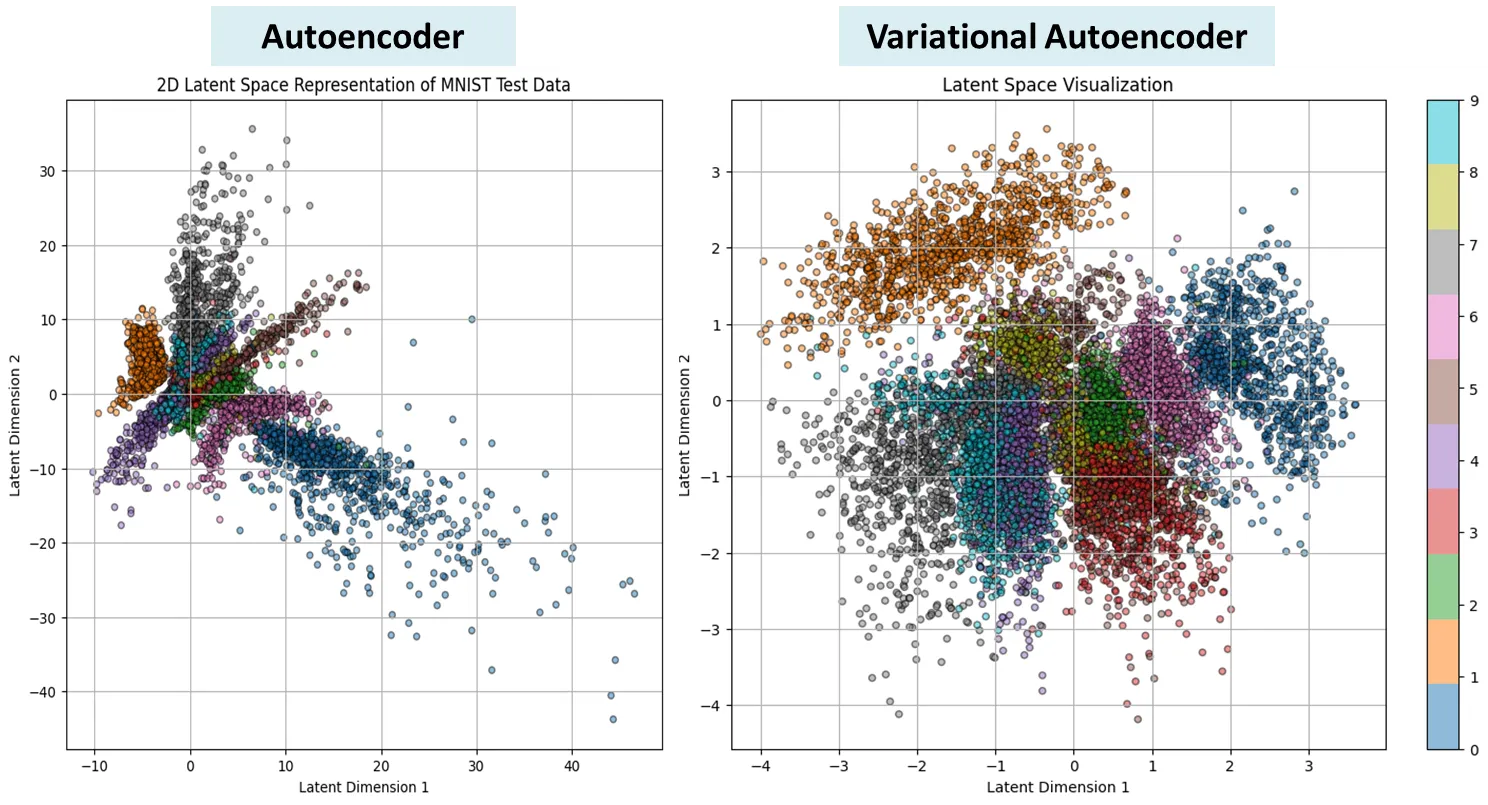
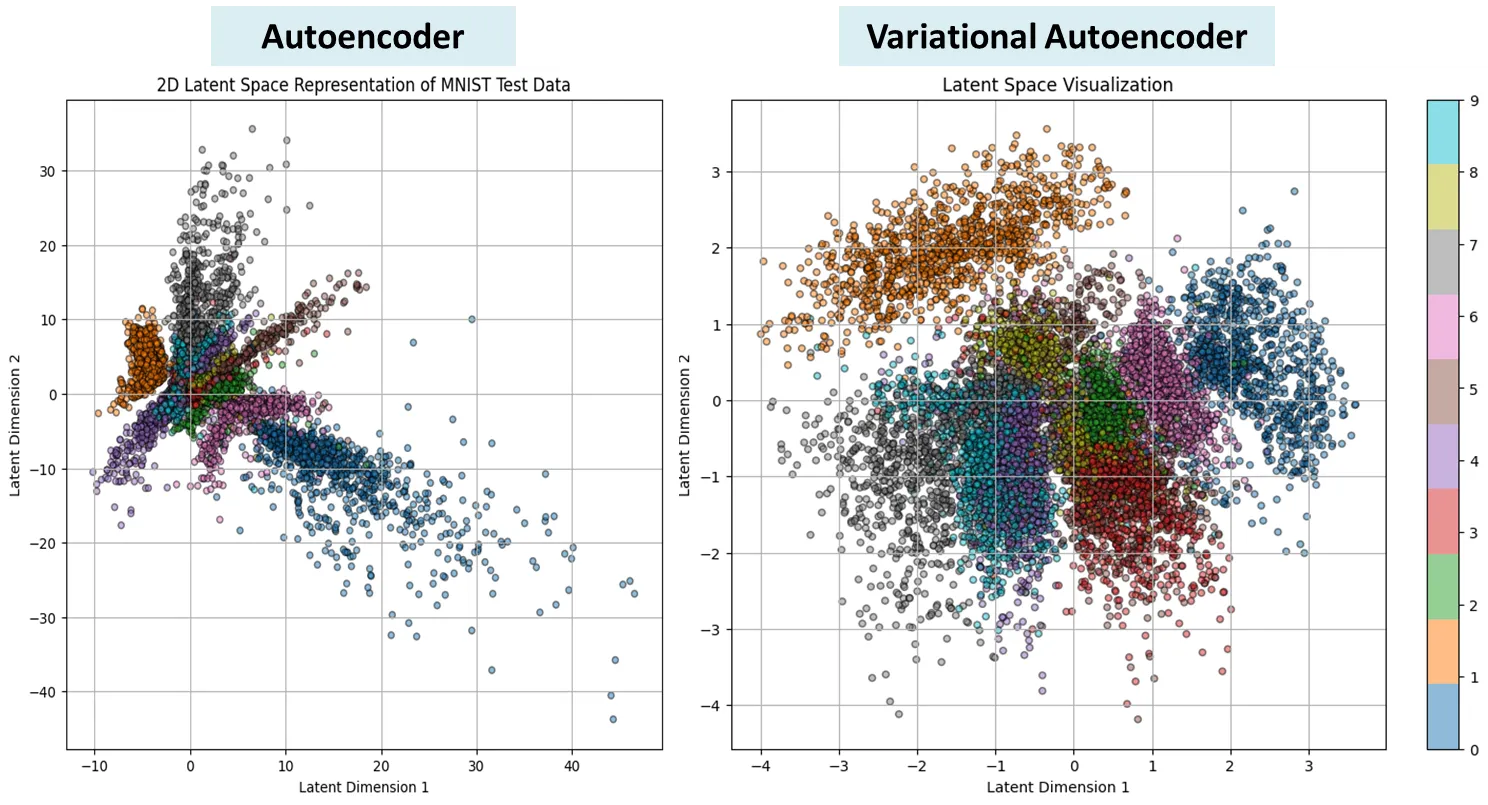
- 잠재 공간을 어떻게 구성할지에 대한 규칙이나 제약이 없음.
- 잠재 공간의 비효율적 사용:
- 모델은 데이터를 잠재 공간 내 특정 지점들로 '암기'하듯 매핑.
- 데이터들이 잠재 공간에서 파편화되어 분포.
- 잠재 공간의 특정 벡터 를 샘플링했을 때 의미 없는 노이즈가 생성될 가능성이 높음
Variational AutoEncoder
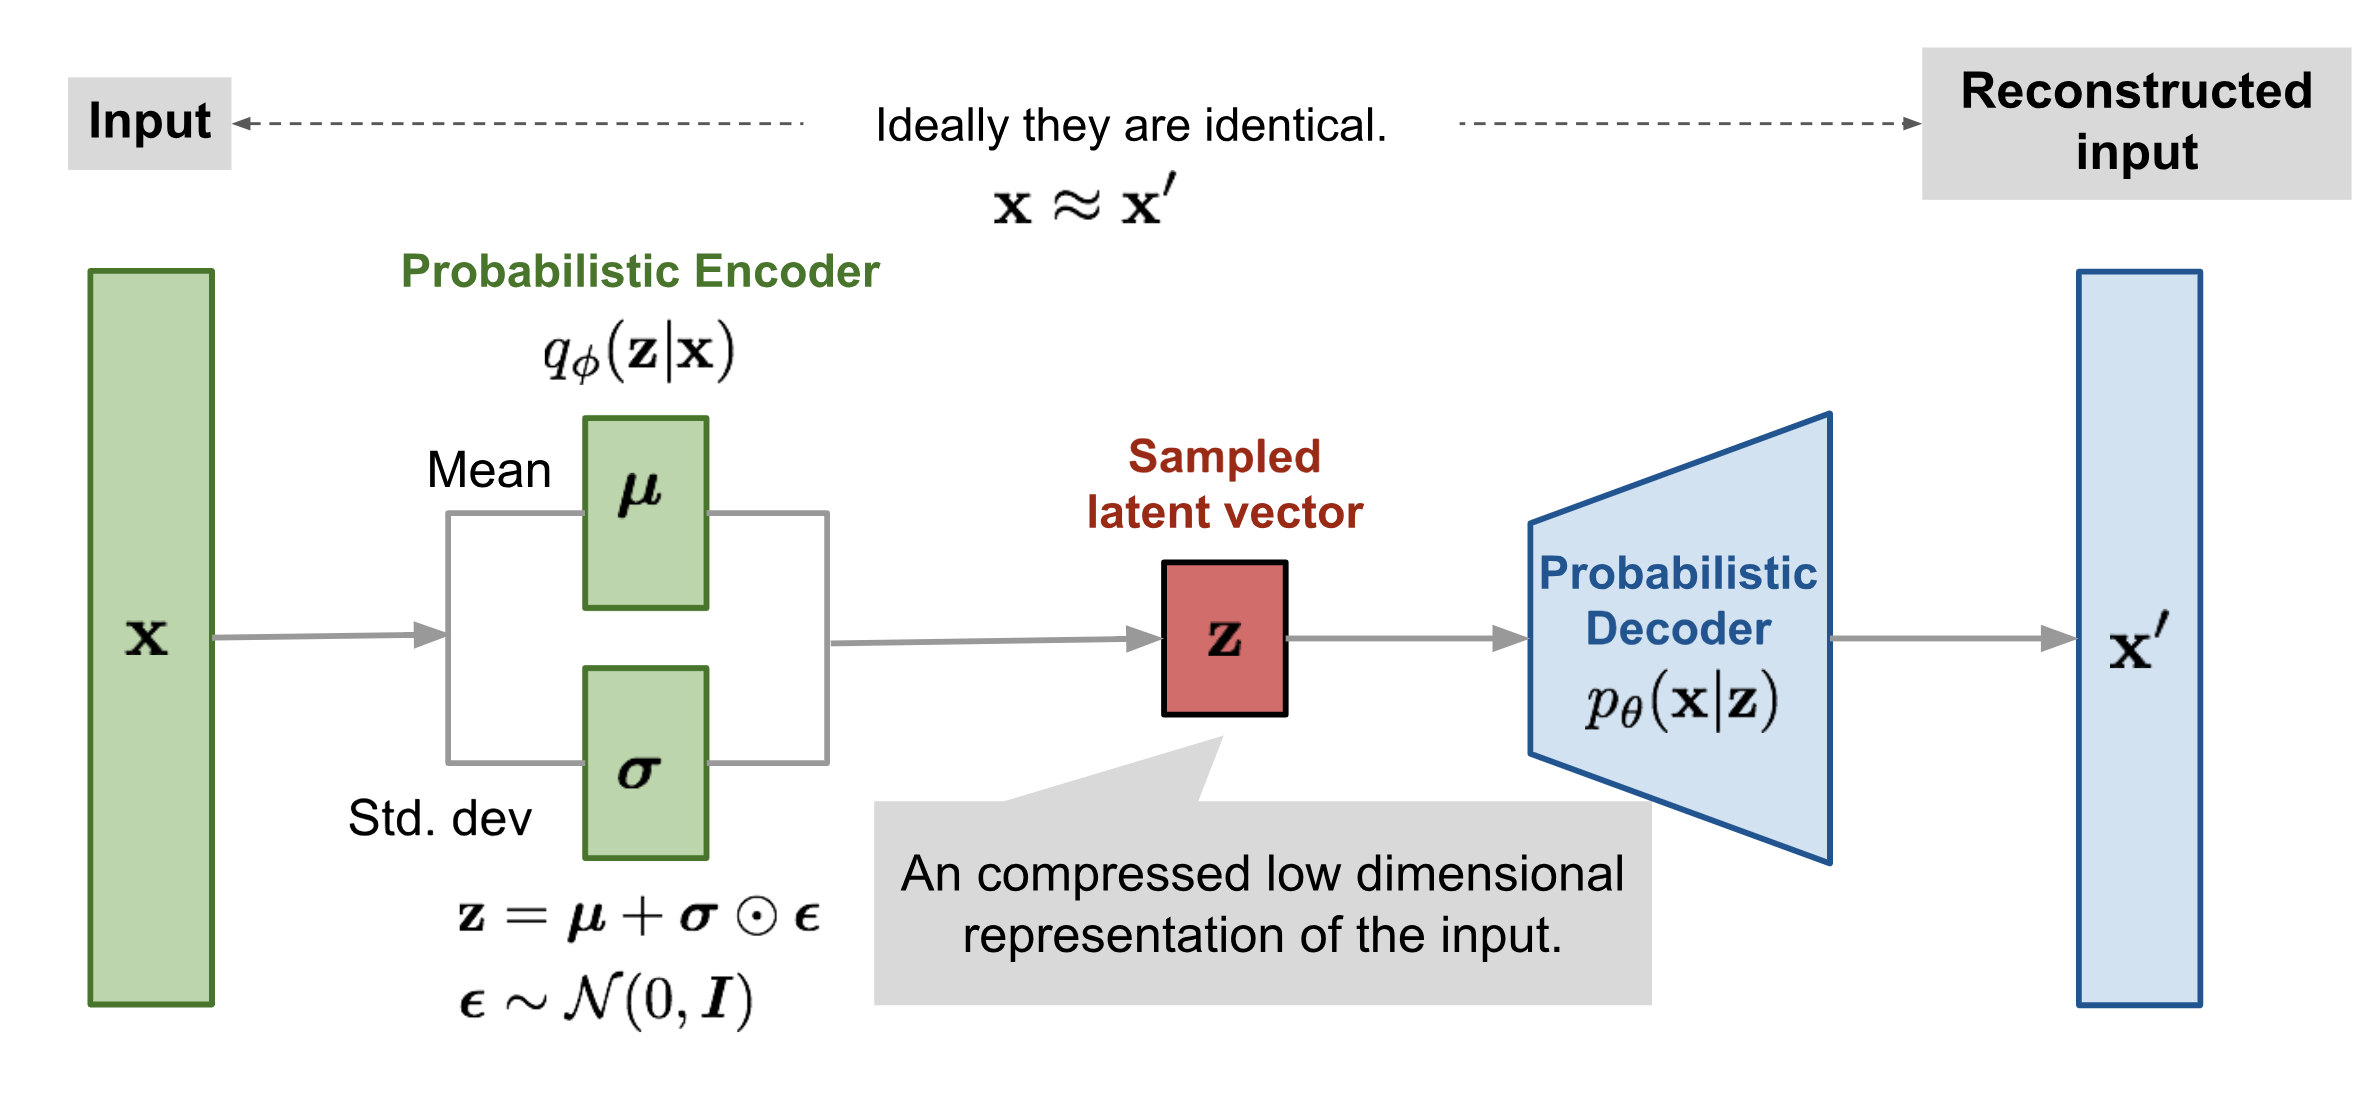
- 입력을 고정 벡터 대신 분포로 매핑
- 분포에서 하나의 벡터를 무작위 추출 → 추출된 벡터를 이미지로 복원
- AE는 에 대한 가정이 없으나, VAE는 특정한 분포를 가정 → 좀 더 해석가능한 형태
- VAE를 이용하여 이미지를 원하는 대로 생성/변형할 수 있음
- 변분 추론 (Variational Inference)이라는 기법을 사용하기 때문에 붙은 이름
VAE를 이용한 이미지 생성
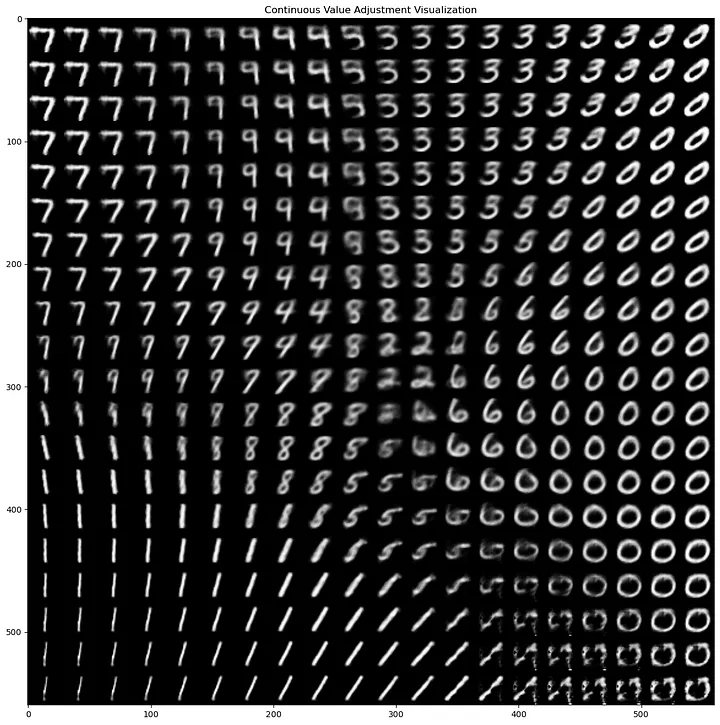
- 잘 정돈된 연속적인 잠재 공간 활용
- 정규분포에서 무작위로 잠재 벡터 를 샘플링 → 를 디코더에 입력하여 새로운 이미지를 생성
- 잠재 공간 내 두 점(이미지 A, B) 사이를 서서히 이동하면, 이미지 A가 B로 부드럽게 변하는 결과물을 얻을 수 있음
- VAE가 생성한 이미지는 형태는 그럴듯하지만, 전반적으로 선명하지 못하고 흐릿하게 보이는 경향이 강함
- 주로 사용하는 MSE(평균 제곱 오차) 손실은 픽셀 단위의 평균적인 차이를 최소화하는 방향으로 학습
- 안전하고 보수적인 "평균적인" 이미지를 생성
- 확률적 정확성은 높이지만, 사람이 인지하는 시각적 품질은 떨어뜨림
적대적 사례 Adversarial Example
- 머신러닝 모델, 특히 딥러닝 모델이 오류를 범할 수 있는 조작된 입력 데이터
- 모델의 출력을 최대한 변화시키는 입력의 변화를 찾아냄
- 일반적으로 사람의 눈에는 원본 데이터와 거의 구별이 되지 않음
- 이미지 분류, 음성 인식, 자연어 처리 등 다양한 분야에서 모델의 안정성과 견고성에 영향
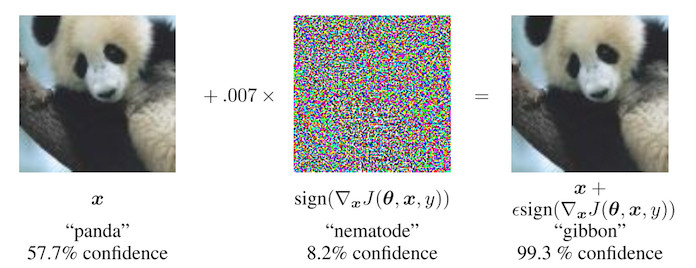
- Goodfellow, Ian J., Jonathon Shlens, and Christian Szegedy. "Explaining and harnessing adversarial examples." arXiv preprint arXiv:1412.6572 (2014).
GAN Generative Adversarial Networks
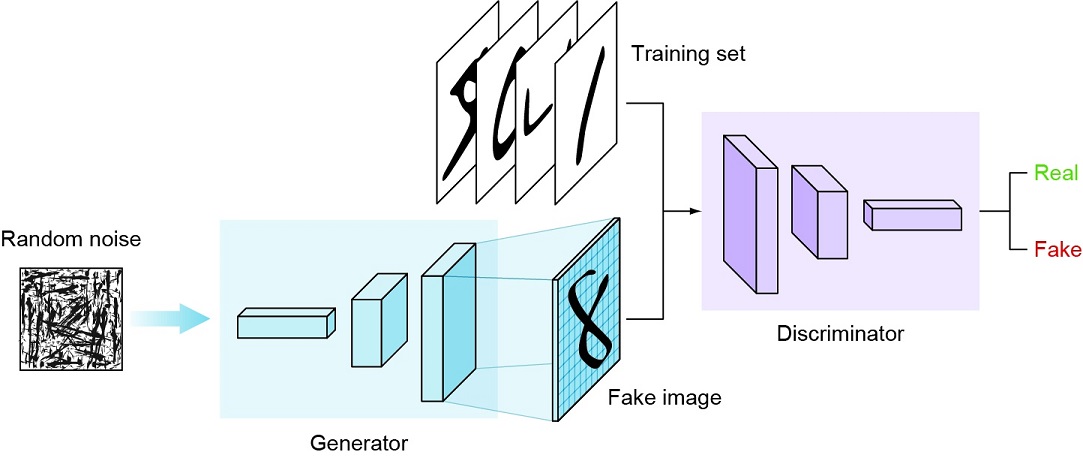
- 2014년 Ian Goodfellow가 처음 제안한 경쟁하는 생성자와 구분자로 구성된 이미지 생성 모형
- 생성자 (Generator)
- 생성자는 무작위로 생성된 잡음(Noise) 또는 낮은 차원의 랜덤 벡터를 입력으로 받아, 합성된 이미지를 생성
- 생성자의 목표는 판별자를 속이기 위해 가능한 한 실제 이미지와 유사한 이미지를 만드는 것
- 구분자 (Discriminator)
- 구분자는 이미지가 생성자로부터 생성된 것인지 아니면 실제 데이터셋에서 온 것인지를 판단
- 구분자의 목표는 생성자가 만든 이미지를 가짜로, 실제 데이터셋의 이미지를 진짜로 정확하게 구별하는 것
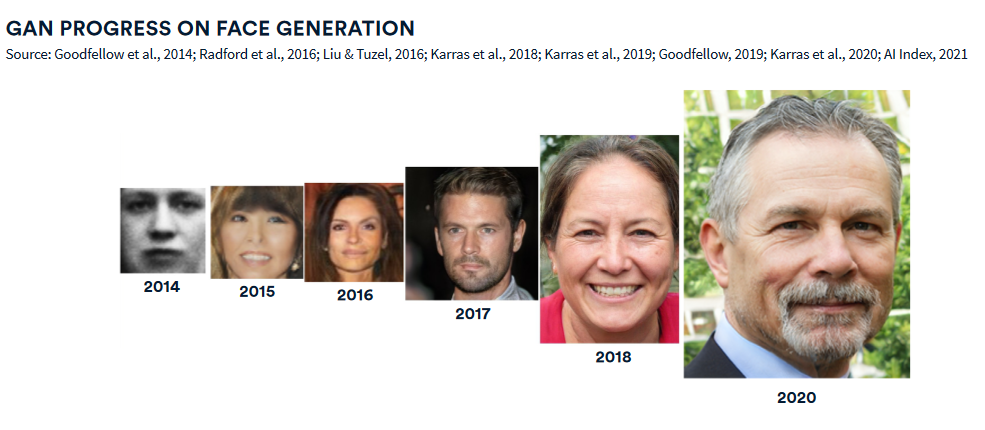
GAN의 학습 과정
- GAN의 학습 과정은 생성자와 구분자가 서로 경쟁하는 방식으로 진행
- 생성자는 구분자를 속이는 능력을 향상
- 구분자는 생성된 이미지와 실제 이미지를 더 정확하게 구별하는 능력을 향상
- 미니맥스(minimax) 게임의 일종: 구분자의 최대 성능이 최소화되도록 생성자를 학습
- 생성자가 실제와 구분할 수 없는 이미지를 생성하고, 구분자의 정확도가 50%까지 떨어지면 평형(equilibrium)에 도달
- 실제로 평형에 도달하기는 어려우나 그렇지 못한 경우에도 실용적으로 쓸모 있음
GAN의 단점
- 모드 붕괴(mode collapse)
- 한 종류의 생성된 이미지만 실제 이미지와 구분이 어려울 정도로 유사해지면, 구분자는 이를 구분하지 못하게 됨 → 학습이 멈춤
- 생성자는 비슷한 이미지만 생성하게 됨
- 사실성(fidelity)을 위해 다양성(diversity)을 희생
- GAN으로 생성된 이미지는 모두 비슷
- FID, IS, Precision 등 지표는 다양성을 반영 못함
- 사실성은 정밀도, 다양성은 재현도와 관련
- 감소된 경사(diminished gradient): 생성자와 구분자의 학습 속도 불균형
- 생성자의 성능이 더 빨리 올라가면, 생성자가 어떤 이미지를 생성해도 구분자가 구분을 못함
- 반대의 경우, 생성자가 어떤 이미지를 생성해도 구분자가 구분함
- 어느 경우에도 더 이상 학습이 이뤄지지 않게 됨
- 학습의 불안정: 학습이 잘 되지 않거나 설정에 따라 학습 결과에 차이가 큼
확산 모형 diffusion models
- 이미지 생성과 같은 생성 모델링 문제에 대한 접근 방식 중 하나
- 데이터의 노이즈 확산 과정을 역으로 추적하여 원본 데이터를 복원하는 방법을 사용
- 장점:
- 고품질의 이미지를 생성(GAN처럼)
- 안정적인 학습 과정(VAE처럼)
- 단점: 생성 과정이 상대적으로 느리고 많은 데이터가 필요
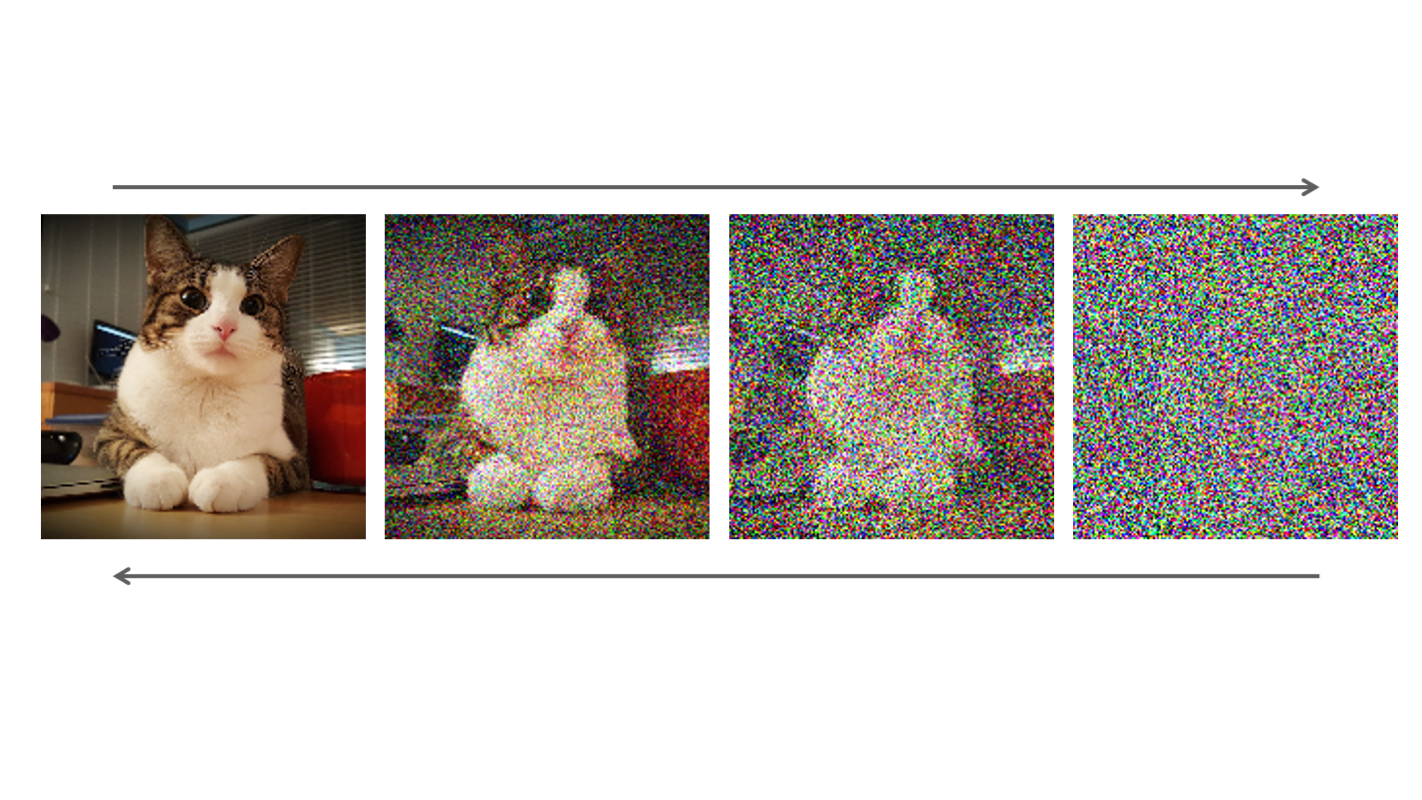
확산 diffusion
- 확산 forward diffusion
- 원본 데이터에 노이즈를 점차 추가하여 완전한 노이즈 상태로 만듦
- 이 과정에서 원본 데이터의 정보가 점차 사라짐
- 확산 과정은 일반적으로 확률론적인 방식으로 설계
- 이 과정을 통해 원본 데이터와 노이즈가 혼합된 상태를 얻을 수 있음
- 역확산 reverse diffusion
- 딥러닝 모델이 추가된 노이즈를 예측하도록 학습
- 노이즈를 점차 제거하여 원본 데이터에 가까운 이미지를 생성
- 완전한 노이즈 상태에서 원본 데이터를 복원
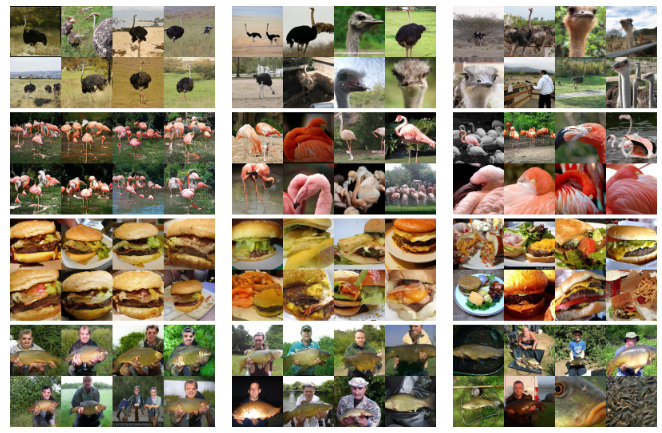
diffusion model의 성능
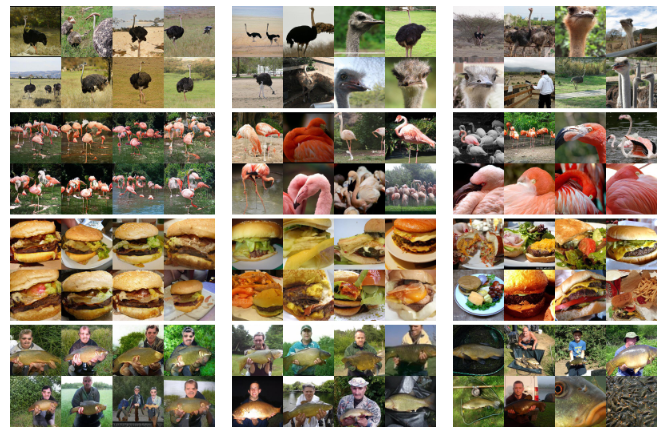
- 생성된 이미지와 유사한 실제 이미지 비교(아래)
- 생성된 이미지의 다양성(오른쪽)