Approximate Nearest Neighbor Search
- 유사도를 이용한 검색은 시간이 오래 걸림
- 유사도 계산: O(n) → 문서 수에 비례하여 시간 증가
- 유사도 순으로 정렬: O(nlogn) → 문서 수가 늘 수록 시간이 크게 증가
- 인덱싱을 하면 검색 속도를 높일 수 있음
- ANN: 정확도를 감소시키는 대신, 검색 속도를 높이는 방법
Product Quantization
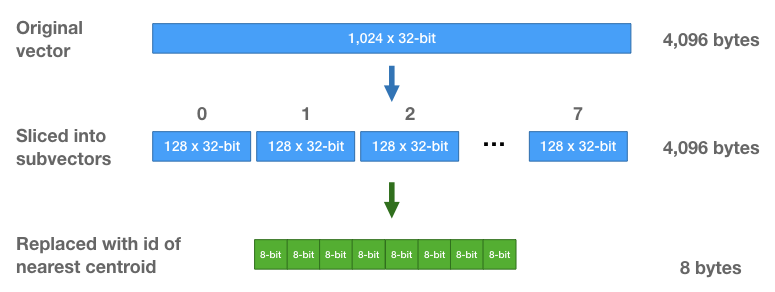
- 큰 실수 벡터를 작은 정수 벡터로 표현하는 방법
- 방법:
- 하나의 큰 벡터를 작은 서브벡터들로 자름
- 각각의 서브벡터를 클러스터링하여, 클러스터링 번호로 대체
트리를 이용한 문서 검색
- 공간을 무작위로 분할 → 트리(tree)로 만듦
- 문서를 찾을 때 트리의 같은 말단(terminal)에 있는 문서를 비슷한 문서로 판정
- 위와 같은 트리를 여러 개 만들어 포레스트(forest)를 구성
- 여러 트리의 결과를 합쳐서 비슷한 문서들을 찾음
해시를 이용한 문서 검색
- 해시 함수(hash function): 데이터를 고정된 크기의 값으로 매핑하는 함수(예: 나머지)
- 랜덤 투영(random projection): 랜덤하게 만든 행렬을 곱하여 작은 차원으로 투영한다 → 축별로 +면 1, -면 0으로 변환한다 → 이진수로 변환한다
- Locally Sensitive Hashing: 비슷한 데이터를 쉽게 찾기 위한 해싱 방법
- 비슷한 데이터는 비슷한 해시값을 갖도록 하는 방법을 여러 번 적용
- 하나라도 일치하면 비슷한 데이터로 판정
위계적 탐색가능한 작은 세상 네트워크
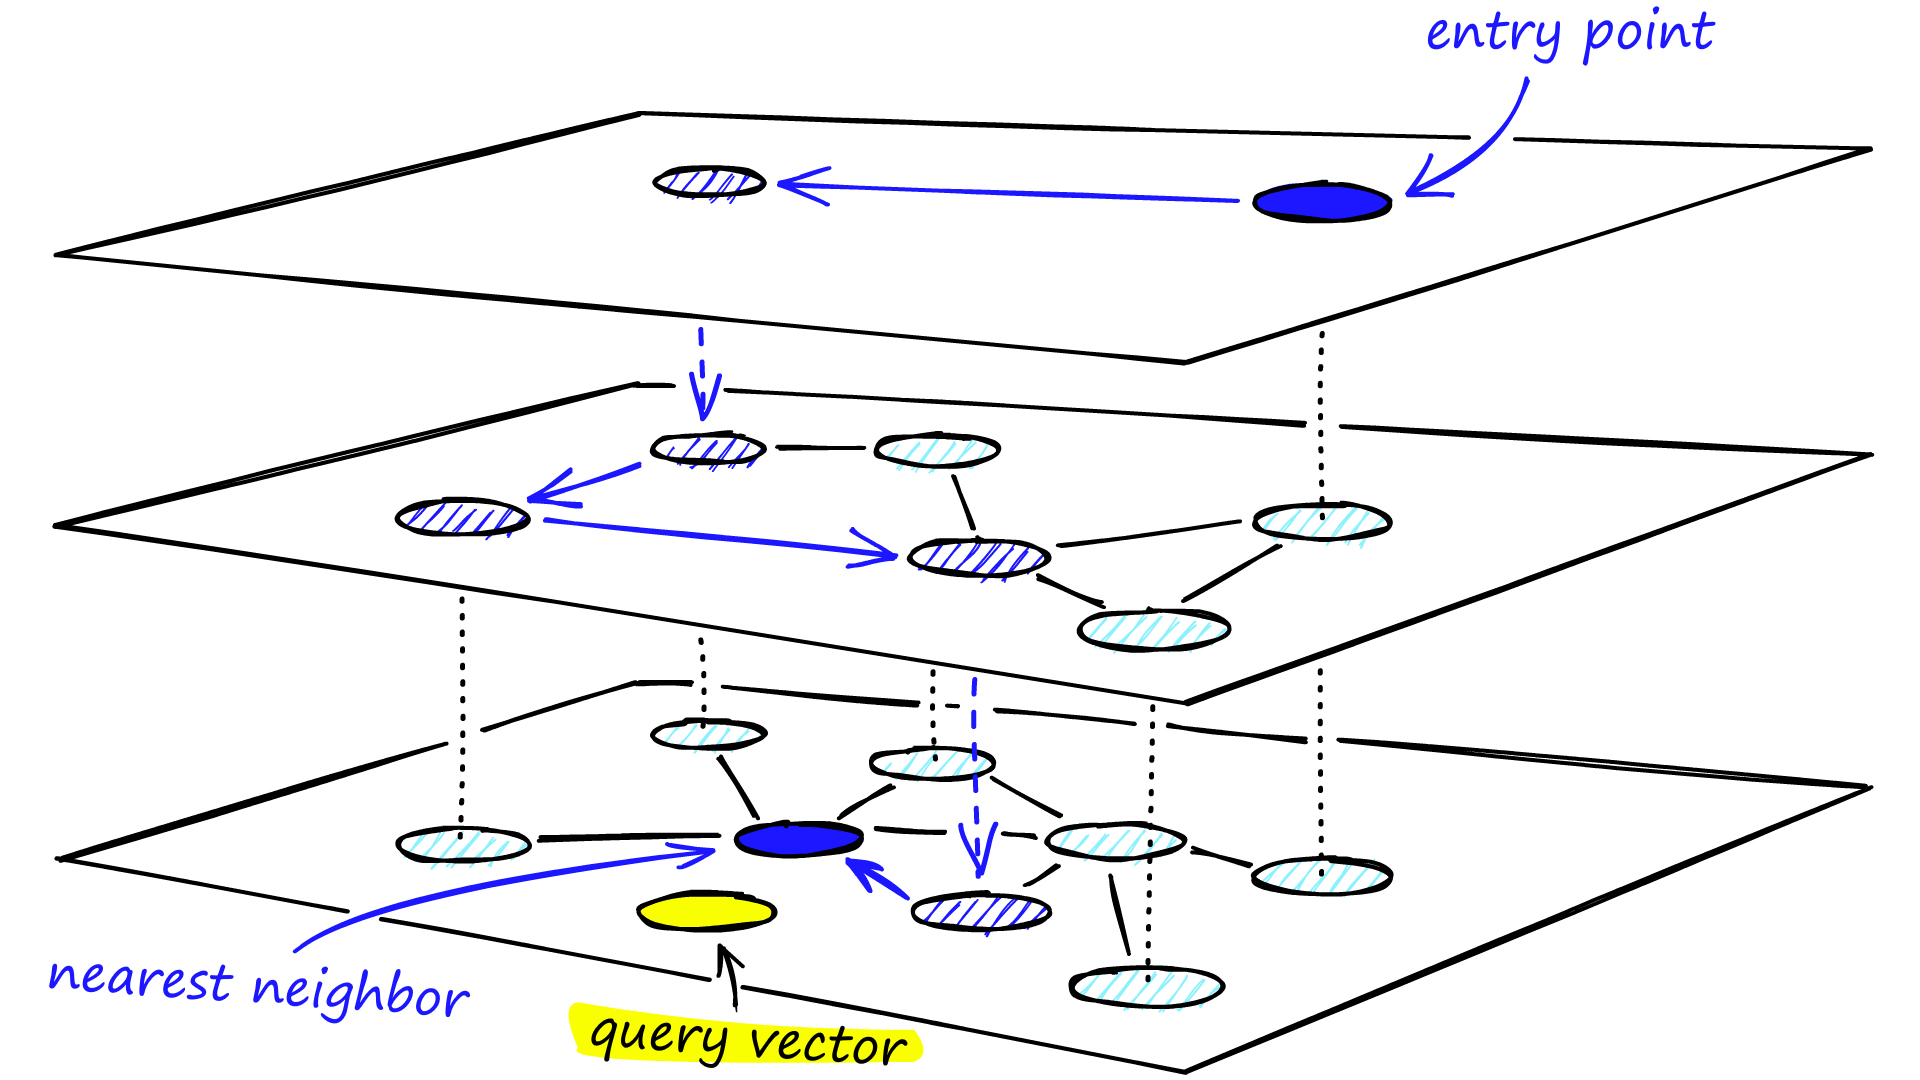
- Hierarchical Navigable Small Worlds Network
- 1960년대 심리학자 스탠리 밀그램의 실험: 멀리 떨어진 지역의 모르는 사람에게 편지를 전달 → 5~6단계만에 가능
- 작은 세상 네트워크: 주로 가까운 점과 연결되어 있지만, 멀리 떨어진 점들과도 일정 비율 연결된 형태
- 탐색 가능한: 네트워크의 전체 구조를 모르더라도 최대한 가까운 방향으로 이동하면 짧은 경로로 도달 가능
- 위계적: 연결된 거리에 따라 단계적으로 구성
벡터 데이터베이스 Vector Database
chroma
- 오픈소스 in-memory 벡터 데이터베이스
- Python으로 구현
- HNSW 지원(hnswlib 기반)
- 메타데이터와 검색 조건 지정도 가능
- ChatGPT의 등장으로 AI 서비스 개발에 활발하게 사용
벡터 데이터베이스의 기능
- 데이터 관리: 데이터 삽입, 삭제 및 업데이트 등 벡터 데이터를 쉽게 관리하고 유지
- 메타데이터: 각 벡터 항목과 관련된 메타데이터를 저장/검색
- 확장성: 데이터 볼륨과 사용자 요구에 따라 확장, 분산 및 병렬 처리
- 실시간 업데이트: 실시간 데이터 업데이트, 데이터 동적 변경
- 백업
- 에코시스템: ETL, 분석도구, 시각화 플랫폼, 다른 AI 도구등과 쉽게 통합
- 데이터 보안 및 접근 제어
