오토인코더와 VAE
오토인코더 autoencoder
- 비지도 학습을 이용하면 이미지를 압축할 수 있음
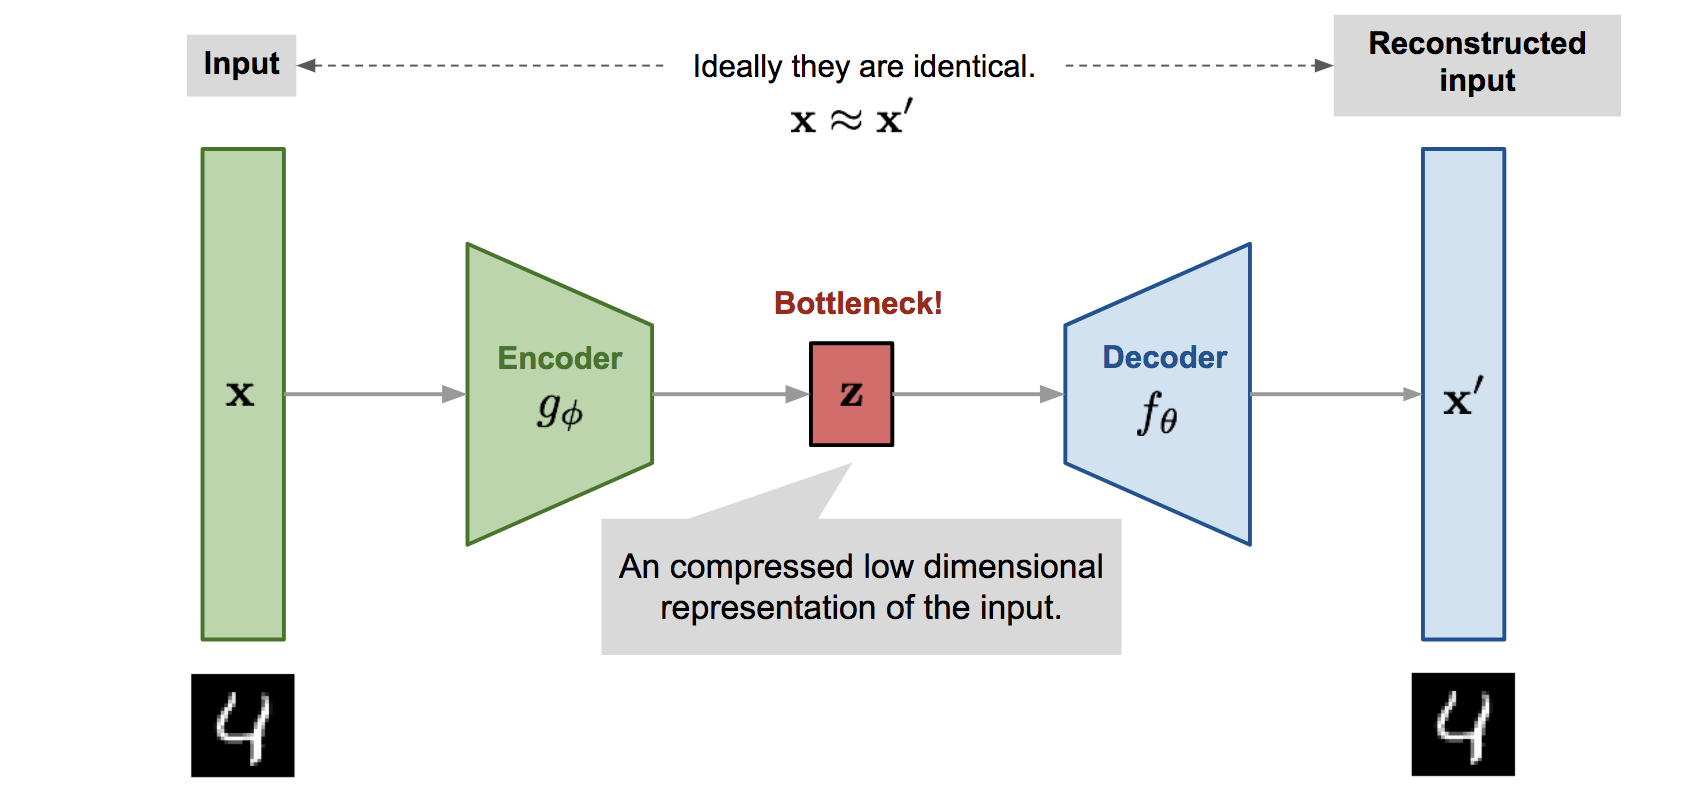
- 오토인코더: 인코더와 디코더로 구성된 신경망 기반 비지도학습 모델
- 인코더 encoder: 이미지를 잠재 공간에서 간단한 표현 z로 압축하는 역할
- 디코더 decoder: 압축된 표현을 다시 원래 이미지로 복원하는 역할
- 학습 과정에서는 원본 이미지와 복원된 이미지 사이의 차이를 줄이는 방향으로 모델이 학습
오토인코더의 활용: 잡음 제거
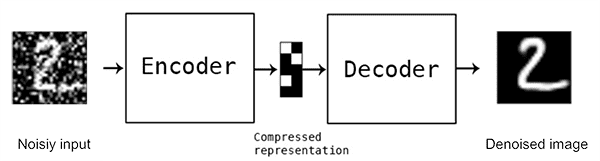
- 원본 이미지 X에 잡음(noise)를 추가하여 X′을 만듦
- 잡음이 추가된 X′을 입력하면, 잡음이 제거된 X를 생성하도록 오토인코더를 학습
- 노이즈가 있는 새로운 이미지를 입력하면, 노이즈가 제거된 이미지가 생성
- 또는 X를 입력하면 X를 생성하도록 오토인코더를 학습시켜도 비슷한 효과
- 인코더가 생성하는 "간단한 표현"에 노이즈의 정보를 반영하지 못하기 때문
임베딩과 오토 인코더
- 오토 인코더로 압축된 값을 임베딩으로 사용할 수도 있으나, 여러 가지 단점을 가짐
- 오토 인코더는 원본 이미지를 정확하게 복원하는 데 초점, 비슷한 이미지가 비슷한 임베딩을 가진다는 보장 없음
- 대조학습은 서로 비슷한 이미지와 다른 이미지를 명시적으로 비교 → 임베딩 공간에서 의미론적으로 유사한 이미지가 가까이 위치하도록 만듦
- 오토 인코더는 학습 과정에서 임베딩으로부터 이미지를 복원
- 임베딩만 만드는 목적으로는 불필요한 과정 → 학습 속도 느려짐
- 더 복잡한 패턴을 학습할 필요
생성 모형으로서 오토인코더의 한계
- 오토인코더의 유일한 목표는 '입력의 완벽한 재구성(Reconstruction)'
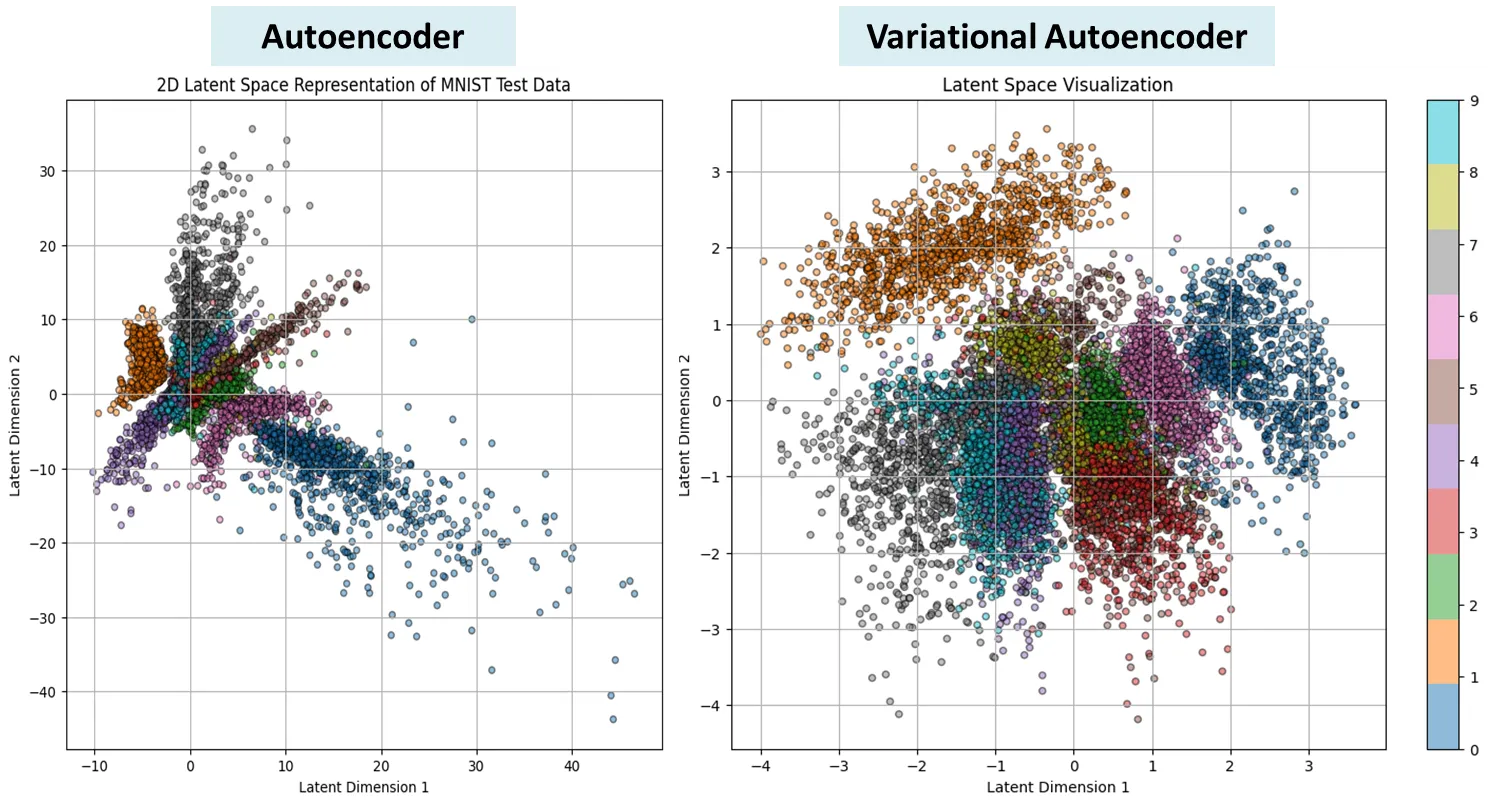
- 잠재 공간을 어떻게 구성할지에 대한 규칙이나 제약이 없음.
- 잠재 공간의 비효율적 사용:
- 모델은 데이터를 잠재 공간 내 특정 지점들로 '암기'하듯 매핑.
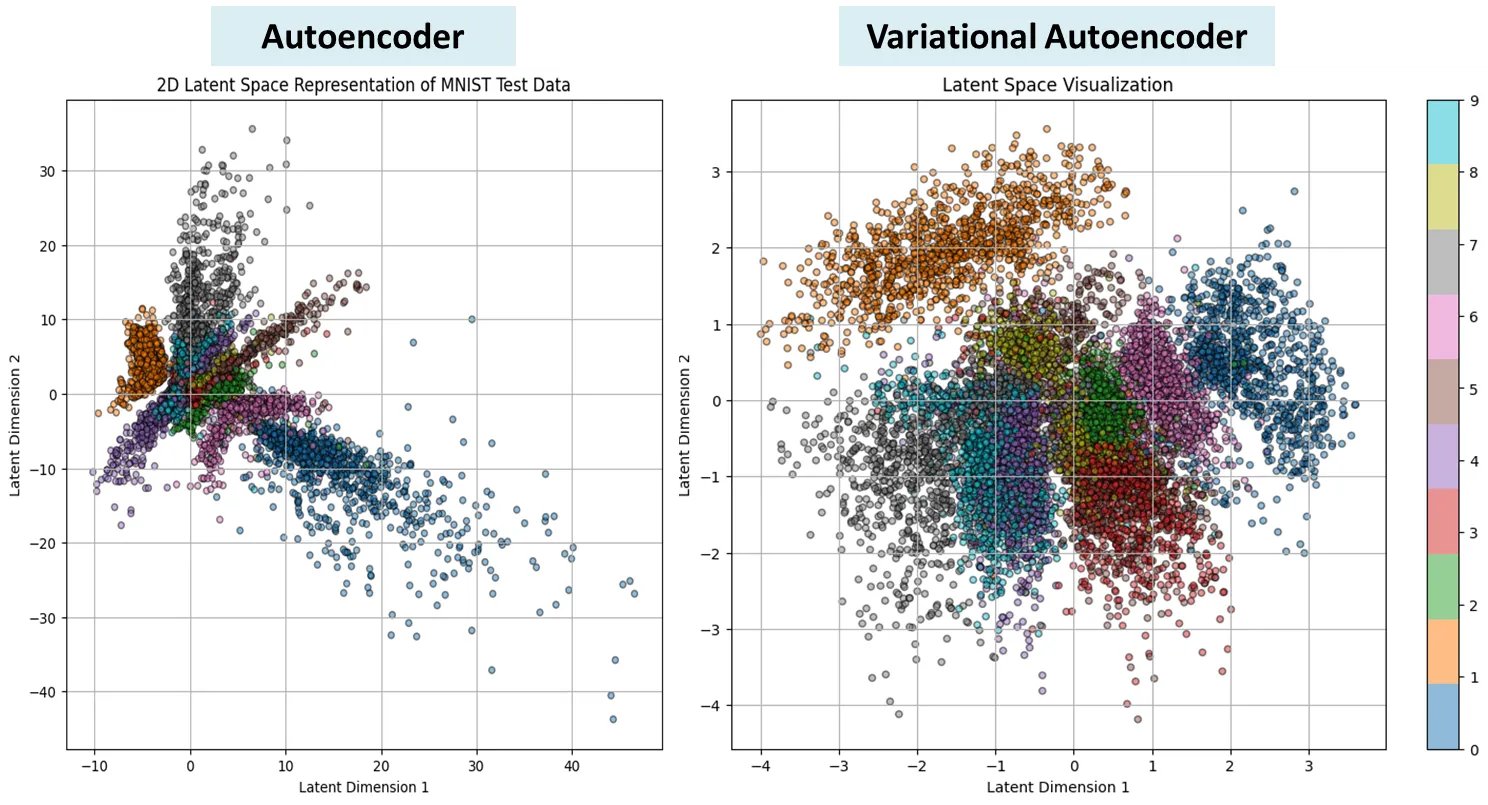
- 데이터들이 잠재 공간에서 파편화되어 분포.
- 잠재 공간의 특정 벡터 z를 샘플링했을 때 의미 없는 노이즈가 생성될 가능성이 높음
변분 오토인코더 Variational Autoencoder
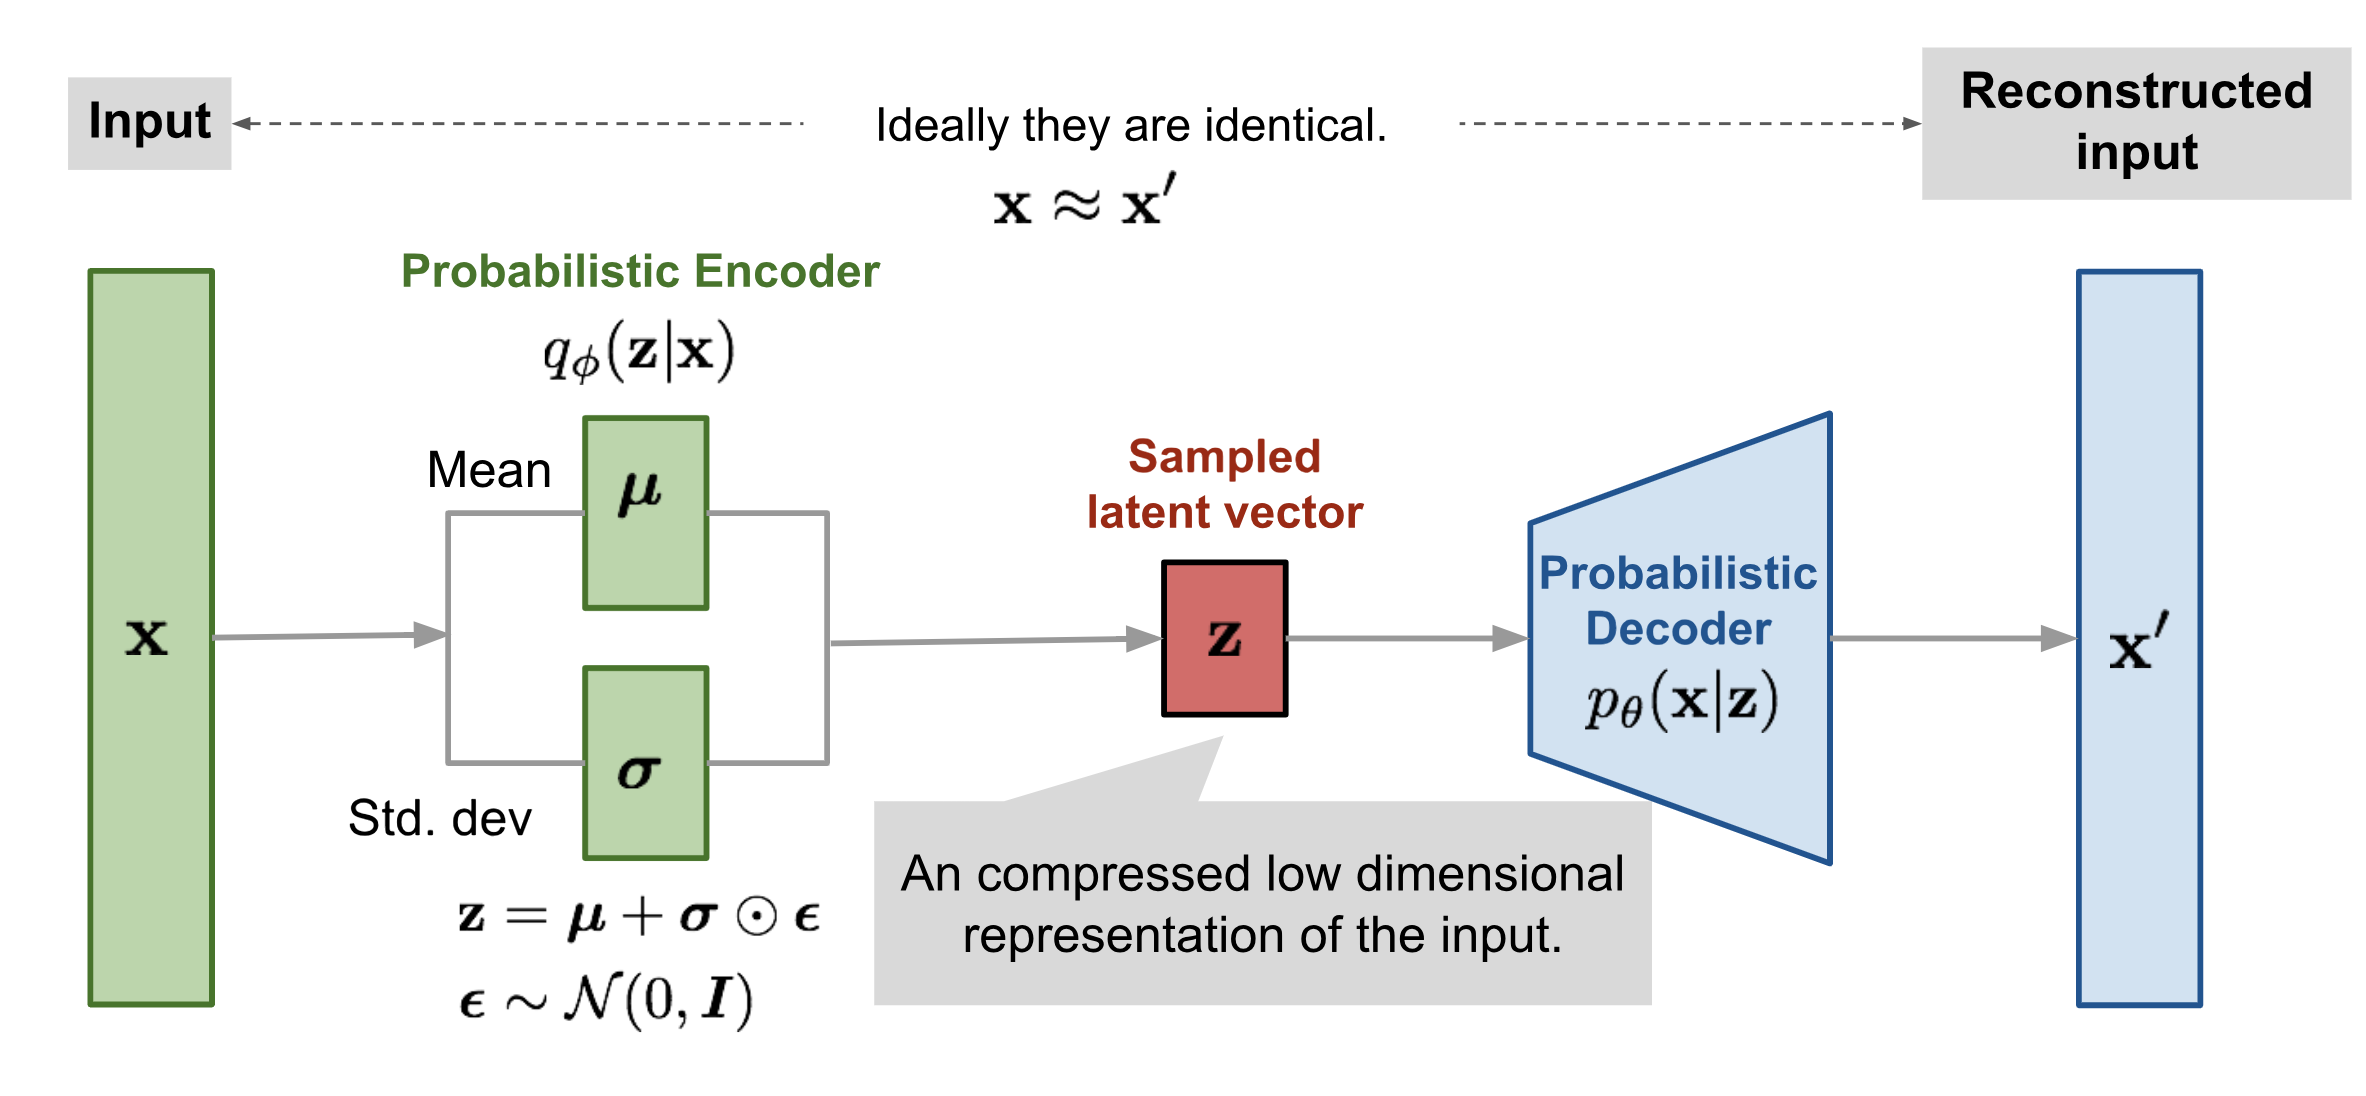
- 입력을 고정 벡터 대신 분포로 매핑
- 분포에서 하나의 벡터를 무작위 추출 → 추출된 벡터를 이미지로 복원
- AE는 z에 대한 가정이 없으나, VAE는 특정한 분포를 가정 → 좀 더 해석가능한 형태
- VAE를 이용하여 이미지를 원하는 대로 생성/변형할 수 있음
- 변분 추론 (Variational Inference)이라는 기법을 사용하기 때문에 붙은 이름
VAE를 이용한 이미지 생성
- 잘 정돈된 연속적인 잠재 공간 활용
- 정규분포에서 무작위로 잠재 벡터 z를 샘플링 → z를 디코더에 입력하여 새로운 이미지를 생성
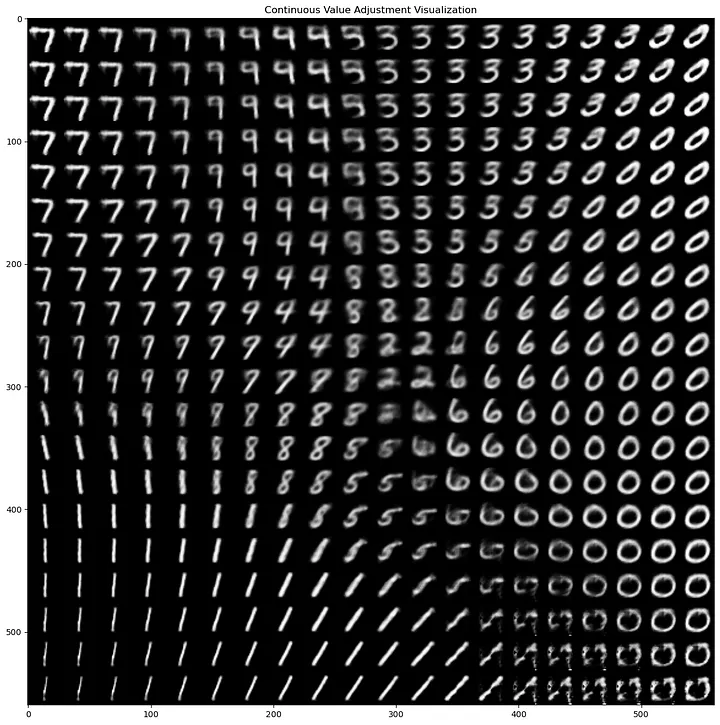
- 잠재 공간 내 두 점(이미지 A, B) 사이를 서서히 이동하면, 이미지 A가 B로 부드럽게 변하는 결과물을 얻을 수 있음
- VAE가 생성한 이미지는 형태는 그럴듯하지만, 전반적으로 선명하지 못하고 흐릿하게 보이는 경향이 강함
- 주로 사용하는 MSE(평균 제곱 오차) 손실은 픽셀 단위의 평균적인 차이를 최소화하는 방향으로 학습
- 안전하고 보수적인 "평균적인" 이미지를 생성
- 확률적 정확성은 높이지만, 사람이 인지하는 시각적 품질은 떨어뜨림
퀴즈
오토인코더에서 인코더의 역할은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.