
확산 모형
확산 모형 diffusion models
- 이미지 생성과 같은 생성 모델링 문제에 대한 접근 방식 중 하나
- 데이터의 노이즈 확산 과정을 역으로 추적하여 원본 데이터를 복원하는 방법을 사용
- 장점:
- 고품질의 이미지를 생성(GAN처럼)
- 안정적인 학습 과정(VAE처럼)
- 단점: 생성 과정이 상대적으로 느리고 많은 데이터가 필요
잡음 제거 확산 확률 모형 DDPM
- 잡음 제거 확산 확률 모형(Denoising Diffusion Probabilistic Models, DDPM): 이미지 생성을 작은 잡음 제거 문제의 반복으로 바꾼 생성 모형
- 한 번에 완성된 이미지를 그리지 않고 작은 잡음 제거를 반복하여 이미지를 생성
- 시점 t: 현재 이미지에 잡음이 얼마나 섞였는지를 나타내는 단계
순방향 확산
- 깨끗한 사진 위에 반투명한 잡음 막을 한 겹씩 덧씌우는 과정과 유사
- 원본 이미지에 잡음을 점차 추가하여 완전한 무작위 잡음에 가까운 상태로 변화
- 초기 단계: 물체의 형태와 색상이 대부분 남아 있음
- 중간 단계: 큰 윤곽은 보이지만 세부 묘사가 사라짐
- 마지막 단계: 원본을 알아보기 어려운 무작위 잡음에 가까워짐
- 잡음 스케줄(noise schedule): 각 단계에서 잡음을 얼마나 추가할지 정하는 규칙
- 정해진 확률 규칙으로 진행하며 신경망이 학습하는 과정은 아님
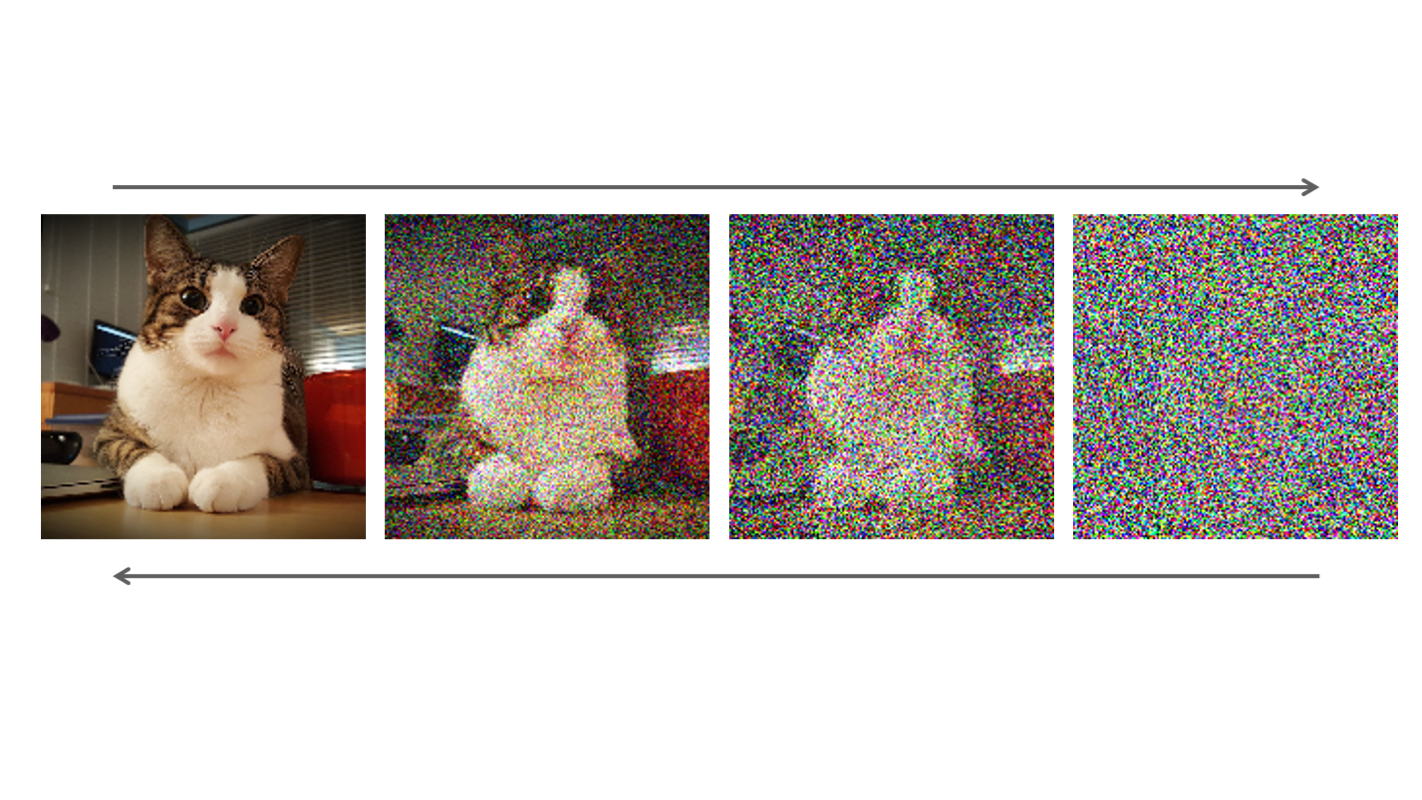
순방향 확산의 중요한 역할은 학습 문제와 정답을 자동으로 만드는 것. 원본 이미지에 무작위 잡음을 직접 추가하므로, 어떤 잡음을 추가했는지 정확히 알 수 있음. 잡음이 섞인 이미지는 문제가 되고, 실제로 추가한 잡음은 정답이 됨
- 데이터셋에서 원본 이미지를 선택
- 시점 t를 무작위로 선택
- 선택한 시점에 맞춰 가우시안 잡음 ϵ을 생성
- 원본 이미지와 잡음을 섞어 학습용 이미지를 생성
역확산
역확산(reverse diffusion)은 완전한 무작위 잡음에서 시작하여 신경망이 예측한 잡음을 조금씩 제거하는 생성 과정. 한 번에 원본을 복원하지 않고 잡음이 많은 시점부터 적은 시점까지 역순으로 반복
역확산에 사용할 신경망의 학습은 일부가 가려진 그림에서 잡음을 찾는 연습과 유사
- 신경망에 잡음이 섞인 이미지와 시점 t를 입력
- 신경망이 이미지에 섞인 잡음을 예측
- 예측한 잡음과 실제로 추가한 잡음 ϵ의 차이를 줄이도록 학습
- 학습 목표: 원본 이미지를 한 번에 복원하는 것이 아니라 현재 이미지에 섞인 잡음을 예측
- 시점 입력: 같은 모양의 잡음이라도 현재 잡음 수준에 따라 제거해야 할 양이 다르기 때문
- 반복 학습의 결과: 하나의 신경망이 약한 잡음부터 강한 잡음까지 처리
학습이 끝나면 다음과 같이 역확산을 반복하여 이미지를 생성
- 표준 정규분포에서 무작위 잡음을 생성
- 신경망으로 현재 시점의 잡음을 예측
- 예측 결과를 이용하여 잡음이 조금 줄어든 이미지를 계산
- 잡음이 많은 단계부터 적은 단계까지 역순으로 반복
- 큰 형태와 구도가 먼저 나타나고, 반복이 진행되면서 세부 묘사가 형성
생성 결과는 특정한 훈련 이미지를 복원한 것이 아님. 신경망이 학습한 이미지의 공통 패턴을 이용하여 무작위 잡음을 새로운 이미지로 변화시킨 결과
| 구분 | 학습 | 이미지 생성 |
|---|---|---|
| 시작점 | 데이터셋의 원본 이미지 | 무작위 잡음 |
| 처리 시점 | 무작위로 선택한 시점 하나 | 잡음이 많은 단계부터 적은 단계까지 반복 |
| 신경망의 역할 | 실제로 추가한 잡음을 맞히도록 학습 | 예측한 잡음을 이용해 다음 이미지를 계산 |
| 계산 특성 | 여러 이미지를 병렬로 학습 가능 | 각 단계가 이전 결과에 의존하는 순차 처리 |
수식으로 보는 DDPM
기호
| 기호 | 의미 |
|---|---|
| x0 | 잡음이 없는 원본 이미지 |
| xt | 시점 t에서 잡음이 섞인 이미지 |
| βt | 시점 t에서 추가할 잡음의 분산 |
| ϵ | 표준 정규분포에서 추출한 가우시안 잡음 |
| ϵθ(xt,t) | 신경망이 예측한 잡음 |
한 단계의 순방향 확산
시점 t−1의 이미지에 소량의 잡음을 추가하여 다음 시점의 이미지 xt를 만듦
q(xt∣xt−1)=N(1−βtxt−1,βtI)원하는 시점의 이미지 만들기
αt=1−βt, αˉt=∏s=1tαs로 정의하면 원본 이미지에서 원하는 시점의 잡음 이미지를 한 번에 만들 수 있음
xt=αˉtx0+1−αˉtϵ,ϵ∼N(0,I)- αˉtx0: 원본 이미지에 적용되는 계수
- 1−αˉtϵ: 가우시안 잡음에 적용되는 계수
- 훈련할 때 중간 시점의 이미지를 차례로 계산할 필요가 없음
잡음 예측 손실
실제로 추가한 잡음과 신경망이 예측한 잡음 사이의 평균 제곱 오차를 줄이는 단순화된 손실
Lsimple=Ex0,ϵ,t[∥ϵ−ϵθ(xt,t)∥2]퀴즈
확산 모형의 기본 아이디어는 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.