자전거 통행량과 그룹별 집계
자전거 카운터 데이터
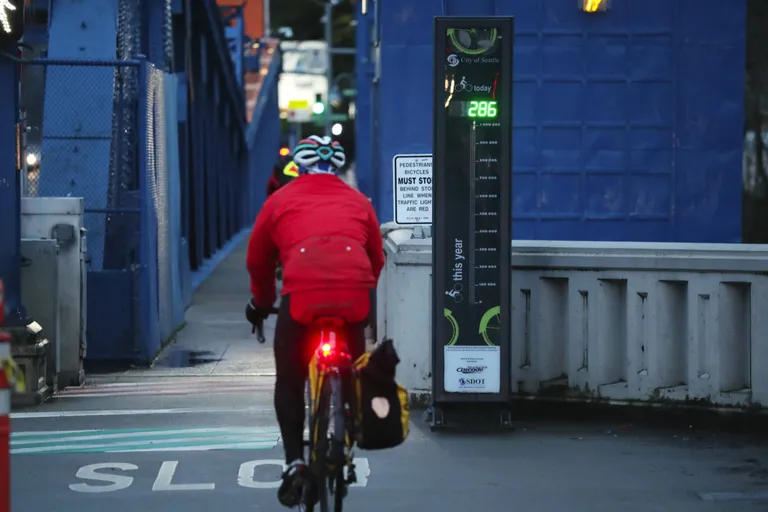
- 미국 시애틀 프레몬트 브리지(Fremont Bridge)의 자전거 카운터 데이터
- 동쪽과 서쪽 보도를 지나는 자전거 통행량을 시간별로 기록
data = pd.read_csv(
    'bicycle.csv',
    index_col='Date',  # Date 컬럼을 인덱스로 지정
    parse_dates=True)  # 인덱스를 날짜·시간 자료형으로 변환
data.head()
실행 결과
                     Fremont Bridge Total  Fremont Bridge East Sidewalk  \
Date
2019-11-01 00:00:00                  12.0                           7.0
2019-11-01 01:00:00                   7.0                           0.0
2019-11-01 02:00:00                   1.0                           0.0
2019-11-01 03:00:00                   6.0                           6.0
2019-11-01 04:00:00                   6.0                           5.0

                     Fremont Bridge West Sidewalk
Date
2019-11-01 00:00:00                           5.0
2019-11-01 01:00:00                           7.0
2019-11-01 02:00:00                           1.0
2019-11-01 03:00:00                           0.0
2019-11-01 04:00:00                           1.0
시각화
- 편의를 위해 컬럼 이름을 변경
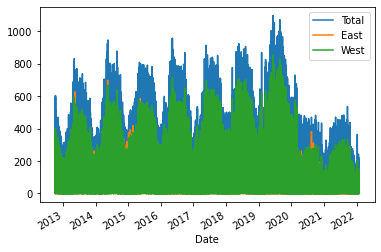
Total: 전체 통행량East: 동쪽 보도 통행량West: 서쪽 보도 통행량
data.columns = ['Total', 'East', 'West']
- 시간별 원자료 시각화
data.plot()
실행 결과
<Axes: xlabel='Date'>
<Figure size 640x480 with 1 Axes>
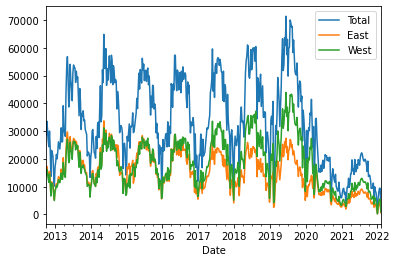
- 주 단위 합계 시각화
data.resample('W').sum().plot()
실행 결과
<Axes: xlabel='Date'>
<Figure size 640x480 with 1 Axes>
이동 평균
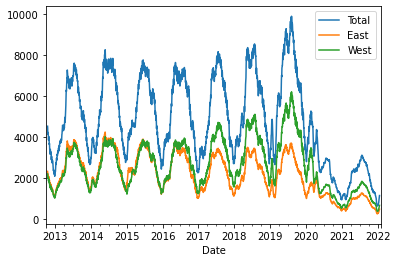
- 일 단위 합계를 계산한 뒤 30일 이동 평균을 계산
daily: 하루에 한 행이므로 30개 관측값은 30일에 해당
daily = data.resample('D').sum()
daily.rolling(30, center=True).mean().plot()  # 30일 평균을 구간 중심에 표시
실행 결과
<Axes: xlabel='Date'>
<Figure size 640x480 with 1 Axes>
가우스 가중 이동 합계
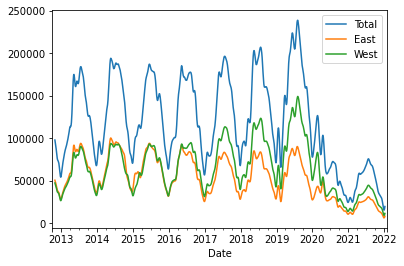
- 중심에 가까운 날짜에 더 큰 가중치를 주고, 먼 날짜에 더 작은 가중치를 주는 방식
win_type='gaussian': 가우스 형태의 가중치- 구간 길이 50일, 가우스 가중치의 표준편차 10
sum(): 가중 이동 합계. 가중 이동 평균과 구별
roll = daily.rolling(50, center=True, win_type='gaussian')  # 50일 가중 구간
roll.sum(std=10).plot()  # 가중치의 표준편차 10
실행 결과
<Axes: xlabel='Date'>
<Figure size 640x480 with 1 Axes>
시간대별 평균
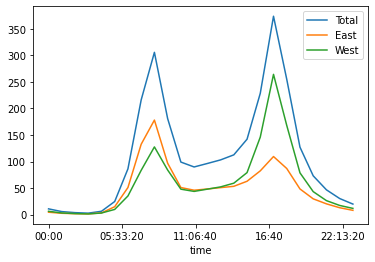
data.index.time: 날짜를 제외한 시각- 같은 시각의 관측값을
groupby()로 모아 평균 계산
by_time = data.groupby(data.index.time).mean()
by_time.plot()
실행 결과
<Axes: xlabel='time'>
<Figure size 640x480 with 1 Axes>
가로 눈금을 4시간 간격으로
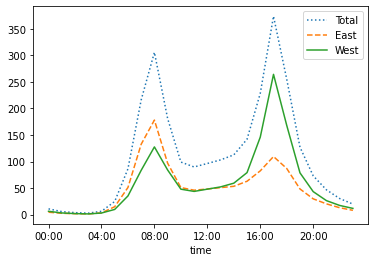
- 시각 인덱스의 그래프에서 눈금 위치는 자정부터 경과한 초 단위
4 * 60 * 60: 4시간을 초로 환산np.arange(6): 0, 1, 2, 3, 4, 5- 눈금 시각: 00:00, 04:00, 08:00, 12:00, 16:00, 20:00
style:Total,East,West순서대로 점선, 대시, 실선 지정
import numpy as np
hourly_ticks = 4 * 60 * 60 * np.arange(6)  # 0시부터 20시까지 4시간 간격, 초 단위
by_time.plot(xticks=hourly_ticks, style=[':', '--', '-'])
실행 결과
<Axes: xlabel='time'>
<Figure size 640x480 with 1 Axes>
요일별 평균
data.index.dayofweek: 월요일 0부터 일요일 6까지의 요일 번호- 같은 요일의 시간별 관측값을 모아 평균 계산
by_weekday = data.groupby(data.index.dayofweek).mean()
by_weekday.index = ['Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun']
by_weekday.plot()
실행 결과
<Axes: >
<Figure size 640x480 with 1 Axes>
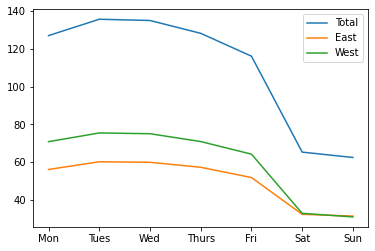
- 이 평균은 요일별 하루 총통행량이 아니라 해당 요일의 시간별 관측값 평균
주중과 주말의 비교
- 요일 번호가 5보다 작으면 주중, 나머지는 주말로 구분
- 주중·주말과 시각을 함께 기준으로 삼아 평균 계산
weekend = np.where(data.index.weekday < 5, 'Weekday', 'Weekend')  # 월~금과 토~일 구분
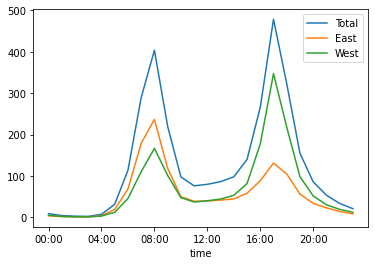
by_time = data.groupby([weekend, data.index.time]).mean()
by_time.loc['Weekday']: 주중의 시간대별 평균
by_time.loc['Weekday'].plot(xticks=hourly_ticks)
실행 결과
<Axes: xlabel='time'>
<Figure size 640x480 with 1 Axes>
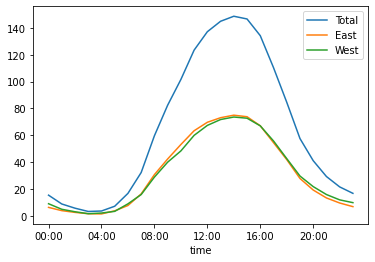
by_time.loc['Weekend']: 주말의 시간대별 평균
by_time.loc['Weekend'].plot(xticks=hourly_ticks)
실행 결과
<Axes: xlabel='time'>
<Figure size 640x480 with 1 Axes>
하나의 그림에 합쳐 그리기
plt.subplots(1, 2): 한 행에 두 개의 그래프 배치ax[0]: 왼쪽 그래프에 주중 평균 표시ax[1]: 오른쪽 그래프에 주말 평균 표시- 하나의 셀에서 실행
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(14, 5))  # 한 행, 두 열로 비교
by_time.loc['Weekday'].plot(ax=ax[0], title='Weekdays', xticks=hourly_ticks)
by_time.loc['Weekend'].plot(ax=ax[1], title='Weekends', xticks=hourly_ticks)
실행 결과
<Axes: title={'center': 'Weekends'}, xlabel='time'>
<Figure size 1400x500 with 2 Axes>
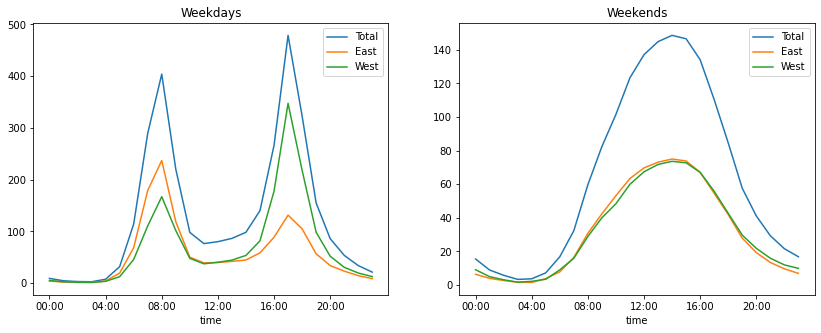
- 주중: 오전과 오후에 두 개의 뚜렷한 봉우리
- 주말: 낮 시간대에 하나의 넓은 봉우리
- 두 패널의 세로축 범위가 다르므로 통행량은 눈금의 수치로 비교
퀴즈
data.resample('W').sum()의 결과는 무엇인가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.