
시계열 분해
주요 개념
- 덧셈 분해
- 곱셈 분해
- 고전적 분해법
- 추세와 계절성의 강도
덧셈 분해
- 덧셈 분해(additive decomposition): 관측값을 계절·추세·나머지 성분의 합으로 표현
- yt: 종속 변수의 관측값
- St: 계절 성분
- Tt: 추세 성분. 주기 성분을 포함
- Rt: 나머지 성분
곱셈 분해
- 곱셈 분해(multiplicative decomposition): 관측값을 계절·추세·나머지 성분의 곱으로 표현
- yt: 종속 변수의 관측값
- St: 계절 성분
- Tt: 추세 성분. 주기 성분을 포함
- Rt: 나머지 성분
분해 방법 선택
- 덧셈 분해: 시계열의 수준이 달라져도 계절 변동의 폭이 대체로 일정한 경우
- 곱셈 분해: 시계열의 수준이 높아질수록 계절 변동의 폭도 비례하여 커지는 경우
전자 장비 주문
- 전자 장비에 대한 신규 주문 지수 데이터
- 유럽 지역 16개국의 컴퓨터·전자·광학 제품 신규 주문량
- 근무일 기준으로 조정
- 2005년 값이 100이 되도록 조정
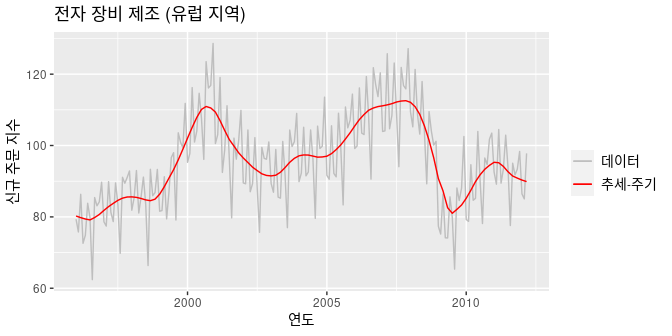
실습 프롬프트
🤖 AI 프롬프트
elecequip.xlsx의 월별 전자 장비 주문 지수를 고전적 덧셈 분해로 추세·계절·나머지 성분으로 나눠줘.
계절 효과를 제거한 데이터를 그려주고, 추세와 계절성의 강도를 계산해 해석해줘.
실습 준비
elecequip.xlsx: 행은 연도, 열은 월 형태의 데이터
import pandas as pd
df = pd.read_excel('elecequip.xlsx')
df.head()
실행 결과
   year    Jan    Feb     Mar     Apr     May     Jun     Jul    Aug     Sep  \
0  1996  79.35  75.78   86.32   72.60   74.86   83.81   79.80  62.41   85.41
1  1997  78.64  77.42   89.86   81.27   78.68   89.51   83.67  69.80   91.09
2  1998  81.87  85.36   92.98   81.09   85.64   91.14   83.46  66.37   93.34
3  1999  81.59  81.77   91.24   79.45   86.99   96.60   97.99  79.13  103.56
4  2000  95.30  97.77  116.23  100.98  104.07  114.64  107.62  96.12  123.50

      Oct     Nov     Dec
0   83.11   84.21   89.70
1   89.43   91.04   92.87
2   85.93   86.81   93.30
3  100.89   99.40  111.80
4  116.12  116.86  128.61
pd.melt(): 월별 열을 연·월별 행으로 변환id_vars: 유지할 식별 컬럼var_name: 기존 열 이름을 담을 컬럼value_name: 관측값을 담을 컬럼
long_form = pd.melt(df, id_vars=['year'], var_name='month', value_name='demand')
long_form.head()
실행 결과
   year month  demand
0  1996   Jan   79.35
1  1997   Jan   78.64
2  1998   Jan   81.87
3  1999   Jan   81.59
4  2000   Jan   95.30
월 순서대로 정렬
- 월을 순서가 있는 범주형 데이터로 변환
- 문자열의 사전순 대신 1월부터 12월까지의 달력 순서 사용
months = ['Jan', 'Feb', 'Mar', 'Apr', 'May', 'Jun',
          'Jul', 'Aug', 'Sep', 'Oct', 'Nov', 'Dec']
long_form['month'] = pd.Categorical(long_form['month'], categories=months, ordered=True)
- 연·월순 정렬 → 값이 비어 있는 행 삭제 → 행 번호 재지정
drop=True: 기존 인덱스를 새 컬럼으로 남기지 않음
ym = long_form.sort_values(['year', 'month']).dropna().reset_index(drop=True)
ym.head()
실행 결과
   year month  demand
0  1996   Jan   79.35
1  1996   Feb   75.78
2  1996   Mar   86.32
3  1996   Apr   72.60
4  1996   May   74.86
피벗 테이블
- 행은
year, 열은month, 값은demand가 되도록 표 생성
wide_form = long_form.pivot_table(
    index='year', columns='month', values='demand',
    observed=False)  # 모든 월 범주를 기준으로 표 구성
wide_form
실행 결과
month     Jan     Feb     Mar     Apr     May     Jun     Jul    Aug     Sep  \
year
1996    79.35   75.78   86.32   72.60   74.86   83.81   79.80  62.41   85.41
1997    78.64   77.42   89.86   81.27   78.68   89.51   83.67  69.80   91.09
1998    81.87   85.36   92.98   81.09   85.64   91.14   83.46  66.37   93.34
1999    81.59   81.77   91.24   79.45   86.99   96.60   97.99  79.13  103.56
2000    95.30   97.77  116.23  100.98  104.07  114.64  107.62  96.12  123.50
2001   100.56  103.05  119.06   92.46   98.75  111.14   96.13  79.72  102.07
2002    89.52   89.27  104.35   87.05   89.33  102.20   88.13  75.68   99.48
2003    89.34   86.91   98.90   85.54   85.25  101.14   91.80  76.98  104.33
2004    89.88   92.27  105.11   91.50   92.56  104.35   96.21  79.58  105.43
2005    91.65   90.56  105.52   92.18   91.22  109.04   99.26  83.36  110.80
2006    99.16   99.86  116.14  103.48  103.07  119.32  107.94  90.59  121.80
2007   103.93  104.10  125.72  104.70  108.45  123.11  108.89  94.07  121.88
2008   109.45  105.23  121.32  108.78  103.20  117.93  103.76  89.27  109.50
2009    77.38   75.19   86.40   74.13   74.10   85.61   79.90  65.36   88.09
2010    79.28   78.74   94.62   84.66   85.20  103.94   89.87  78.14   96.50
2011    92.57   89.16  104.48   89.45   93.40  102.90   93.77  77.58   95.04
2012    86.44   85.04   97.80     NaN     NaN     NaN     NaN    NaN     NaN

month     Oct     Nov     Dec
year
1996    83.11   84.21   89.70
1997    89.43   91.04   92.87
1998    85.93   86.81   93.30
1999   100.89   99.40  111.80
2000   116.12  116.86  128.61
2001    96.18  101.26  109.85
2002    96.40   96.16  101.00
2003    99.72  101.06  109.00
2004    99.18   99.77  113.55
2005   104.95  107.07  114.40
2006   117.11  113.71  120.37
2007   116.81  115.87  127.14
2008   104.02  100.12  101.18
2009    84.60   88.09  102.52
2010    94.68  101.77  103.48
2011    91.77   93.37   98.34
2012      NaN     NaN     NaN
고전적 분해법
- 1920년대에 창안된 단순한 방법으로 다른 시계열 분해 방법의 기초
- 계절 성분이 매년 일정하다고 가정
덧셈 분해의 단계
- 이동 평균으로 추세 성분 계산
- 시계열에서 추세 성분 제거
- 같은 계절 위치의 값을 평균하여 계절 성분 계산
- 예: 분기, 월, 요일
- 시계열에서 추세와 계절 성분을 제거하여 나머지 성분 계산
곱셈 분해의 단계
- 성분을 제거할 때 뺄셈 대신 나눗셈 사용
- 양수인 시계열에 로그를 취하면 덧셈 관계로 표현 가능
- 로그 척도에서 분해한 성분을 지수 변환하면 곱셈 관계로 돌아감
덧셈 분해 실습
seasonal_decompose(): 이동 평균을 이용한 고전적 분해model='additive': 덧셈 분해period=12: 월별 데이터의 1년 주기
from statsmodels.tsa.seasonal import seasonal_decompose
result = seasonal_decompose(ym['demand'], model='additive', period=12)  # 1년 주기
result.plot();
실행 결과
<Figure size 640x480 with 4 Axes>
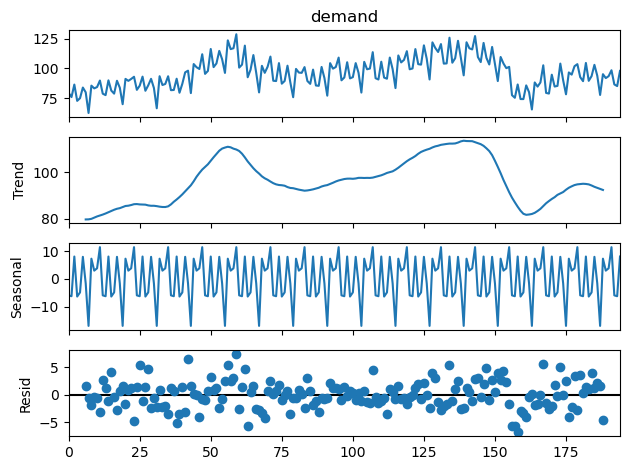
- 그래프 순서: 관측값(
demand), 추세(Trend), 계절 성분(Seasonal), 나머지 성분(Resid)
성분별 보기
추세 성분
result.trend
실행 결과
0     NaN
1     NaN
2     NaN
3     NaN
4     NaN
       ..
190   NaN
191   NaN
192   NaN
193   NaN
194   NaN
Name: trend, Length: 195, dtype: float64
계절 성분
result.seasonal
실행 결과
0      -5.887662
1      -6.199273
2       8.083171
3      -6.314968
4      -4.818468
         ...
190     3.847366
191    11.447504
192    -5.887662
193    -6.199273
194     8.083171
Name: seasonal, Length: 195, dtype: float64
- 1월의 계절 성분은 약 −5.89: 추세·주기 수준에 비해 주문 지수가 약 5.89포인트 낮아지는 계절 효과
나머지 성분
result.resid
실행 결과
0     NaN
1     NaN
2     NaN
3     NaN
4     NaN
       ..
190   NaN
191   NaN
192   NaN
193   NaN
194   NaN
Name: resid, Length: 195, dtype: float64
- 중심 이동 평균을 계산할 자료가 부족한 양쪽 끝에서는 추세와 나머지 성분이
NaN
계절적 조정
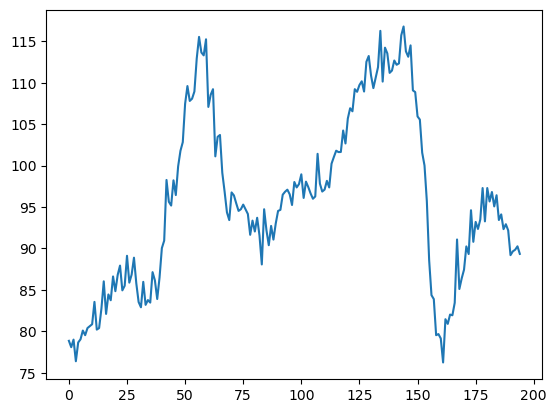
- 위 그림은 슬라이드의 예시
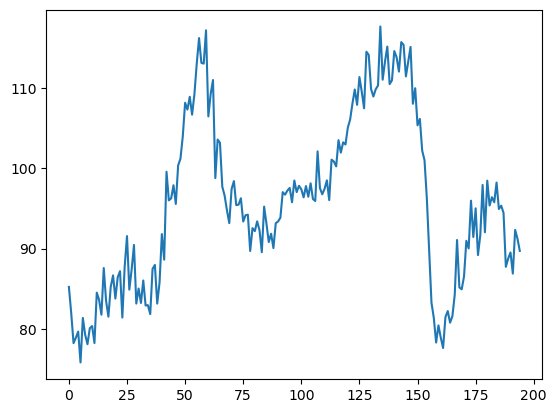
- 아래 실습에서는 고전적 분해 결과를 사용하여 계절적으로 조정한 값을 직접 계산
- 관측값에서 계절 성분을 제거
adjusted = ym.demand - result.seasonal
adjusted
실행 결과
0      85.237662
1      81.979273
2      78.236829
3      78.914968
4      79.678468
         ...
190    89.522634
191    86.892496
192    92.327662
193    91.239273
194    89.716829
Length: 195, dtype: float64
- 추세와 나머지 성분을 더하는 방법도 가능
result.trend + result.resid
실행 결과
0     NaN
1     NaN
2     NaN
3     NaN
4     NaN
       ..
190   NaN
191   NaN
192   NaN
193   NaN
194   NaN
Length: 195, dtype: float64
- 두 방법은 추세와 나머지 성분이 추정된 구간에서 같음
- 두 번째 방법은 추세가
NaN인 양쪽 끝도NaN - 아래 그래프는 관측값에서 계절 성분을 뺀
adjusted를 사용
adjusted.plot()
실행 결과
<Axes: >
<Figure size 640x480 with 1 Axes>
추세의 강도
- 계절성을 조정한 데이터 Tt+Rt의 분산과 나머지 성분 Rt의 분산을 비교
- 0~1 범위의 값. 계산값이 음수이면 0으로 처리
- 0에 가까울수록 추세가 약하고, 1에 가까울수록 추세가 강함
- 이 실습에서는 앞에서 구한 고전적 분해 결과
result에 적용
max(0, 1 - result.resid.var() / (result.trend + result.resid).var())
실행 결과
np.float64(0.9387435387853423)
- 추세 강도: 약 0.939. 1에 가까운 값
계절성의 강도
- 추세를 제거한 데이터 St+Rt의 분산과 나머지 성분 Rt의 분산을 비교
- 0~1 범위의 값. 계산값이 음수이면 0으로 처리
- 0에 가까울수록 계절성이 약하고, 1에 가까울수록 계절성이 강함
max(0, 1 - result.resid.var() / (result.seasonal + result.resid).var())
실행 결과
np.float64(0.9067436715383737)
-
계절성 강도: 약 0.907. 1에 가까운 값
-
두 강도 지표는 분모의 분산이 양수인 경우에 정의
-
var()는NaN을 제외하므로, 이 실습에서는 나머지 성분이 추정된 구간으로 계산
퀴즈
덧셈 분해에서 관측값을 올바르게 표현한 것은 무엇인가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.