지도학습의 기본 구조
- 지도학습(supervised learning): 입력 데이터와 정답을 함께 주고 규칙을 학습하는 방식
- 입력 X: 예측에 사용할 정보
- 정답 y: 맞히고 싶은 결과
- 모델: X와 y 사이의 관계를 학습한 예측 규칙
- 예: 설비 조건 X로 생산량 y 예측
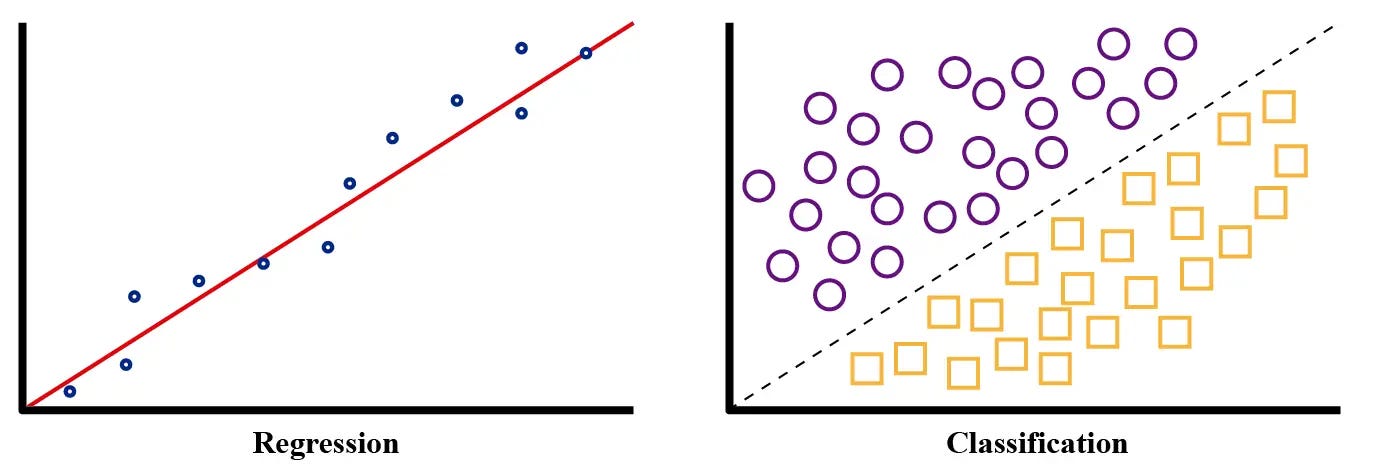
회귀와 분류
- 회귀(regression): 정답이 연속적인 숫자인 지도학습 문제
- 예측 결과가 등급이나 이름이 아니라 수치
- 예: 주택 가격, 공정 수율, 에너지 사용량, 설비 온도
- 분류(classification): 정답이 범주인 지도학습 문제
- 예측 결과가 숫자 크기가 아니라 클래스 이름
- 예: 정상/불량, 합격/불합격, 고장/정상
- 현장에서는 어떤 범주를 더 중요하게 볼지 먼저 정의해야 함
회귀와 분류의 구분
- 회귀: 연속적인 수치 예측
- 분류: 정해진 범주 중 하나 예측
- 회귀 예측값은 오차 크기로 평가
- 분류 예측값은 맞음/틀림과 오류 종류로 평가
실습 데이터: California Housing
- 미국 캘리포니아 지역별 주택 가격 데이터
- 여러 지역 특성으로 주택 가격 중앙값 예측
- 표본 수가 많아 훈련/평가 실습에 적합
sklearn 공식 예제 데이터 사용
pip install scikit-learn pandas seaborn matplotlib
import pandas as pd
from sklearn.datasets import fetch_california_housing

housing = fetch_california_housing(as_frame=True)
df_house = housing.frame
df_house.head()
학습/평가 데이터 분할
- 같은 데이터로 학습과 평가를 모두 하면 실전 성능 확인이 어려움
- 훈련 데이터: 모델이 규칙을 학습하는 데이터
- 테스트 데이터: 학습 후 처음 보는 평가 데이터
random_state: 재현을 위해 데이터 분할 시 난수 발생 방법을 고정
from sklearn.model_selection import train_test_split

X = df_house.drop(columns="MedHouseVal")
y = df_house["MedHouseVal"]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
)
지도학습 모델의 종류
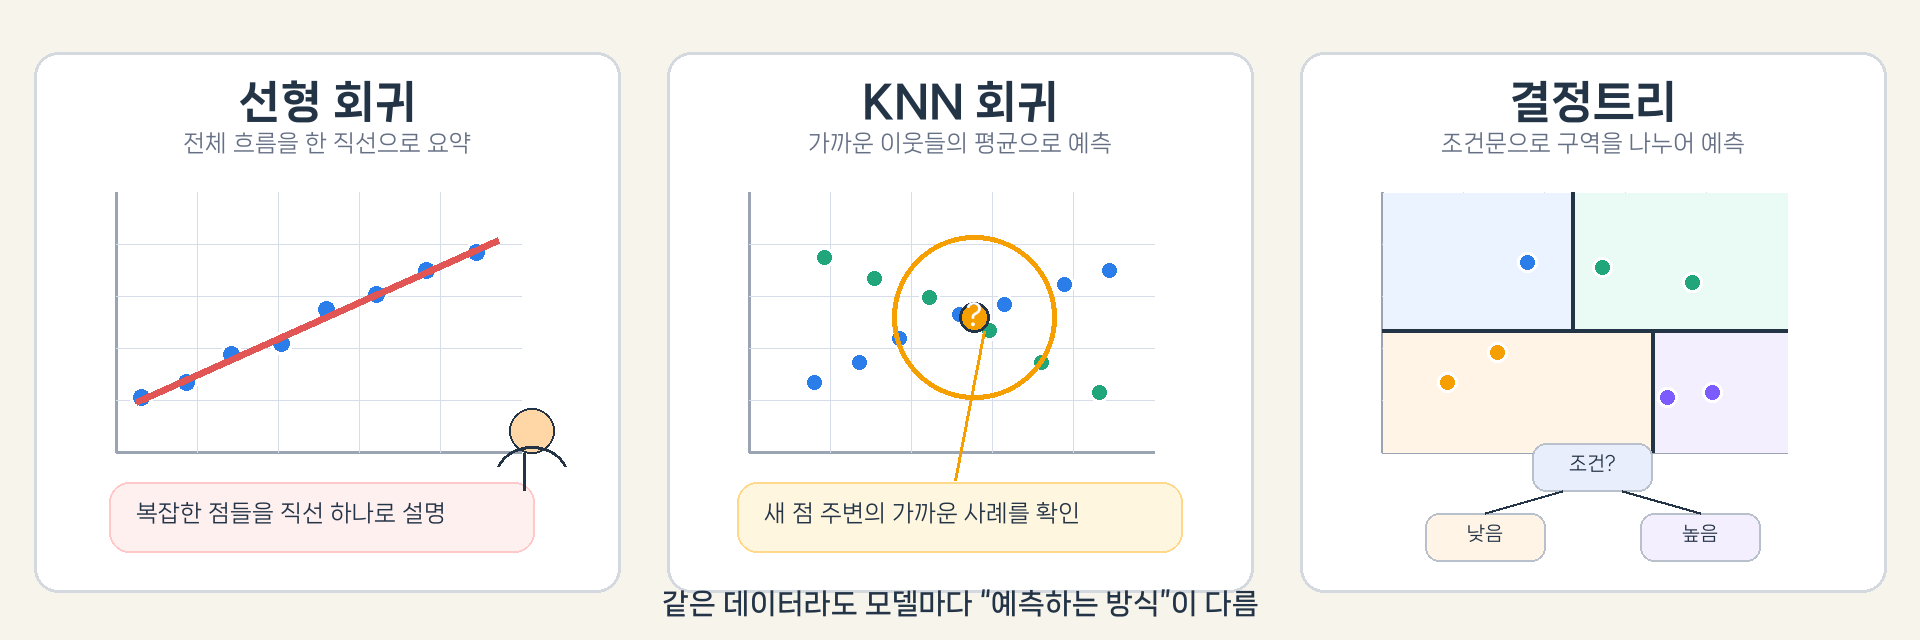
- 가중치 방식
- 입력된 여러 특성에 각각 다른 가중치를 부여하여 종합 점수 도출
- 예: 선형 모형, 로지스틱 회귀분석, 딥러닝
- 최근접 이웃(KNN)
- 의사결정나무 방식
- 한 번에 한 가지 특성을 기준으로 분기하는 과정을 반복해 최종 예측
- 예: CART, Random Forest, Gradient Boosting Tree
선형 회귀 모델 학습
- 선형 회귀(linear regression): 입력 변수의 가중합으로 값을 예측
- 단순하고 빠르며 기준 모델로 적합
- 복잡한 비선형 패턴은 충분히 잡지 못할 수 있음
from sklearn.linear_model import LinearRegression

linear = LinearRegression()
linear.fit(X_train, y_train)
회귀 예측값 확인
predict로 새 데이터의 예측값 생성- 실제값과 예측값을 나란히 비교
- 예측값 단위는 타깃 변수와 동일
y_pred_linear = linear.predict(X_test)
회귀 성능 지표: MAE
- MAE(Mean Absolute Error): 예측 오차 절댓값의 평균
- 작을수록 좋음
MAE=n1∑∣actual−predicted∣
from sklearn.metrics import mean_absolute_error

mean_absolute_error(y_test, y_pred_linear)
회귀 성능 지표: MSE
- MSE(Mean Squared Error): 예측 오차 제곱의 평균
- 작을수록 좋음
- 큰 오차에 더 큰 패널티를 부여
MSE=n1∑(actual−predicted)2
from sklearn.metrics import mean_squared_error

mean_squared_error(y_test, y_pred_linear)
회귀 성능 지표: R2
- R2: 전체 변동 중 모델이 설명한 비율
- 1에 가까울수록 좋음
R2=1−∑(actual−mean)2∑(actual−predicted)2
from sklearn.metrics import r2_score

r2_score(y_test, y_pred_linear)
k-최근접 이웃
- 새로운 데이터 포인트의 클래스나 값을 예측하기 위해 가장 가까운 K개의 이웃을 참조
- 회귀는 평균, 분류는 다수결로 예측 수행
- K가 작으면 노이즈에 민감해질 수 있음
- K가 커지면 계산 비용이 증가
- 훈련 단계가 없고, 계산이 예측 시점에 이루어지는 게으른 학습(lazy learning) 방식
KNN 회귀 모델 학습
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
knn = make_pipeline(
StandardScaler(),
KNeighborsRegressor(n_neighbors=7),
)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
mean_absolute_error(y_test, y_pred_knn)
r2_score(y_test, y_pred_knn)
의사결정나무
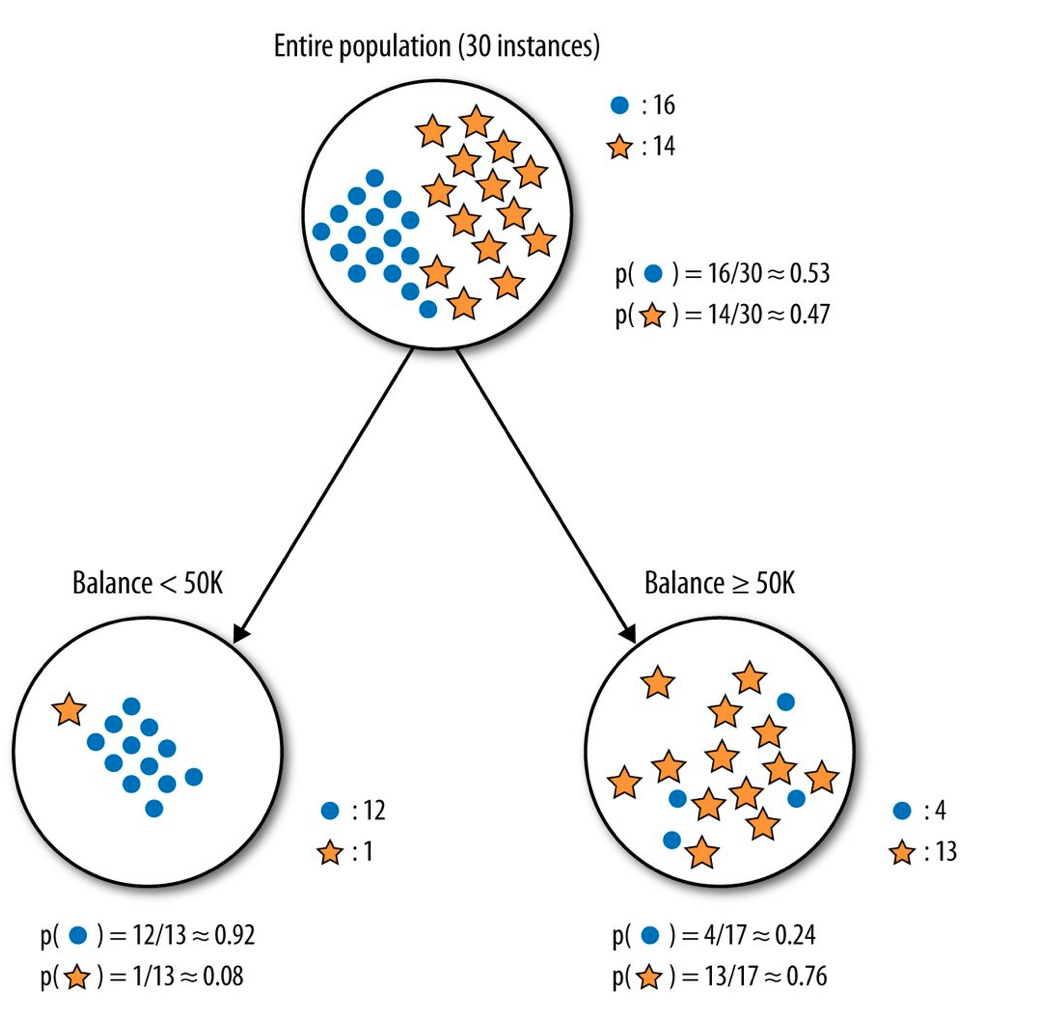
- 한 번에 한 가지 특성을 이용해 불순도(impurity)를 낮추는 방향으로 데이터셋을 두 개로 나눔
- 일정 기준을 만족할 때까지 분기를 반복
- 예: 불순도가 일정 값 이하
- 예: 데이터셋 크기가 일정 값 이하
- 예: 정해진 분기 횟수에 도달
- 스무고개 놀이와 같은 원리
- 해석이 쉽고, 복잡한 결정경계에도 잘 적용됨
- 여러 특성을 동시에 고려해야 하는 경우에는 잘 맞지 않을 수 있음
- 과대적합이 발생하기 쉬움
의사결정나무 모델 학습
from sklearn.tree import DecisionTreeRegressor

tree = DecisionTreeRegressor(max_depth=6, random_state=42)
tree.fit(X_train, y_train)

y_pred_tree = tree.predict(X_test)
mean_absolute_error(y_test, y_pred_tree)
r2_score(y_test, y_pred_tree)
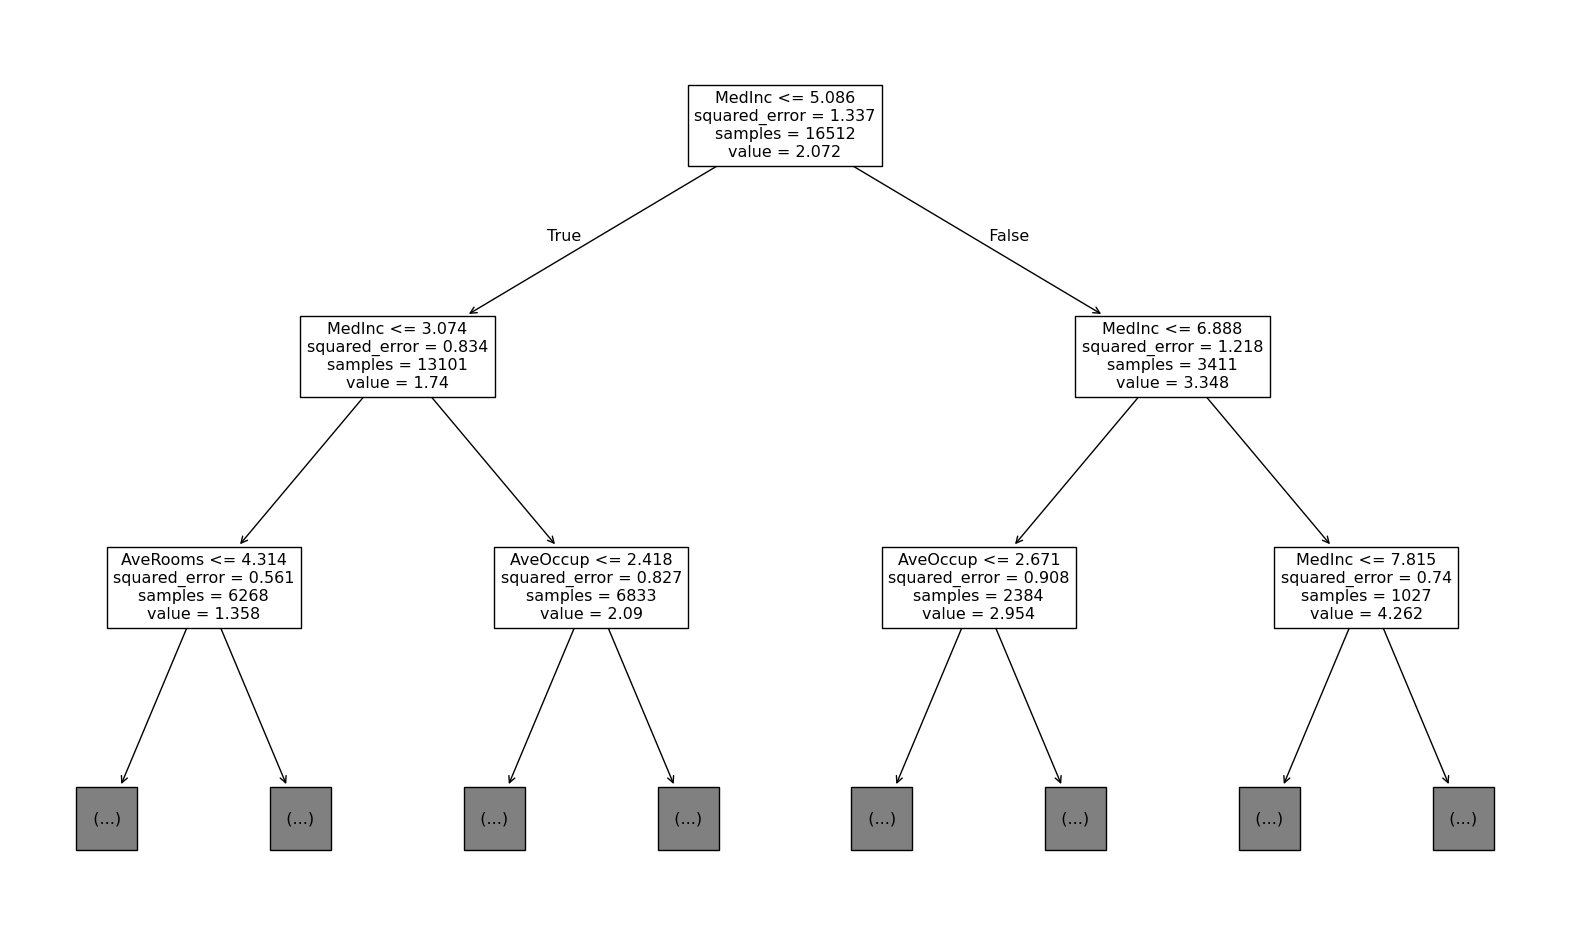
의사결정나무 시각화
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20, 12))
plot_tree(tree, feature_names=X.columns, max_depth=2);
어떤 방법을 쓸 것인가?
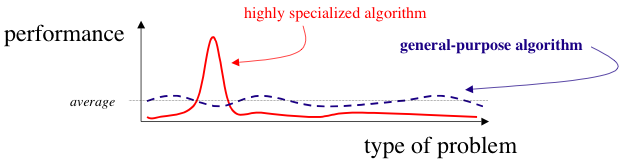
- 공짜 점심은 없다(no free lunch) 정리
- 모든 머신러닝 방법의 성능은 평균적으로 똑같음
- 모든 경우에 우수한 머신러닝 방법은 없음
- 데이터의 특성에 따라 더 잘 작동하는 방법이 다름
- 딥러닝은 주로 자연어, 이미지 등 비정형 데이터에 강점
- 의사결정나무는 주로 표 형태의 데이터에 강점
- 데이터의 특성을 어느 정도 짐작할 수는 있지만 미리 확인할 방법은 없음
- 여러 방법을 시도해보고 가장 성능이 좋은 방법이 그 데이터에 맞는 방법
퀴즈
실습 데이터: 전기차 에너지 소비량
- 동일한 전기차 모델로 수행한 수업용 합성 주행 시험 500건
- 주행 조건으로 100km당 에너지 소비량 예측
- 모든 입력 변수가 숫자형이므로 앞에서 사용한 회귀 코드를 그대로 적용
- 에너지 소비량 단위: kWh/100km
| 컬럼 | 설명 |
|---|
outside_temp_c | 외기 온도(°C) |
avg_speed_kmh | 평균 주행 속도(km/h) |
stop_count | 100km당 정차 횟수 |
route_grade_pct | 평균 도로 경사도(%) |
payload_kg | 탑승자와 화물 중량(kg) |
hvac_power_kw | 냉난방 평균 소비 전력(kW) |
tire_pressure_kpa | 평균 타이어 공기압(kPa) |
energy_consumption_kwh_100km | 100km당 에너지 소비량(kWh/100km) |
데이터 불러오기와 X, y 선택
import pandas as pd

df_ev = pd.read_excel("ev_energy.xlsx")
df_ev.head()
X = df_ev.drop(columns="energy_consumption_kwh_100km")
y = df_ev["energy_consumption_kwh_100km"]
- 위에서 사용한 데이터 분할과 회귀 모델 코드를 다시 실행하여 다음 문제에 답하세요.
