
테스트와 일반화
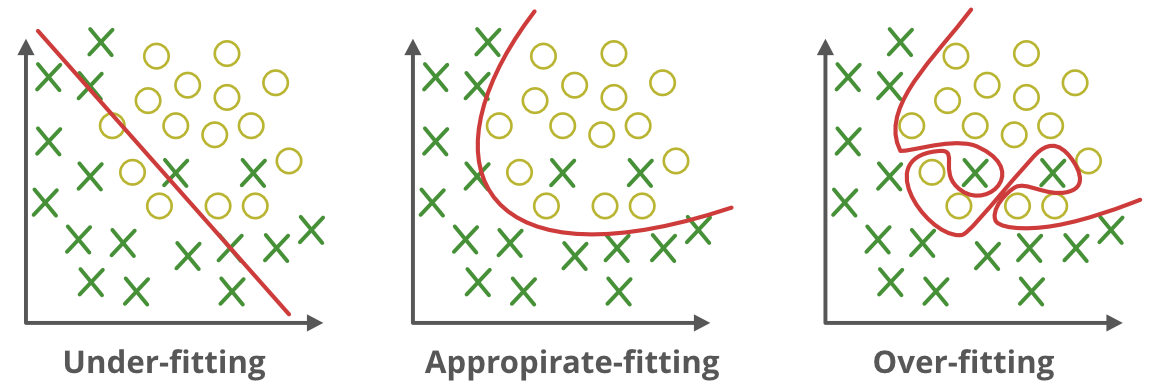
과소/과대 적합
- 과소적합(underfitting): 실제 패턴보다 모형이 단순
- 과대적합(overfitting): 실제 패턴보다 모형이 복잡
데이터 분할
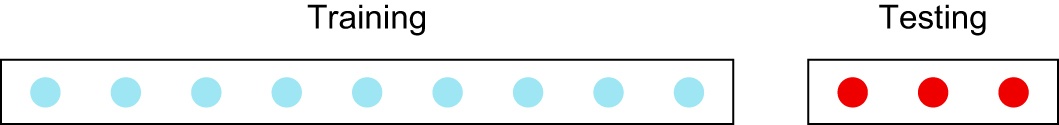
- 데이터를 Training과 Testing으로 분할 (보통 8:2 또는 9:1)
- 파라미터를 추정하는데는 많은 데이터가 필요하므로 Training을 크게
- Testing은 모형들의 성능을 구별할 정도만 되면 충분하므로 작게
- Training에 과적합되면 Testing에서 성능이 낮아짐
- Training과 Testing의 데이터가 섞이지 않도록 유의
과적합의 진단
- training set에서는 성능이 높지만 testing set에서는 성능이 낮은 경우
- → overfitting 되었을 가능성이 높음
- → 모형의 복잡도를 낮추는 방향으로 구조/하이퍼파라미터를 조정
- training set에서도 성능이 낮은 경우
- → underfitting이 되었을 가능성이 높음
- → 모형의 복잡도를 높이는 방향으로 구조/하이퍼파라미터를 조정
테스트
테스트 데이터 뽑기:
x_test_binary, y_test_binary = filter_binary(x_test, y_test, 0, 1)

(x_test_binary.shape, y_test_binary.shape)
실행 결과
((2115, 28, 28), (2115,))
평가:
test_results = model.evaluate(
    x_test_binary,
    y_test_binary,
)
test_results
실행 결과
67/67 ━━━━━━━━━━━━━━━━━━━━ 0s 5ms/step - accuracy: 0.9901 - loss: 0.4039
[0.40392202138900757, 0.9900709390640259]
테스트 손실은 약 0.404, 테스트 정확도는 약 99.0%. 훈련에 사용하지 않은 테스트 이미지에서도 높은 정확도.
실습 준비

직접 손글씨 입력해보기
- 그림판에서 직접 손글씨 입력
- 크기 조정(픽셀, 28, 28, 가로세로 비율 X)
- 오른쪽 하단 확대/축소로 확대
- 색 채우기 (검은색)
- 브러시(색 1 → 흰 색)
- 검은 바탕에 흰 글씨로 0 또는 1
- hand.png로 저장
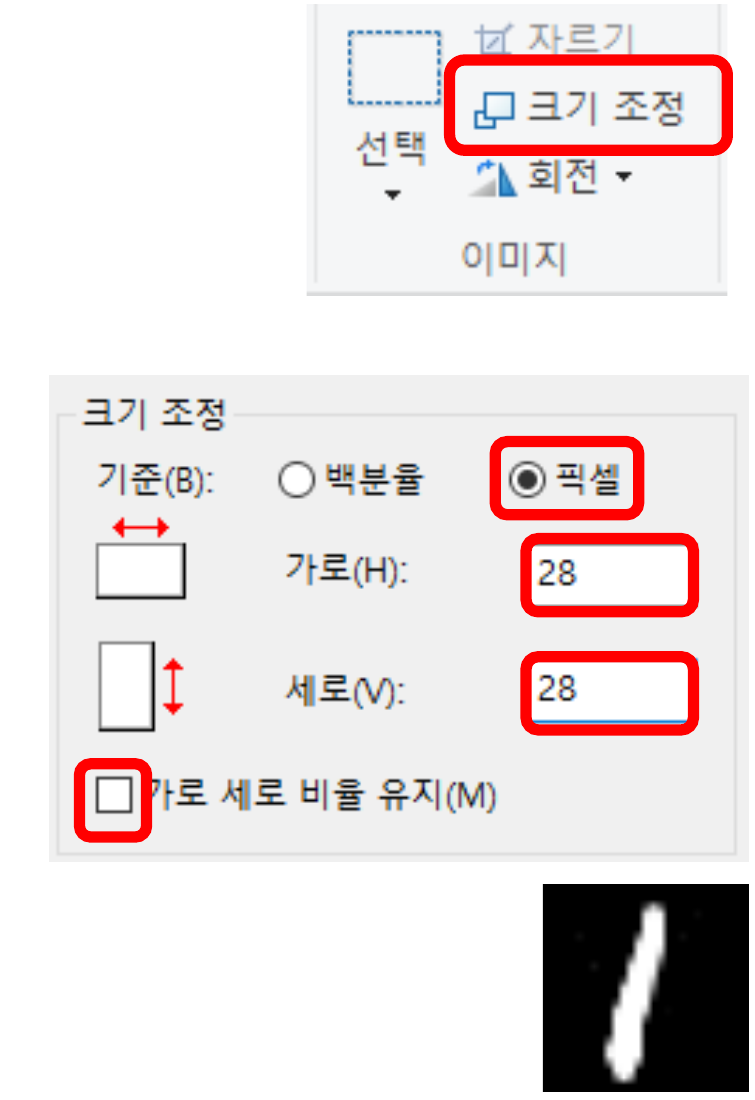
이번 예측에 사용할 28×28 손글씨 이미지:

손글씨 이미지 불러오기
import cv2 as cv

x = cv.imread("hand.png", cv.IMREAD_GRAYSCALE)
x.shape  # 손글씨 이미지의 형태
실행 결과
(28, 28)
모델은 여러 이미지를 묶은 배치 형태를 입력으로 받으므로 맨 앞에 배치 차원을 추가.
x_batch = np.expand_dims(x, axis=0)
x_batch.shape  # 배치 차원을 추가한 형태
실행 결과
(1, 28, 28)
hand_prediction = model.predict(x_batch)
hand_prediction
실행 결과
1/1 ━━━━━━━━━━━━━━━━━━━━ 0s 157ms/step
array([[0.2689745]], dtype=float32)
클래스 1의 확률은 약 26.9%. 0.5를 기준으로 분류하면 손글씨를 클래스 0으로 예측.
차원의 추가 방법들
(
    np.expand_dims(x, axis=0).shape,  # 0번 차원 확장
    x[np.newaxis, :, :].shape,  # 새 축 추가
    x.reshape(1, 28, 28).shape,  # 배치 크기 1로 형태 변경
)
실행 결과
((1, 28, 28), (1, 28, 28), (1, 28, 28))
세 방법 모두 같은 (1, 28, 28) 형태를 생성.