
조기 종료와 모델 체크포인트
조기 종료 early stopping
- 검증 성능이 더 이상 개선되지 않을 때 최대 에포크 전에 훈련을 끝내는 방법
- 훈련 시간을 줄이고 과대적합이 심해지기 전의 파라미터를 선택하는 정칙화 효과
- 훈련 손실은 계속 감소해도 검증 손실은 어느 시점부터 다시 증가 가능
- 훈련 손실 대신 검증 손실이나 검증 정확도처럼 일반화 성능을 나타내는 값을 관찰
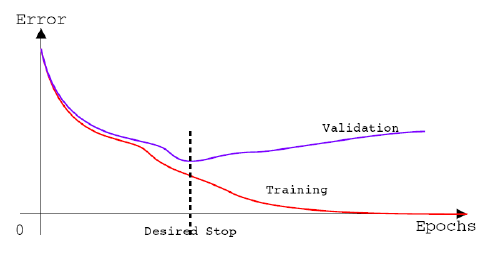
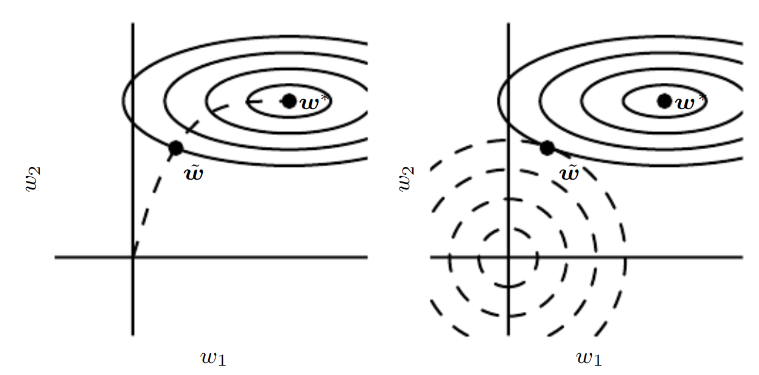
- 파라미터는 초기값에서 시작해 에포크마다 갱신
- 훈련을 일찍 끝내면 파라미터가 초기값에서 지나치게 멀어지는 정도를 제한
테스트 데이터는 마지막 평가에 사용
- 조기 종료 기준은 검증 데이터에서 계산
- 테스트 데이터를 매 에포크 확인해 중단 시점을 고르면 테스트 성능이 모델 선택에 반영
- 모델 선택에 사용한 테스트 데이터는 최종 평가의 독립성을 상실
중단 기준 설정
keras.callbacks.EarlyStopping은 에포크가 끝날 때 관찰값의 개선 여부를 확인
| 인자 | 역할 | 예시 |
|---|---|---|
monitor | 관찰할 값 | "val_loss" |
mode | 개선 방향 | 손실은 "min", 정확도는 "max" |
min_delta | 개선으로 인정할 최소 변화량 | 0.001 |
patience | 개선 없이 기다릴 에포크 수 | 3 |
restore_best_weights | 종료 후 가장 좋았던 에포크의 가중치 복원 | True |
- 가장 작은 검증 손실이 나온 시점은 2번째 에포크
patience=3이면 3~5번째 에포크의 개선 여부를 확인- 세 에포크 동안 개선이 없으면 5번째 에포크가 끝난 뒤 중단
| 에포크 | 검증 손실 | 처리 |
|---|---|---|
| 1 | 0.40 | 현재 최적 |
| 2 | 0.31 | 최적값 갱신 |
| 3 | 0.33 | 1회 대기 |
| 4 | 0.32 | 2회 대기 |
| 5 | 0.34 | 3회 대기 후 중단 |
restore_best_weights의 기본값은FalseTrue로 설정하면 가장 좋았던 에포크의 가중치를 현재model객체에 복원False이면 중단 직전 에포크의 가중치를 유지
모델 체크포인트 model checkpoint
keras.callbacks.ModelCheckpoint는 훈련 중 모델이나 가중치를 파일로 저장save_best_only=True이면 관찰값이 개선될 때만 저장- 같은 파일 경로를 사용하면 이전 최적 파일을 새 최적 파일로 교체
- 조기 종료와 체크포인트는 서로 다른 역할
| 기능 | EarlyStopping | ModelCheckpoint |
|---|---|---|
| 훈련 중단 | 가능 | 불가 |
| 최적 가중치를 현재 모델에 복원 | restore_best_weights=True | 자동 복원하지 않음 |
| 런타임 종료 후 복구할 파일 생성 | 생성하지 않음 | 생성 |
-
전체 모델 저장: 파일명을
.keras로 끝내고keras.models.load_model()로 불러오기 -
가중치만 저장:
save_weights_only=True, 파일명을.weights.h5로 끝내고 같은 구조의 모델에서load_weights()호출 -
두 콜백을 함께 사용하면 불필요한 훈련을 멈추고 가장 좋았던 모델을 파일로 보존 가능
콜백 실습
- MNIST 훈련 데이터 60,000개를 불러오기
validation_split=0.2로 훈련 데이터의 20%를 검증 데이터로 분리- 테스트 데이터는 훈련이 끝난 뒤 체크포인트의 예측을 확인할 때만 사용
import os

os.environ["KERAS_BACKEND"] = "torch"

import keras
import numpy as np

(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
keras.utils.set_random_seed(812)로 모델의 초기값을 고정- 학습률은 검증 손실의 변화를 빠르게 확인하기 위해 큰 값인
0.1로 지정
keras.utils.set_random_seed(812)

model = keras.models.Sequential(
    [
        keras.layers.Rescaling(1 / 255),
        keras.layers.Flatten(),
        keras.layers.Dense(128, activation="relu"),
        keras.layers.Dense(10),
    ]
)
model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=0.1),
    loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=["accuracy"],
)
- 두 콜백은 같은
val_loss를 관찰 EarlyStopping의 나머지 인자는 기본값인min_delta=0,patience=0,restore_best_weights=False를 사용- 검증 손실이 한 에포크라도 개선되지 않으면 훈련을 종료
- 현재
model을 최적 가중치로 되돌리지는 않음
early_stopping = keras.callbacks.EarlyStopping(
    monitor="val_loss",
)

model_checkpoint = keras.callbacks.ModelCheckpoint(
    filepath="best_model.keras",
    monitor="val_loss",
    save_best_only=True,
)

history = model.fit(
    x_train,
    y_train,
    batch_size=128,
    epochs=50,  # 조기 종료가 없을 때의 최대 에포크
    validation_split=0.2,
    callbacks=[early_stopping, model_checkpoint],
)
실행 결과
Epoch 1/50
375/375 ━━━━━━━━━━━━━━━━━━━━ 3s 8ms/step - accuracy: 0.8344 - loss: 0.7997 - val_accuracy: 0.9007 - val_loss: 0.4072
Epoch 2/50
375/375 ━━━━━━━━━━━━━━━━━━━━ 3s 8ms/step - accuracy: 0.8813 - loss: 0.4965 - val_accuracy: 0.8980 - val_loss: 0.5471
- 1번째 에포크의 검증 손실은
0.4072, 2번째 에포크는0.5471 - 검증 손실이 개선되지 않았고
patience=0이므로 2번째 에포크가 끝난 뒤 즉시 종료 restore_best_weights=False이므로 메모리의model에는 마지막인 2번째 에포크의 가중치가 남음save_best_only=True인ModelCheckpoint는 검증 손실이 더 작았던 1번째 에포크의 모델을best_model.keras에 저장- 난수 연산과 실행 장치에 따라 구체적인 손실값과 중단 에포크는 달라질 수 있음
- 확인할 핵심은 검증 손실이 개선되지 않은 에포크 뒤 기본 설정의 조기 종료가 작동한다는 점
저장한 모델 불러오기
ModelCheckpoint가 저장한 전체 모델은 새 객체로 불러오기 가능
best_model = keras.models.load_model("best_model.keras")
best_model.predict(x_test[[0]])
실행 결과
array([[-18.8172   ,  -3.5413115,  19.47736  ,  14.68325  ,  -6.1147866,
        -12.530763 , -12.839593 ,  39.227615 , -18.692066 ,   1.3114679]],
      dtype=float32)
- 테스트 이미지 1개에 대해 숫자 0~9의 로짓 10개를 출력
- 가장 큰 값은 인덱스 7의
39.227615이므로 예측 클래스는 숫자 7. load_model()로 검증 손실이 가장 작았던 체크포인트를 별도 모델로 복원한 결과.