
옵티마이저
옵티마이저
옵티마이저(optimizer)는 손실의 그래디언트를 이용해 모델 파라미터를 수정하는 규칙. 기본적인 확률적 경사하강법(SGD)에 이동 방향의 누적값이나 파라미터별 학습률을 추가하면 진동을 줄이거나 학습 속도를 조절할 수 있음.
모멘텀
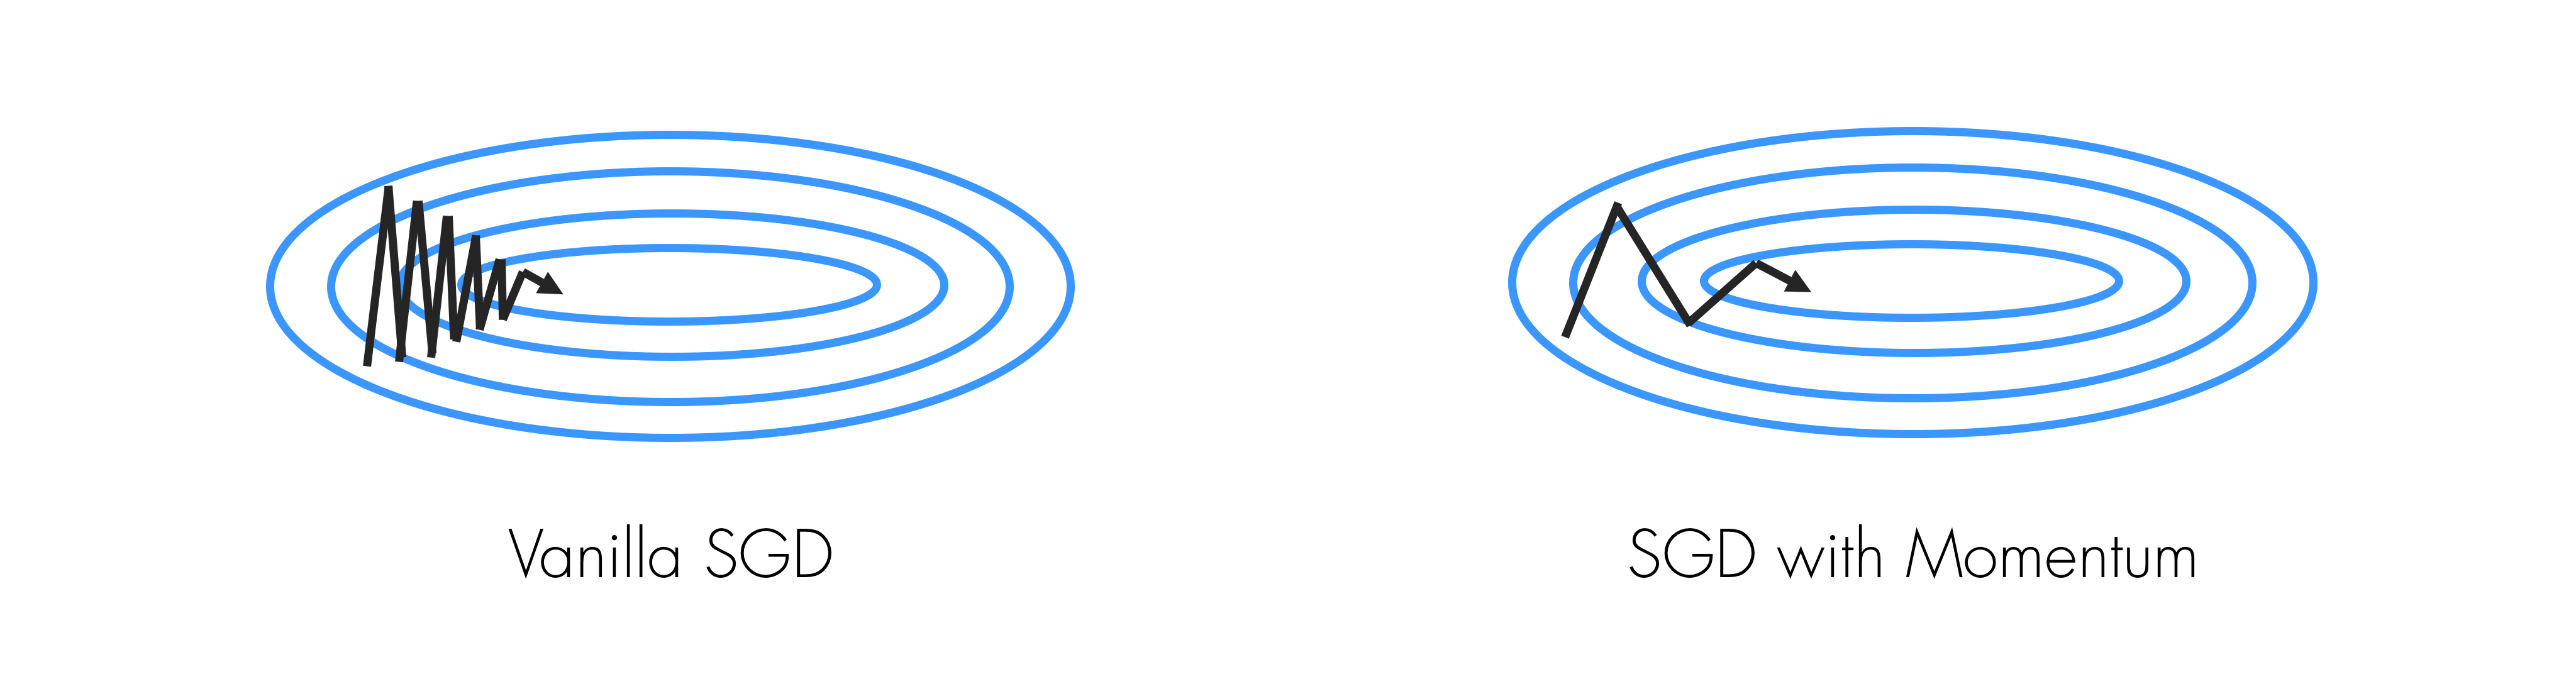
모멘텀(momentum)은 현재 그래디언트만 사용하지 않고 이전 업데이트 방향을 이동 평균으로 누적.
는 현재 그래디언트, 는 이전 방향을 유지하는 비율. 그래디언트 방향이 일정한 축에서는 이동을 가속하고, 방향이 자주 바뀌는 축에서는 진동을 줄이는 데 도움. 국소 최소점이나 안장점 탈출을 보장하는 방법은 아님.
적응적 학습률
적응적 학습률(adaptive learning rate) 옵티마이저는 파라미터마다 최근 그래디언트의 크기를 반영해 실제 이동 폭을 조절.
Adagrad
Adagrad는 그래디언트 제곱을 계속 누적.
- 자주 큰 그래디언트를 받은 파라미터의 이동 폭 감소
- 드물게 갱신되는 파라미터에는 상대적으로 큰 이동 폭 유지
- 누적값 가 계속 증가하므로 학습률이 지나치게 작아질 수 있음
- 은 0으로 나누는 문제를 막는 작은 상수
RMSProp
RMSProp은 모든 과거 그래디언트를 같은 비중으로 누적하지 않고 지수 이동 평균 사용.
가 1에 가까울수록 과거 그래디언트의 영향이 오래 유지. Adagrad처럼 분모가 계속 누적되어 증가하는 현상을 완화.
Adam
Adam은 그래디언트의 1차 모멘트와 제곱 그래디언트의 2차 모멘트를 함께 추정. 초기 추정값이 0에 치우치는 현상을 보정한 뒤 파라미터별 이동 폭을 계산.
- 1차 모멘트: 모멘텀과 비슷하게 이동 방향을 누적
- 2차 모멘트: RMSProp과 비슷하게 최근 그래디언트 크기를 누적
- 두 추정값의 조합으로 방향과 이동 폭을 함께 조절
Adam이 모든 과제에서 SGD보다 좋은 것은 아님. 검증 성능과 학습 안정성을 기준으로 옵티마이저와 학습률을 함께 선택해야 함.
RAdam
RAdam(Rectified Adam)은 학습 초기에 Adam의 적응적 학습률 분산이 불안정할 수 있는 점을 보정. 초기 학습의 안정성을 높이기 위한 변형이지만 모든 모델에서 성능 향상을 보장하지는 않음.
Lookahead
Lookahead는 빠른 가중치와 느린 가중치 두 집합을 사용.
- 빠른 가중치에 기본 옵티마이저를 번 적용
- 느린 가중치를 빠른 가중치 방향으로 일부 이동
- 보간한 느린 가중치에서 다음 탐색 시작
는 빠른 가중치, 는 느린 가중치, 는 두 가중치를 섞는 비율. 빠른 가중치의 짧은 탐색을 느린 가중치가 완화해 업데이트 경로를 안정화할 수 있음.
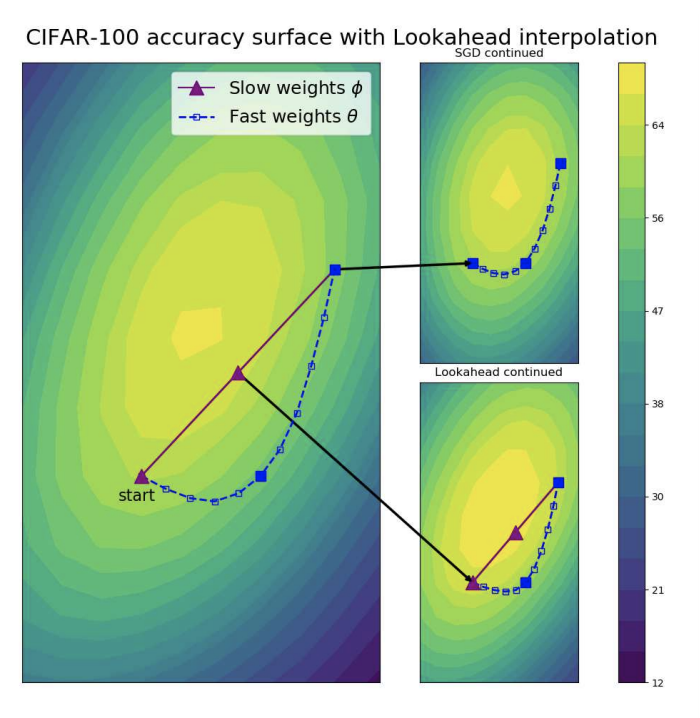
Lookahead는 기본 옵티마이저를 대체하기보다 감싸서 사용하는 방식. 사용할 프레임워크에서 구현 제공 여부와 인수 의미를 확인해야 함.