
혼동 행렬
실습 준비
import os

os.environ["KERAS_BACKEND"] = "torch"

import keras
import numpy as np
from sklearn.metrics import (
    accuracy_score,
    confusion_matrix,
    f1_score,
    precision_score,
    recall_score,
)

def filter_binary(x, y, neg_cls, pos_cls):
    cond = (y == neg_cls) | (y == pos_cls)
    x_bin = x[cond]
    y_bin = np.where(y[cond] == neg_cls, 0, 1)
    return x_bin, y_bin
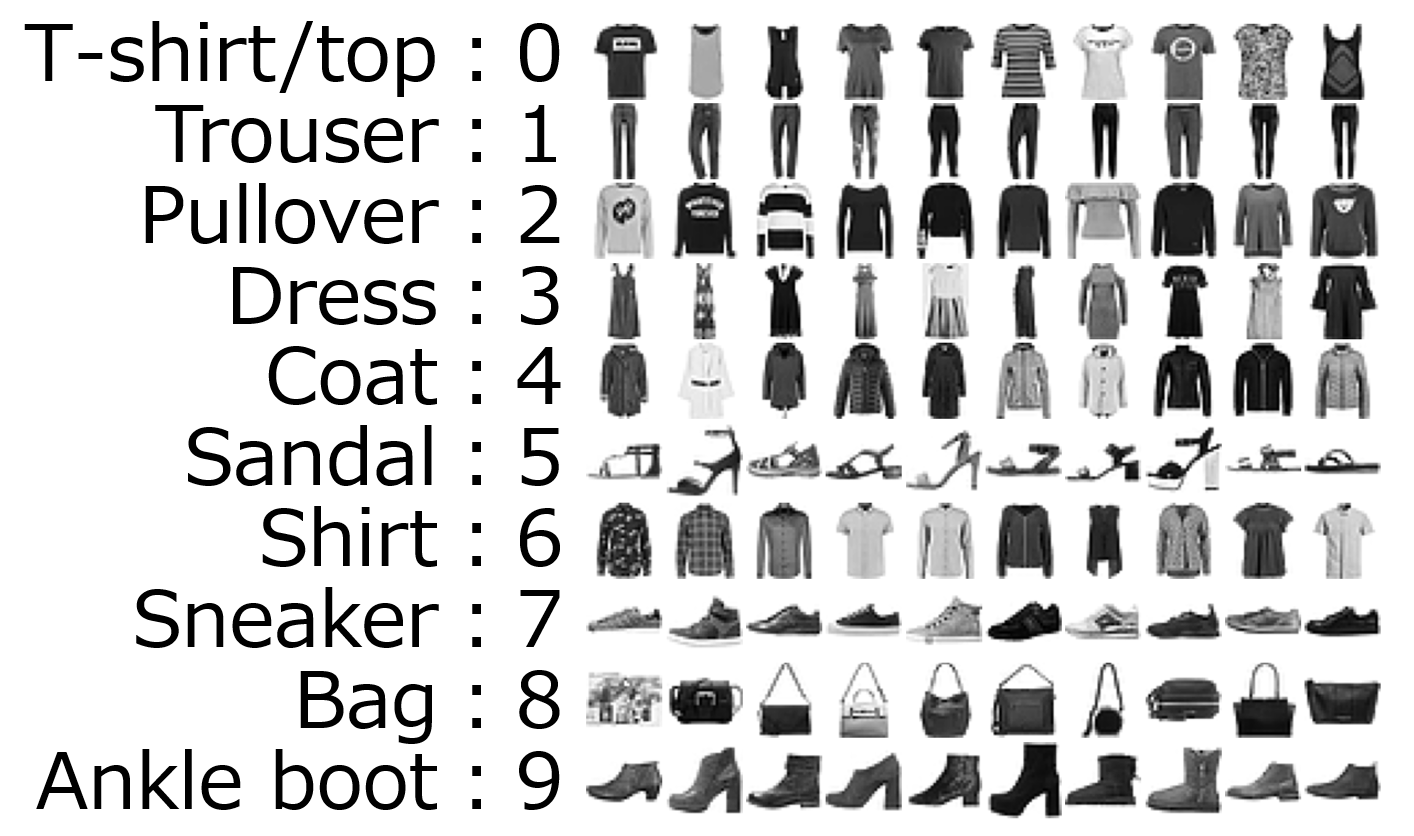
Fashion MNIST
- MNIST와 같은 28×28 흑백 이미지 형식의 의류 분류 데이터셋
(x_train, y_train), (x_test, y_test) = (
    keras.datasets.fashion_mnist.load_data()
)
x_train.shape # 훈련 이미지 형태
실행 결과
(60000, 28, 28)
y_train.shape # 훈련 레이블 형태
실행 결과
(60000,)
x_test.shape # 테스트 이미지 형태
실행 결과
(10000, 28, 28)
y_test.shape # 테스트 레이블 형태
실행 결과
(10000,)
- 스웨터(2)와 셔츠(6)
x_train_binary, y_train_binary = filter_binary(
    x_train, y_train, 2, 6  # 스웨터는 0, 셔츠는 1로 변환
)
x_test_binary, y_test_binary = filter_binary(
    x_test, y_test, 2, 6
)
x_train_binary.shape # 이항 분류 훈련 이미지 형태
실행 결과
(12000, 28, 28)
y_train_binary.shape # 이항 분류 훈련 레이블 형태
실행 결과
(12000,)
x_test_binary.shape # 이항 분류 테스트 이미지 형태
실행 결과
(2000, 28, 28)
y_test_binary.shape # 이항 분류 테스트 레이블 형태
실행 결과
(2000,)
y_train_binary[:5] # 변환한 훈련 레이블 일부
실행 결과
array([0, 0, 1, 0, 1])
Fashion MNIST 모델 학습
keras.utils.set_random_seed(812)  # 실행 결과 재현용 난수 초기값

model = keras.models.Sequential(
    [
        keras.layers.Rescaling(1 / 255),  # 픽셀값을 0~1 범위로 변환
        keras.layers.Flatten(),  # 28×28 이미지를 길이 784의 벡터로 변환
        keras.layers.Dense(1, activation="sigmoid"),  # 셔츠일 확률 하나를 출력
    ]
)

model.compile(
    optimizer=keras.optimizers.SGD(learning_rate=0.001),
    loss="binary_crossentropy",
    metrics=["accuracy"],
)

history = model.fit(
    x_train_binary,
    y_train_binary,
    epochs=5,
    batch_size=32,
)
실행 결과
Epoch 1/5
375/375 ━━━━━━━━━━━━━━━━━━━━ 2s 4ms/step - accuracy: 0.6028 - loss: 0.6686
Epoch 2/5
375/375 ━━━━━━━━━━━━━━━━━━━━ 1s 4ms/step - accuracy: 0.7111 - loss: 0.6069
Epoch 3/5
375/375 ━━━━━━━━━━━━━━━━━━━━ 2s 4ms/step - accuracy: 0.7385 - loss: 0.5742
Epoch 4/5
375/375 ━━━━━━━━━━━━━━━━━━━━ 2s 4ms/step - accuracy: 0.7566 - loss: 0.5534
Epoch 5/5
375/375 ━━━━━━━━━━━━━━━━━━━━ 2s 5ms/step - accuracy: 0.7667 - loss: 0.5386
5번째 에포크의 훈련 정확도는 약 76.7%, 훈련 손실은 약 0.539.
정답과 확률 수집
y_prob = model.predict(x_test_binary).reshape(-1)
y_prob[:5]  # 양성 확률 일부
실행 결과
array([0.09236811, 0.60869956, 0.557815  , 0.2914975 , 0.50963134],
      dtype=float32)
y_true = y_test_binary
y_true[:5]  # 실제 정답 일부
실행 결과
array([0, 1, 1, 0, 0])
threshold_05 = 0.5  # 기본 문턱값
y_pred_05 = np.where(y_prob >= threshold_05, 1, 0)
y_pred_05[:5]  # 문턱값 0.5의 예측 일부
실행 결과
array([0, 1, 1, 0, 1])
문턱값 0.5에서 다섯 번째 사례는 실제 스웨터(0)지만 셔츠(1)로 예측.
혼동 행렬 계산
cm_05 = confusion_matrix(y_true, y_pred_05)
cm_05
실행 결과
array([[806, 194],
       [271, 729]])
진음성(TN) 806건, 위양성(FP) 194건, 위음성(FN) 271건, 진양성(TP) 729건.
혼동 행렬 confusion matrix
| 예측 | |||
|---|---|---|---|
| 음성 (0) | 양성 (1) | ||
| 실제 | 음성 (0) | 진음성 True Negative TN | 위양성 False Positive FP |
| 양성 (1) | 위음성 False Negative FN | 진양성 True Positive TP |
진/위 양성/음성
- 혼동행렬에서 양성/음성은 예측을 기준으로 말함
- 현실에서는 실제로 어떤지 알 수 없는 경우가 많음
- 진(True) → 예측이 맞음
- 위(False) → 예측이 틀림
정확도 accuracy
| 예측 음성 (0) | 예측 양성 (1) | |
|---|---|---|
| 실제 음성 (0) | TN | FP |
| 실제 양성 (1) | FN | TP |
- 전체 중에 예측이 맞은 비율
- 특별히 음성/양성 구분에 관심이 없는 경우 사용
- 그러나 대부분은 양성에 더 관심이 있음
accuracy_05 = accuracy_score(y_true, y_pred_05)
accuracy_05  # 정확도
실행 결과
0.7675
전체 2,000건 중 1,535건을 맞혀 정확도 76.75%.
정밀도 precision
| 예측 음성 (0) | 예측 양성 (1) | |
|---|---|---|
| 실제 음성 (0) | - | FP |
| 실제 양성 (1) | - | TP |
- 양성 예측 중에 맞은 비율
- 양성 예측이 중요한 경우 (예: 채용, 투자, 추천, 결혼 등)
precision_05 = precision_score(y_true, y_pred_05)
precision_05  # 정밀도
실행 결과
0.789815817984832
셔츠로 예측한 사례 중 약 79.0%가 실제 셔츠.
재현도 recall
| 예측 음성 (0) | 예측 양성 (1) | |
|---|---|---|
| 실제 음성 (0) | - | - |
| 실제 양성 (1) | FN | TP |
- 실제 양성 중 찾아낸 비율
- 양성을 찾아 내는 것이 중요한 경우 (예: 방역)
- 의학 등에서는 민감도(sensitivity)라고도 함
- 또는 TPR(True Positive Rate)
recall_05 = recall_score(y_true, y_pred_05)
recall_05  # 재현도
실행 결과
0.729
실제 셔츠 중 72.9%를 셔츠로 탐지.
특이도 specificity
- 실제 음성 중 찾아낸 비율
- 음성을 찾아 내는 것이 중요한 경우 (예: 방역)
- 대체로 양성 예측을 보수적으로 하면 특이도가 높아진다
- FPR(False Positive Rate):
specificity_05 = recall_score(y_true, y_pred_05, pos_label=0)
specificity_05  # 특이도
실행 결과
0.806
실제 스웨터 중 80.6%를 스웨터로 판별.
특이도가 낮을 경우 문제점
- 질병 검사에서는 음성이 양성보다 훨씬 많음
- 특이도가 낮으면 정밀도가 떨어짐
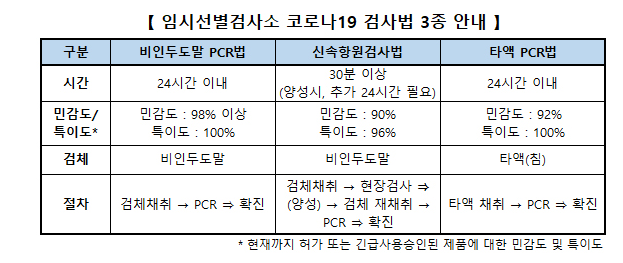
- 예) 실제 양성이 1%인 경우
| 예측 | |||
|---|---|---|---|
| 음성 | 양성 | ||
| 실제 | 음성 | 9900 | 0 |
| 양성 | 2 | 98 |
- 특이도 100%
- 민감도 98%
- 정밀도 100%
| 예측 | |||
|---|---|---|---|
| 음성 | 양성 | ||
| 실제 | 음성 | 9504 | 396 |
| 양성 | 10 | 90 |
- 특이도 96%
- 민감도 90%
- 정밀도 18.5%
F1
- 정밀도(p)와 재현도(r)의 조화 평균
- 조화평균: 역수의 평균의 역수
- 산술평균보다 낮은 값에 민감
f1_05 = f1_score(y_true, y_pred_05)
f1_05  # F1 점수
실행 결과
0.7581903276131046
문턱값 0.5에서 정밀도와 재현도의 조화 평균은 약 75.8%.
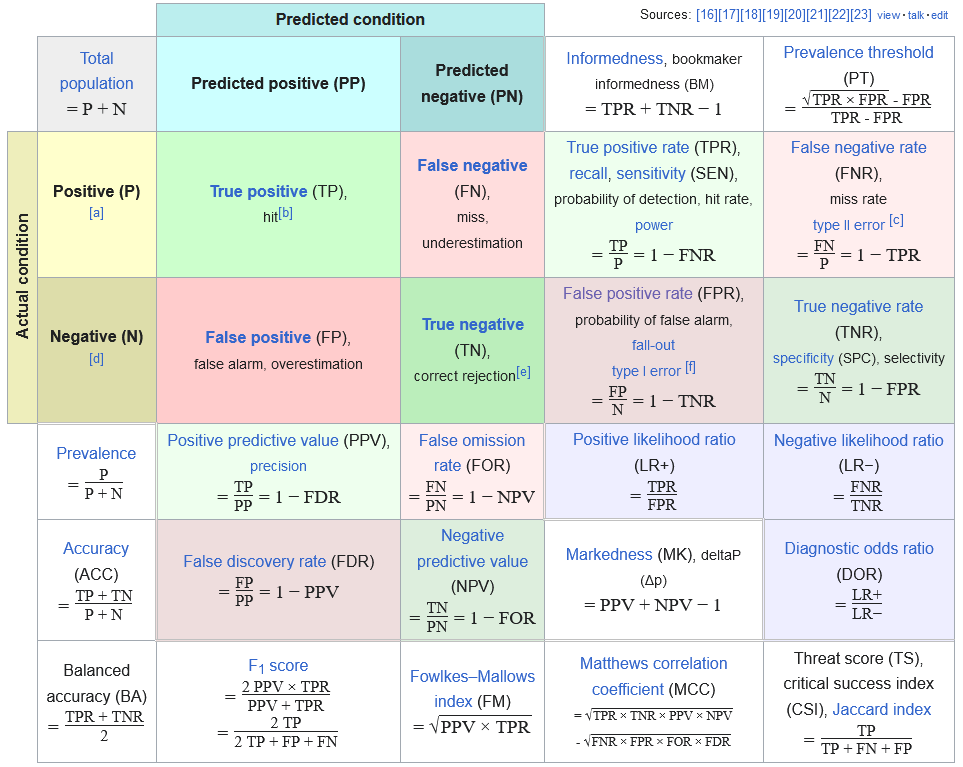
혼동 행렬 지표 요약
퀴즈
다음 혼동 행렬을 사용해 문제를 풉니다.
| 예측 음성 (0) | 예측 양성 (1) | |
|---|---|---|
| 실제 음성 (0) | 806 (TN) | 194 (FP) |
| 실제 양성 (1) | 271 (FN) | 729 (TP) |