
컴퓨터 비전의 과업
이미지 분류
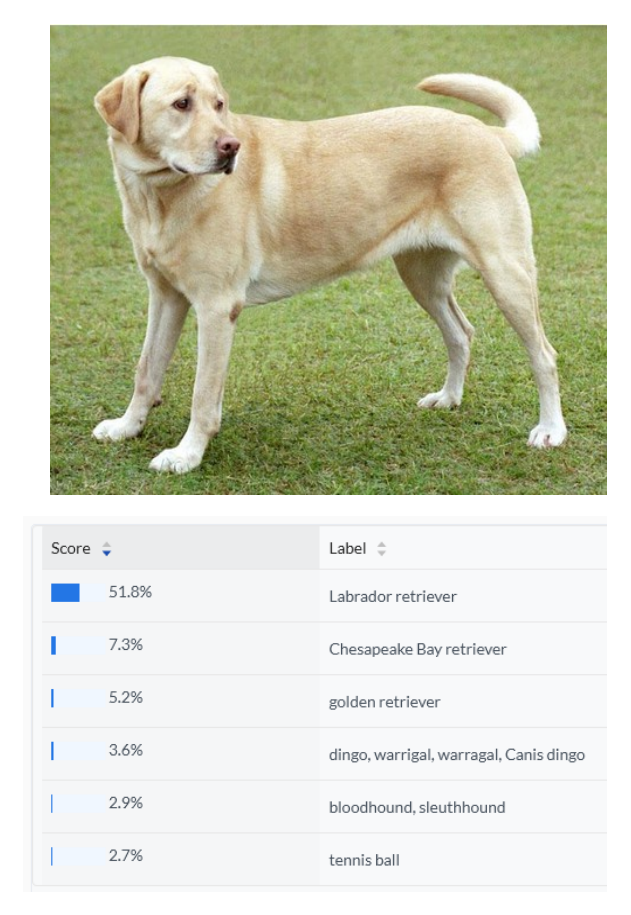
이미지 분류(image classification): 이미지 전체를 미리 정한 범주 중 하나로 분류
- 핵심 질문: 사진에 찍힌 것은 무엇인가?
- 출력: 범주별 확률과 최종 예측 범주
- 응용: 고양이와 강아지 분류, 부품 종류 분류, 정상·불량 판정
객체 탐지
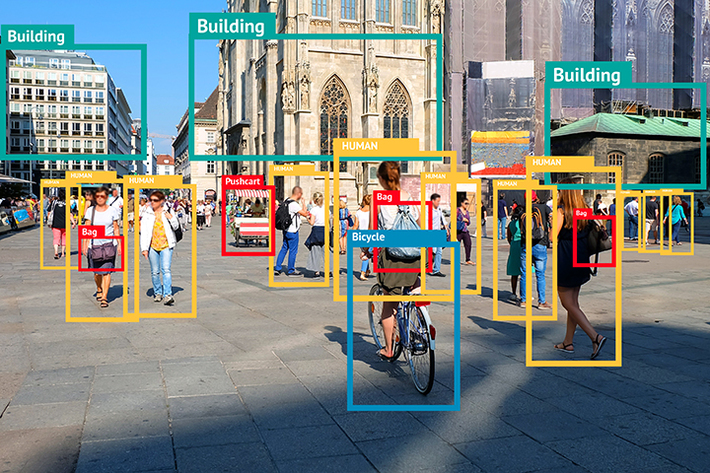
객체 탐지(object detection): 한 이미지에서 여러 객체의 종류와 위치를 함께 찾기
- 핵심 질문: 무엇이 어디에 있는가?
- 출력: 객체 범주, 신뢰도, 경계 상자(bounding box)
- 응용:
- 자율 주행: 보행자, 자동차, 신호등 탐지
- 제조: 부품 위치 확인과 개수 계산
- 스포츠: 선수와 공의 위치 파악
- 안전 관리: 위험 구역의 사람이나 장비 탐지
광학 문자 인식
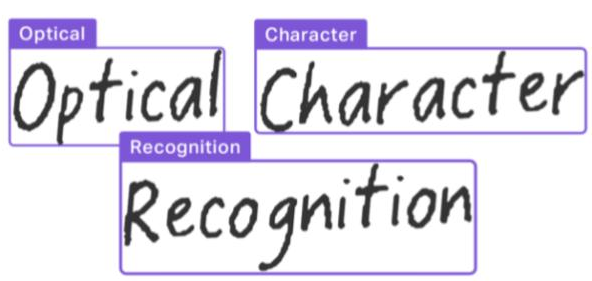
광학 문자 인식(Optical Character Recognition, OCR): 이미지에 포함된 문자를 컴퓨터가 처리 가능한 텍스트로 변환
- 핵심 질문: 이미지에 어떤 문자가 있는가?
- 출력: 추출된 텍스트와 텍스트의 위치
- 응용:
- 영수증·청구서 전산화
- 신분증 인식
- 차량 번호판 인식
이미지 분할
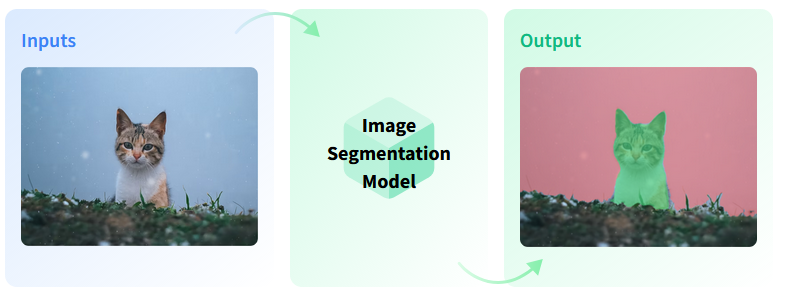
이미지 분할(image segmentation): 이미지의 각 픽셀을 객체나 영역에 대응시키는 과업임.
- 핵심 질문: 이미지의 각 픽셀은 어떤 객체나 영역에 속하는가?
- 출력: 픽셀별 영역 레이블
- 종류:
- 의미론적 분할: 같은 범주의 픽셀을 같은 영역으로 표시
- 인스턴스 분할: 같은 범주의 객체도 개별 객체로 구분
- 응용:
- 화상 회의 배경 제거
- 의료 영상의 장기·병변 구분
- 도로 영역 분석
경계 상자를 출력하는 객체 탐지보다 객체의 모양을 정밀하게 표현할 수 있음.
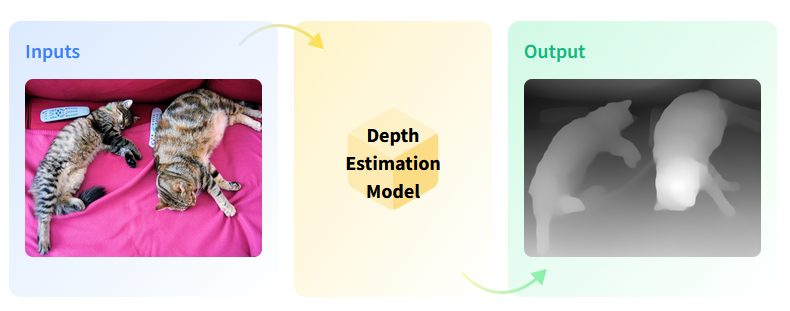
깊이 추정
깊이 추정(depth estimation): 카메라와 장면 사이의 거리 또는 장면의 앞뒤 구조를 예측
- 핵심 질문: 이미지 속 객체나 장소가 얼마나 떨어져 있는가?
- 출력: 픽셀별 깊이 지도 또는 객체까지의 거리
- 응용:
- 로봇 이동
- 자율 주행
- 물체 크기·부피 측정
- 3차원 장면 복원
자세 추정
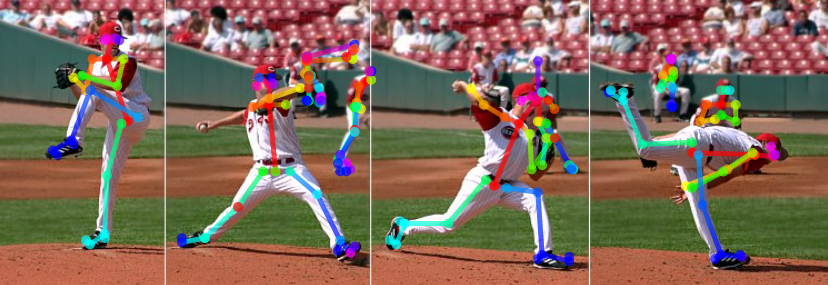
자세 추정(pose estimation): 사람이나 동물의 관절과 같은 주요 지점(keypoint)의 위치를 찾기
- 핵심 질문: 사람이나 동물의 관절이 어디에 있는가?
- 출력: 어깨, 팔꿈치, 손목, 무릎 등 주요 지점의 좌표
- 응용:
- 운동 자세 분석
- 작업자 안전 관리
- 동작 인식
- 사람과 로봇의 상호작용
객체 추적
객체 추적(object tracking): 동영상의 여러 프레임에서 같은 객체를 이어서 찾기
- 핵심 질문: 같은 객체가 동영상의 각 프레임에서 어떻게 위치하고 있는가?
- 출력: 시간에 따른 객체의 위치와 이동 경로
- 응용:
- 교통량 분석
- 스포츠 전술 분석
- 매장 동선 분석
- 보안 영상 분석
객체 탐지가 한 프레임의 위치를 찾는다면, 객체 추적은 여러 프레임에서 객체의 동일성을 유지함.
이미지 간 변환
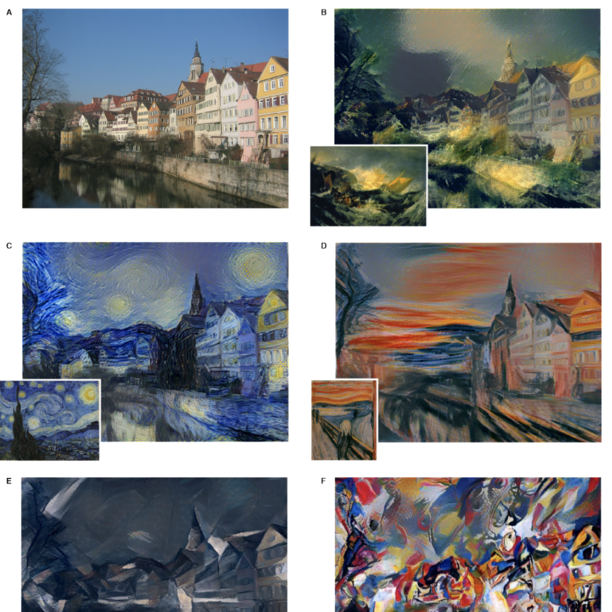
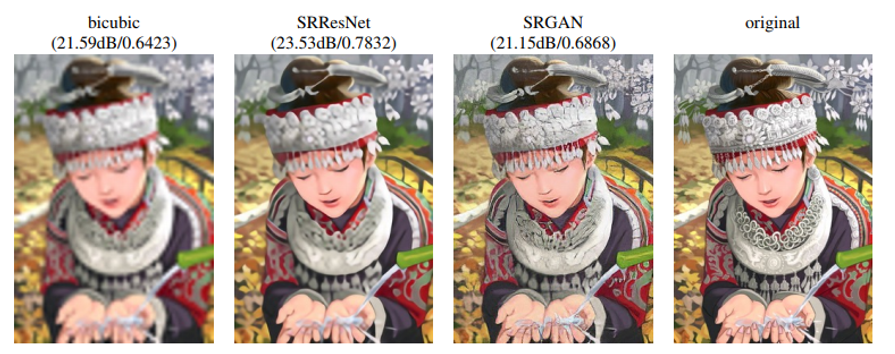
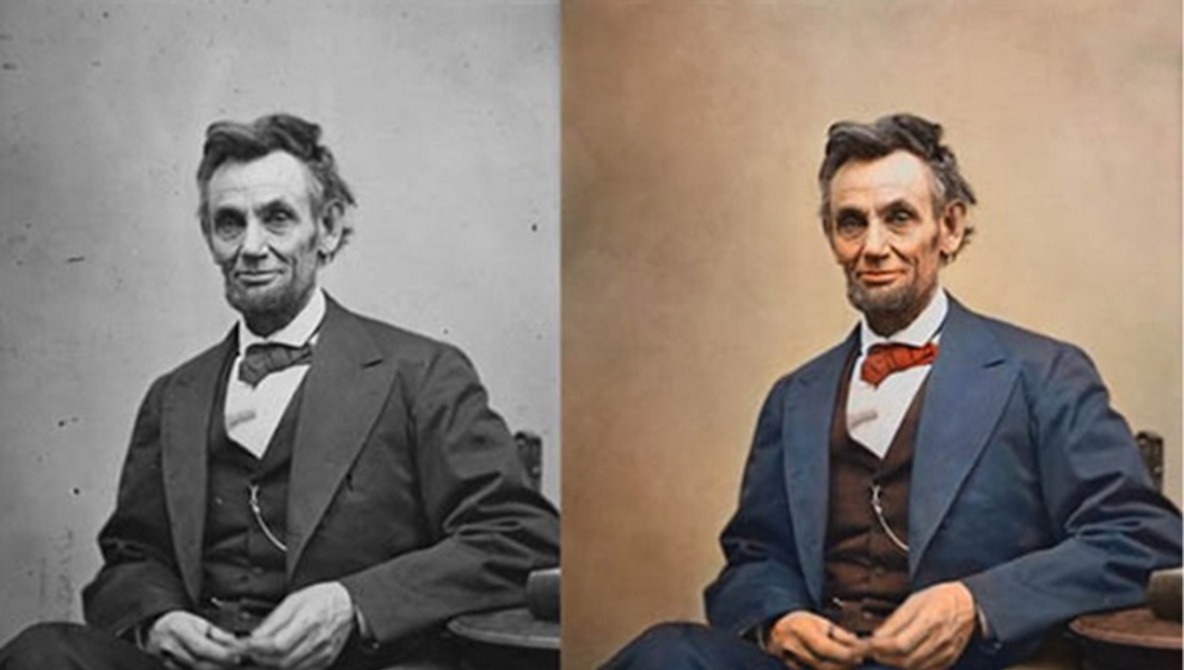
이미지 간 변환(image-to-image translation): 입력 이미지의 구조나 내용을 바탕으로 원하는 속성의 이미지를 출력
- 핵심 질문: 입력 이미지의 어떤 속성을 변환하면 어떻게 되는가?
- 출력: 입력 이미지를 변환한 이미지
- 예시:
- 스타일 변환: 사진을 특정 화풍으로 변환
- 초해상도(super-resolution): 저해상도 이미지를 고해상도로 변환
- 컬러화: 흑백 이미지를 컬러 이미지로 변환
이미지 생성
이미지 생성(image generation): 텍스트 프롬프트, 예시 이미지, 레이아웃 등의 조건을 바탕으로 새로운 이미지를 생성
- 핵심 질문: 사용자가 원하는 이미지를 어떻게 생성할 것인가?
- 출력: 사용자의 입력에 따라 생성한 이미지
- 응용:
- 예술 및 콘텐츠 제작
- 제품 디자인 시안 생성
- 가상 환경과 합성 데이터 생성
- 기존 이미지의 확장과 변형